오픈소스 TTS 보이스클론 5종 비교, 짧은 참조 18초와 긴 참조 30~180초 실측
오픈소스 TTS 5종에 제 음성 18초와 모델별 30~180초 참조를 넣어 보이스클론 결과를 화자 유사도와 STT 오류율로 실측했습니다. 긴 참조가 항상 낫지 않은 이유, Audio8 60초 실패 원인, 참조 음성 준비 요령까지 정리했습니다.
이전 글에서는 한국어 오픈소스 TTS(Text to Speech, 글을 음성으로 바꾸는 기술) 5종의 생성 속도와 VRAM을 비교했고, 보이스클론은 한 편 따로 나올 것 같아 빼두었습니다.
한국어 오픈소스 TTS 모델 5종 비교, RTX 5090에서 직접 측정한 속도와 VRAM
이번 글에서는 그 보이스클론(voice clone, 참조 음성을 주고 같은 사람 목소리로 새 문장을 말하게 하는 것)을 다룹니다. 제 유튜브 영상에서 잘라낸 18초와 180초 음성을 참조로 넣고, Qwen3-TTS(Base), VoxCPM2(2B), Higgs TTS 3(4B), Audio8(0.6B, preview), Fish Audio S2(S2 Pro 오픈소스 가중치)가 같은 새 문장을 얼마나 제 목소리처럼, 그리고 대본대로 읽는지 STT(Speech to Text, 음성을 글로 받아 적기)와 화자 유사도로 확인해 보았습니다. 이번에 당시 실험의 원본 WAV와 파일별 측정 CSV를 함께 연결했습니다. 아래에서 짧은 참조와 긴 참조, 실패한 결과를 직접 들을 수 있습니다.
사용 도구 및 준비물
보이스클론 용어와 복제 방식
TTS 모델에서 목소리를 정하는 방법은 세 가지입니다. preset(모델에 미리 들어 있는 성우)은 녹음실에 와 있는 성우 중 한 명을 고르는 것이고, voice design(조건을 주고 새 목소리를 만드는 기능)은 "차분한 30대 남성" 같은 주문서로 실존하지 않는 성우를 뽑는 것입니다. 이 글의 주제인 zero-shot voice cloning(제로샷 보이스클론)은 제 녹음을 짧게 들려준 뒤 별도 훈련 없이 같은 사람처럼 새 문장을 말하게 하는 방식입니다. "참조 음성 0초"가 아니라 "내 목소리 전용 훈련 0회"라는 뜻이고, 모델에 들어가는 재료는 세 개입니다.
- 참조 음성: 누가 말하는가
- 참조 대본: 그 음성에서 무엇을 말했는가
- 새 문장: 이제 무엇을 말할 것인가
모델이 참조 음성을 "어떻게 듣는지"도 갈립니다.
| 방식 | 비유 | 무엇을 가져오는가 | 준비물 |
|---|---|---|---|
| speaker embedding(화자 임베딩) | 목소리 신분증 | 음색·높낮이 같은 "누구인지" | 참조 음성만 |
| ICL(in-context learning, 인컨텍스트 학습) | 현장 시범을 보고 따라 하기 | 음색에 더해 속도·호흡·억양까지 | 참조 음성 + 정확한 참조 대본 |
| fine-tuning(파인튜닝) | 한 성우 전담 훈련 | 모델 자체를 내 목소리로 다시 학습 | 2~3시간 이상 음성, VRAM 24GB급 GPU |
fine-tuning은 몇 번 해봤지만 한국어를 로컬에서 하는 난이도가 꽤 있어서 이 글에서는 뺍니다. 나머지 두 방식의 설치에는 모델별 가중치와 실행 라이브러리가 필요합니다. 코딩 에이전트의 도움을 받을 수 있지만 환경과 입력 조건은 따로 확인해야 하므로, 이 글은 설치가 아니라 "무엇을 넣으면 무엇이 달라지는지"에 집중합니다.
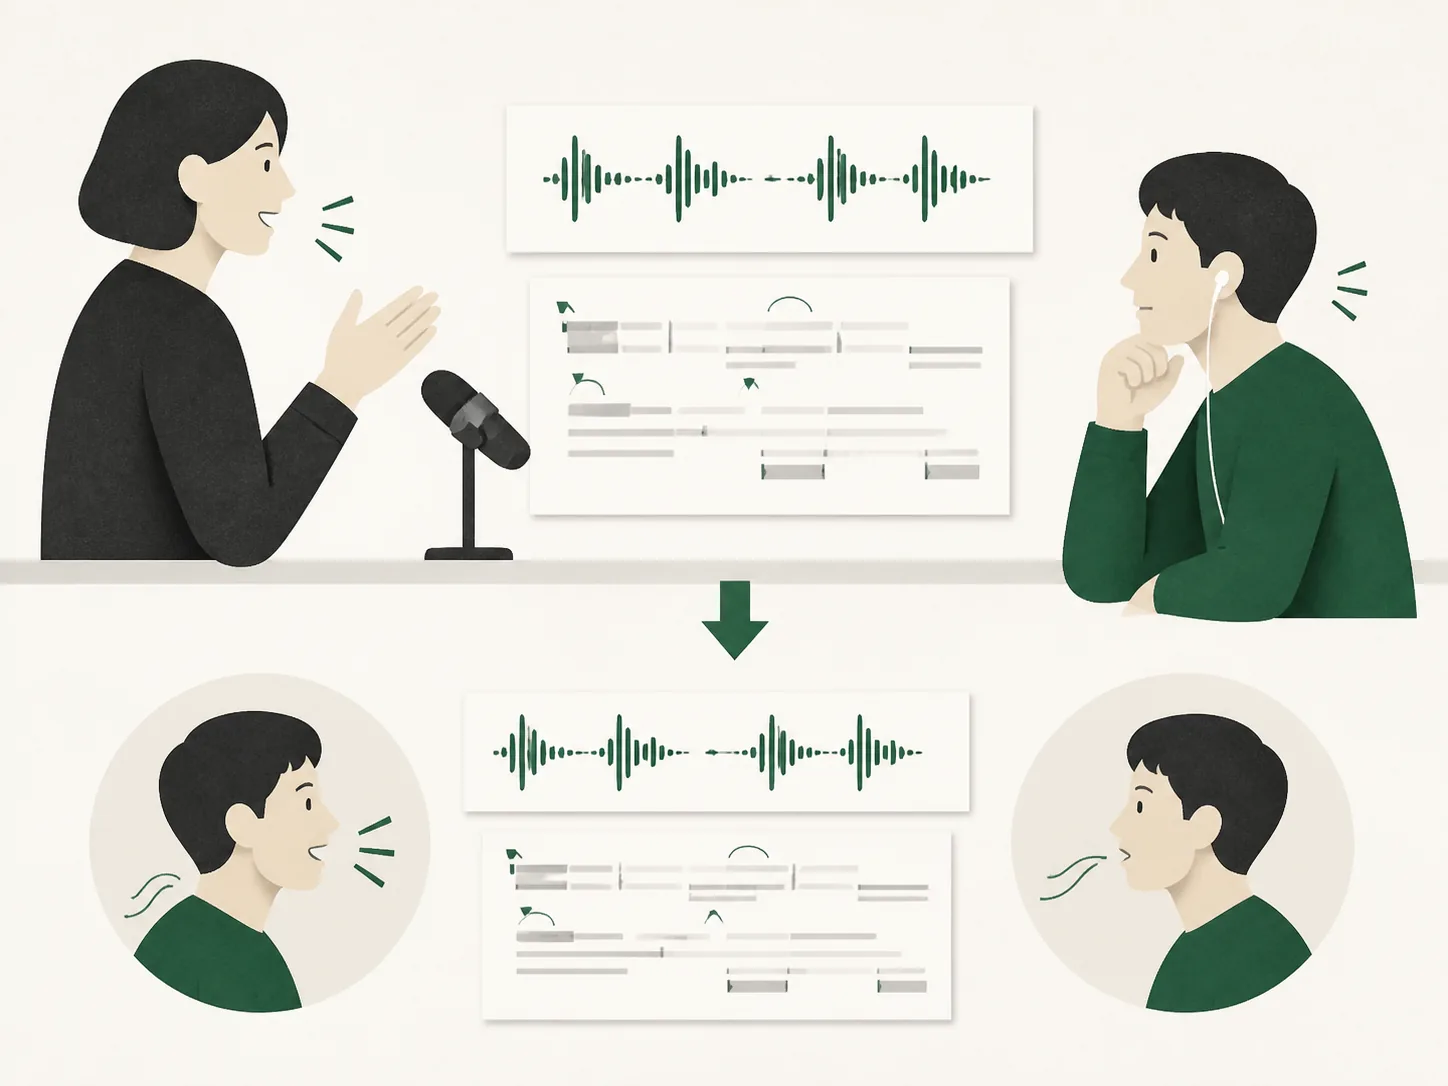
실험 준비와 판정 순서
참조 음성은 제 예전 유튜브 영상 한 편의 06:40부터 18초와 180초를 잘라 24kHz 모노 WAV로 만들었습니다. 같은 녹음의 시작점을 공유하지만, 길이가 늘면서 포함되는 발화와 억양도 달라집니다. 참조 길이만의 효과를 완전히 분리한 실험은 아닙니다. (편집본이라 무음이 제거되어 말이 빠른데, 이게 뒤에서 한 번 영향을 줍니다.)
새 문장은 두 문장으로 고정했습니다.
좋은 보이스클론은 모델보다 데이터에서 시작합니다. 깨끗한 음성, 정확한 대본, 다양한 억양을 준비하면 결과가 훨씬 안정적입니다.
"긴 조건"의 길이는 모델별로 다릅니다. Qwen3-TTS와 VoxCPM2는 180초 그대로, Higgs TTS 3는 공식 실행 코드가 참조 100초 미만을 요구해서 99초, Fish Audio S2는 공식 빠른 복제 범위가 10~30초라 30초, Audio8은 60초입니다. (허용 길이는 작성일 기준 공식 문서 기준입니다.)
판정은 세 단계입니다. 귀로만 판단하면 그날 컨디션에 따라 결론이 바뀌어서 숫자를 먼저 봤습니다.
- STT(openai/whisper-large-v3-turbo)로 받아 적고 원 대본과 비교해 CER(Character Error Rate, 글자 오류율)을 냅니다. 100글자 중 몇 글자가 틀렸는지에 가까운 값입니다.
- 원본과 생성 음성을 각각 화자 벡터로 바꿔 코사인 유사도를 구합니다(영상에서 말한 "Microsoft 음성 임베딩 모델"이 microsoft/wavlm-base-plus-sv입니다). 1에 가까울수록 음색이 비슷하다는 뜻이고 자연스러움은 보지 않습니다.
- 마지막에 제가 직접 듣습니다.
유사도 계산의 핵심을 발췌했습니다. 아래 조각은 import와 실행 인수를 생략한 설명용 코드입니다. 원래 평가 스크립트는 librosa.load(path, sr=16000, mono=True)로 읽어, 24kHz 원본을 WavLM 입력용 16kHz 모노로 변환합니다. 숫자 인수만 바꾸는 것이 아니라 파형을 리샘플링합니다.
MODEL_ID = "microsoft/wavlm-base-plus-sv"
extractor = AutoFeatureExtractor.from_pretrained(MODEL_ID)
model = WavLMForXVector.from_pretrained(MODEL_ID).eval().to(device)

def embedding(waveform):
    inputs = extractor(waveform.numpy(), sampling_rate=16000, return_tensors="pt", padding=True)
    with torch.inference_mode():
        result = model(**{k: v.to(device) for k, v in inputs.items()}).embeddings
    return functional.normalize(result, dim=-1).cpu()

reference = embedding(load_audio(reference_path))        # 제 원본 음성
for path in sorted(root.glob("0[1-9]_*/*.wav")):         # 모델별 생성 음성
    score = functional.cosine_similarity(reference, embedding(load_audio(path))).item()
전체 평가 스크립트는 파일마다 similarity=0.9791 file=... 한 줄씩 찍힙니다. 음원은 참조 5개, 생성 18개로 총 23개이고 STT 전수검사 결과 20개 통과, 3개 검토였습니다. 검토 3개는 전부 Audio8 60초 조건입니다.
측정 조건은 Windows 11, NVIDIA RTX 5090 32GB, 측정일 2026-08-31, 조건당 생성 1회입니다. 참고로 참조 원본도 STT를 돌려보니 18초 원본은 CER 5.3%, 180초 원본은 1.6%였습니다. 원본에도 STT 오류가 있으므로 생성 음성의 CER에는 받아쓰기 오류가 섞일 수 있습니다. 그렇다고 3~5%를 전부 STT 편차로 처리할 수는 없습니다. 해당 구간을 직접 들어 실제 오독인지 확인해야 합니다.
당시 음원과 평가 기록 직접 확인하기
아래는 당시 생성한 원본 WAV입니다. 배속·음량 보정을 새로 적용하지 않았습니다. 플레이어 위의 파일 링크로 원본을 내려받을 수 있습니다. 생성 결과의 대본은 위의 “좋은 보이스클론은…” 두 문장입니다.
Qwen3-TTS — 180초 참조·ICL 결과 WAV
VoxCPM2 — 18초 참조·reference 결과 WAV
Fish Audio S2 Pro — 30초 참조 결과 WAV
Higgs 음성 표기: This audio was created with Boson AI's Higgs Audio — Boson AI.
23개 파일의 STT·CER 기록, 생성 설정과 소요 시간, 화자 유사도 CSV, Audio8 컨텍스트 진단 기록을 함께 공개합니다. 나머지 음원을 포함한 전체 파일 경로와 해시는 자료 안내와 음원 목록에 있습니다.
CSV의 CER는 비율입니다. 0.052632는 약 5.3%입니다. 당시 생성 음성의 자동 판정은 CER 20% 이하이면서 핵심 구문 6개 중 5개 이상 포함일 때 pass였습니다. 따라서 표의 ‘STT 통과’는 발음이 완벽하다는 뜻이 아닙니다. 참조 음성은 CER 20% 이하를 기준으로 분류했고, 긴 참조의 정답 대본은 기존 Whisper 전사에서 가져와 사람의 독립 정답 전사와도 구분해야 합니다.
배포용 유사도 평가 코드는 원래 계산과 16kHz 변환을 보존했습니다. 다만 당시 실행 인수에서 어느 참조 파일을 유사도 기준으로 선택했는지 기록을 확인하지 못했습니다. 기존 CSV는 그대로 공개하며, 재실행할 때는 기준 WAV를 명시하고 별도 결과로 저장해야 합니다. 이번 자료 연결은 새 추론이나 원래 유사도 수치의 완전 재현 검증이 아닙니다.
복제 방식과 참조 길이에 따른 유사도
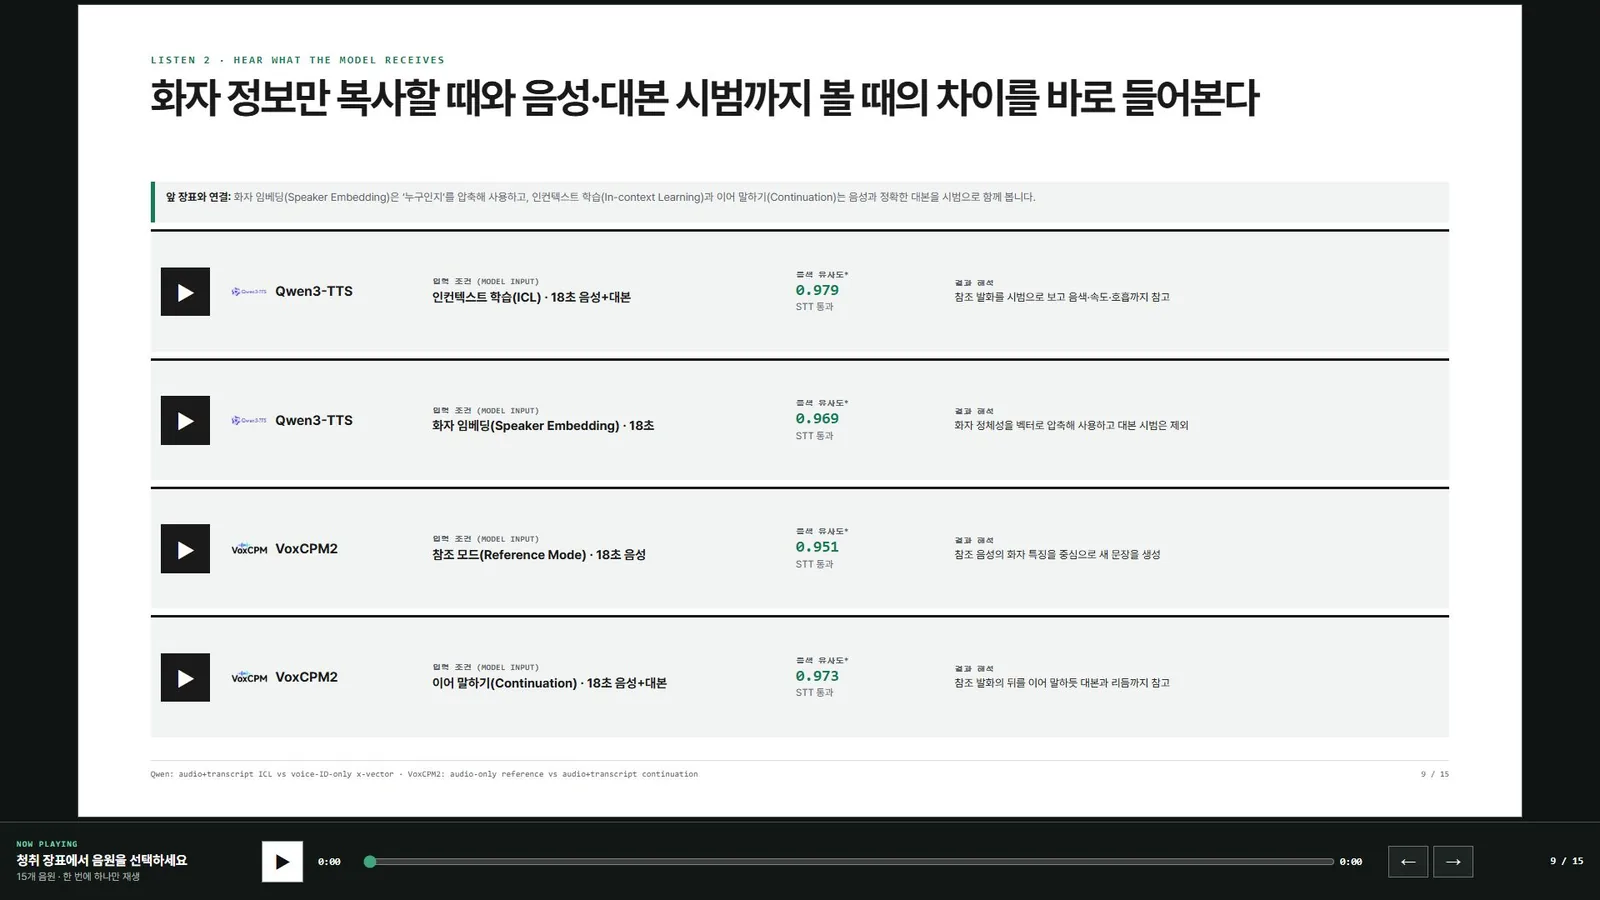
먼저 같은 18초 참조로 복제 방식만 바꿔봤습니다. Qwen3-TTS는 speaker embedding과 ICL 둘 다 지원하고, VoxCPM2는 음성만 넣는 reference 모드와 대본까지 붙여 뒤를 이어 말하는 continuation(이어 말하기) 모드가 있습니다.
| 모델 | 입력 | CER | 화자 유사도 |
|---|---|---|---|
| Qwen3-TTS | ICL, 18초 음성 + 대본 | 0.0% | 0.979 |
| Qwen3-TTS | speaker embedding, 18초 음성만 | 0.0% | 0.969 |
| VoxCPM2 | reference, 18초 음성만 | 0.0% | 0.951 |
| VoxCPM2 | continuation, 18초 음성 + 대본 | 0.0% | 0.973 |
네 조건 모두 대본은 정확히 읽었고, 두 모델 다 대본을 함께 준 쪽이 유사도가 0.01~0.02 높았습니다. Qwen3-TTS의 speaker embedding은 영상에서 들었을 때도 제 목소리 같지가 않았는데 숫자도 같은 방향이었습니다. 그래서 저는 어떤 모델이든 참조 음성과 참조 대본을 같이 넣는 ICL 계열을 기본값으로 잡는 편입니다. VoxCPM2 continuation은 참조의 빠른 말투까지 따라왔는데, 대본까지 보는 방식은 음색만이 아니라 말버릇까지 가져온다는 뜻입니다.
같은 18초 참조에서 방식만 바꾼 결과도 들어볼 수 있게 붙입니다. 바로 위 "당시 음원" 목록의 Qwen3-TTS ICL·VoxCPM2 reference와 짝을 지어 들으시면 됩니다. 괄호 안 숫자는 공개한 similarity.csv의 화자 유사도입니다.
Qwen3-TTS — 18초 참조·speaker embedding(음성만) 결과 WAV (0.969)
VoxCPM2 — 18초 참조·continuation(음성+대본) 결과 WAV (0.973)
Higgs TTS 3 — 18초 참조·음성만 결과 WAV (0.971)
Fish Audio S2 — 18초 참조·whispers 프리셋 결과 WAV (0.971)
Audio8 — 18초 참조·temperature 0.2 결과 WAV (0.980)
다음은 본론인 참조 길이입니다. 영상을 찍기 전까지는 저도 길게 넣을수록 좋겠거니 했습니다.
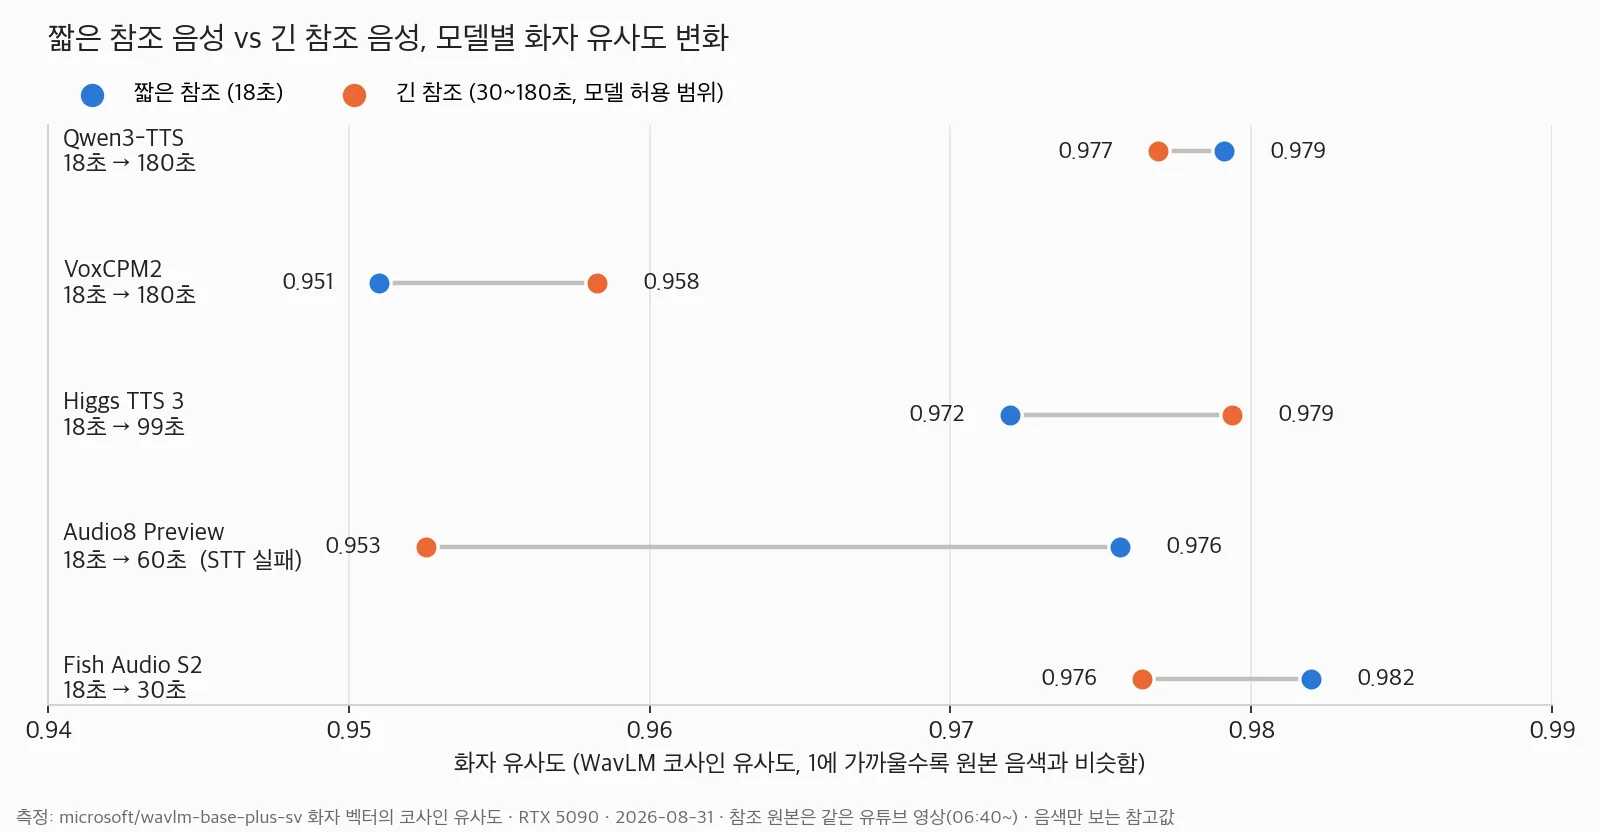
| 모델 | 짧은 참조 | 긴 조건 | STT | 화자 유사도 | 읽는 법 |
|---|---|---|---|---|---|
| Qwen3-TTS | 18초, 음성+대본 | 180초, 음성+대본 | 둘 다 통과 | 0.979 → 0.977 | 길이보다 방식 영향이 큼 |
| VoxCPM2 | 18초, 음성만 | 180초, 음성만 | 둘 다 통과 | 0.951 → 0.958 | 긴 조건에서 소폭 상승 |
| Higgs TTS 3 | 18초, 음성+대본 | 99초, 음성+대본 | 둘 다 통과 | 0.972 → 0.979 | 대본 포함 시 안정 |
| Audio8 Preview | 18초, 음성+대본 | 60초, 음성+대본 | 긴 조건 실패 | 0.976 → 0.953 | 긴 참조는 먼저 검증 |
| Fish Audio S2 | 18초, 음성+대본 | 30초, 음성+대본 | 둘 다 통과 | 0.982 → 0.976 | 짧고 정확한 참조가 강점 |
숫자만 보면 긴 참조가 유사도를 올린 것은 VoxCPM2와 Higgs TTS 3 둘뿐이고 그것도 0.007 안팎입니다. Qwen3-TTS와 Fish Audio S2는 오히려 조금 내려갔고 Audio8은 내용 자체가 무너졌습니다. 0.95와 0.98의 차이는 체감으로는 "둘 다 제 목소리인데 어느 쪽이 더 닮았는지는 듣는 사람마다 갈리는" 정도라, 유사도는 반은 믿고 반은 거르는 참고값으로 쓰시는 게 맞는 것 같습니다.
정성적으로는 조금 다릅니다. 저는 두 모델 다 180초 쪽이 듣기에 편했고, VoxCPM2 reference 모드는 유사도가 가장 낮은데 제 음역대에는 가장 가깝게 들렸습니다. 숫자와 귀가 다른 말을 하는 구간이 있어서 직접 청취는 뺄 수가 없습니다.
표의 짧은 참조·긴 참조 짝 중 위 목록에 없던 쪽도 붙입니다. 같은 모델의 두 파일을 연달아 들으면 숫자로는 0.007 차이인 구간이 귀로는 어떻게 들리는지 바로 비교할 수 있습니다.
VoxCPM2 — 180초 참조·reference 결과 WAV (0.958)
Higgs TTS 3 — 18초 참조 결과 WAV (0.972)
Fish Audio S2 — 18초 참조 결과 WAV (0.982)
Audio8 60초 실패 사례
이번 실험에서 제일 얻을 게 많았던 구간입니다. Audio8은 18초 참조에서는 CER 0%, 유사도 0.976으로 멀쩡했는데 참조를 60초로 늘리자 새 문장이 무너졌습니다. STT 결과 원문을 그대로 붙입니다.
원 대본: 좋은 보이스클론은 모델보다 데이터에서 시작합니다. 깨끗한 음성, 정확한 대본, 다양한 억양을 준비하면 결과가 훨씬 안정적입니다.
60초, temperature 0.8: 세비염 손 툴툴툴 계속 엔컬더를 파팜스 엔티 다리 띠아풀카아풀카아 (CER 98.1%)
60초, temperature 0.8, 같은 seed 재실행: 스밀 계획을 이의에 대해 (CER 92.5%)
60초, temperature 0.2: 습니다. (CER 96.2%)
같은 대본을 읽은 다섯 결과의 파형을 한 시간축에 세워 보면 실패가 어떤 모양인지 보입니다. 공개한 WAV 파일을 그대로 읽어 그린 그림입니다.
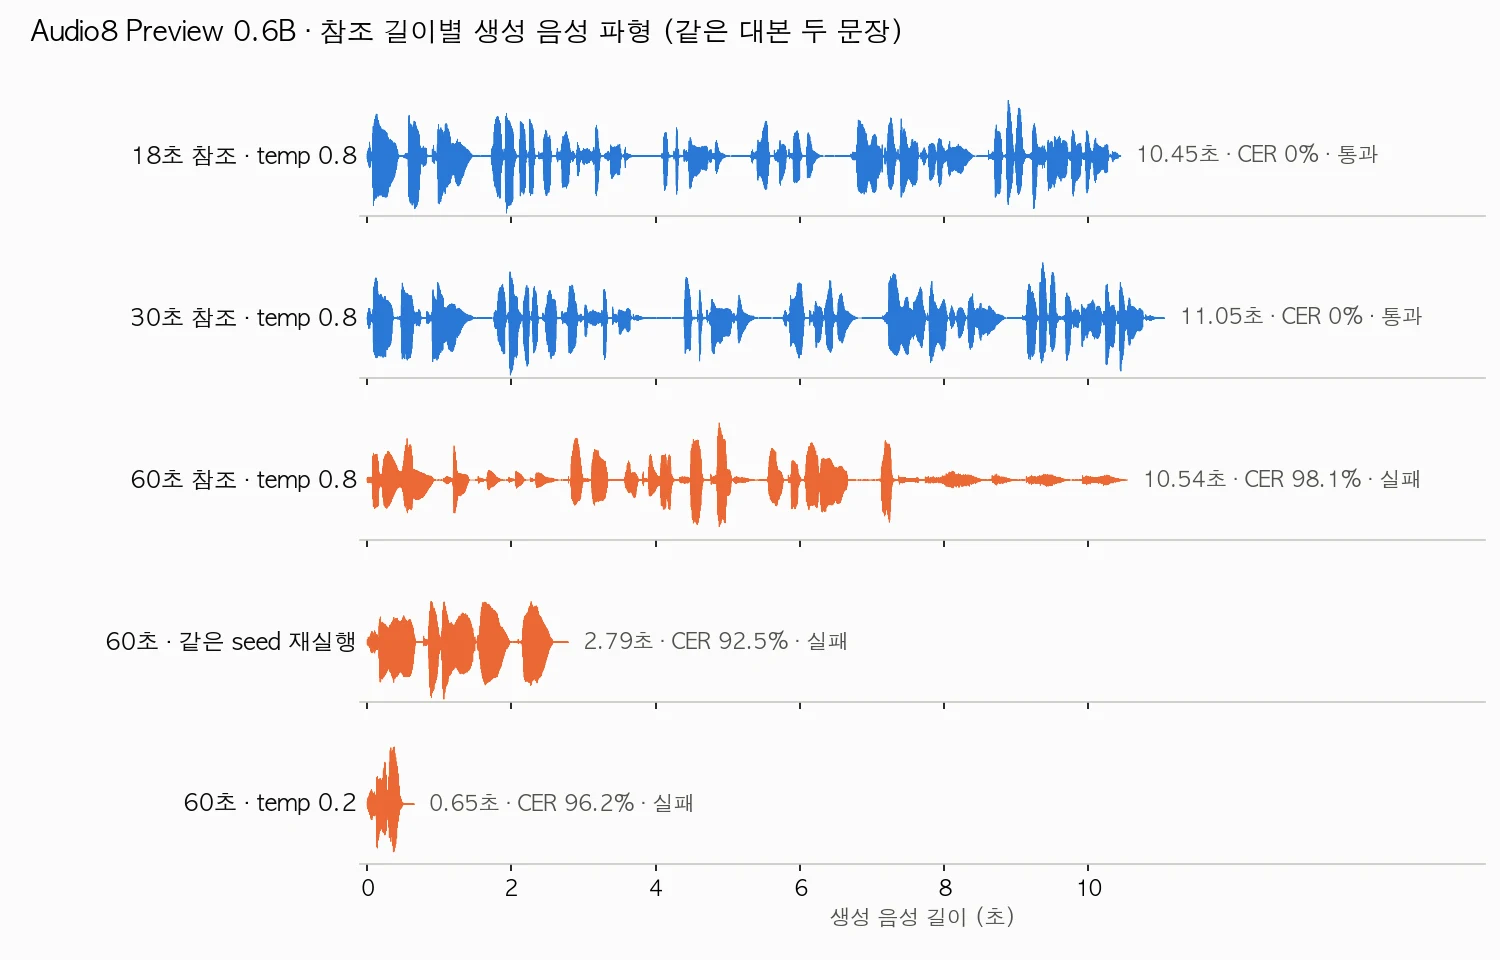
18초와 30초 참조(파란색)는 두 문장을 10~11초 동안 고르게 말합니다. 60초 첫 실패(주황색)는 길이는 10.5초로 비슷한데 7초 이후로는 진폭이 작은 소리만 이어지고, 같은 seed 재실행은 2.79초, temperature 0.2는 0.65초 만에 끝납니다. 세 실패 음원도 직접 들어볼 수 있습니다.
Audio8 — 60초 참조·같은 seed 재실행 결과 WAV (2.79초, CER 92.5%)
Audio8 — 60초 참조·temperature 0.2 결과 WAV (0.65초, CER 96.2%)
Audio8 — 30초로 줄여 회복한 결과 WAV (11.05초, CER 0%)
세 번 다 실패했는데 첫 실패 파일의 화자 유사도는 0.953으로 여전히 높았습니다(같은 seed 재실행 0.937, temperature 0.2는 0.616까지 떨어졌습니다). 음색은 제 목소리인데 말은 외계어를 하는 상태입니다. 실패한 파일은 지우지 않고 남겨두었습니다. 잘 나온 것만 보여주면 어디서 깨지는지 알 수 없기 때문입니다.
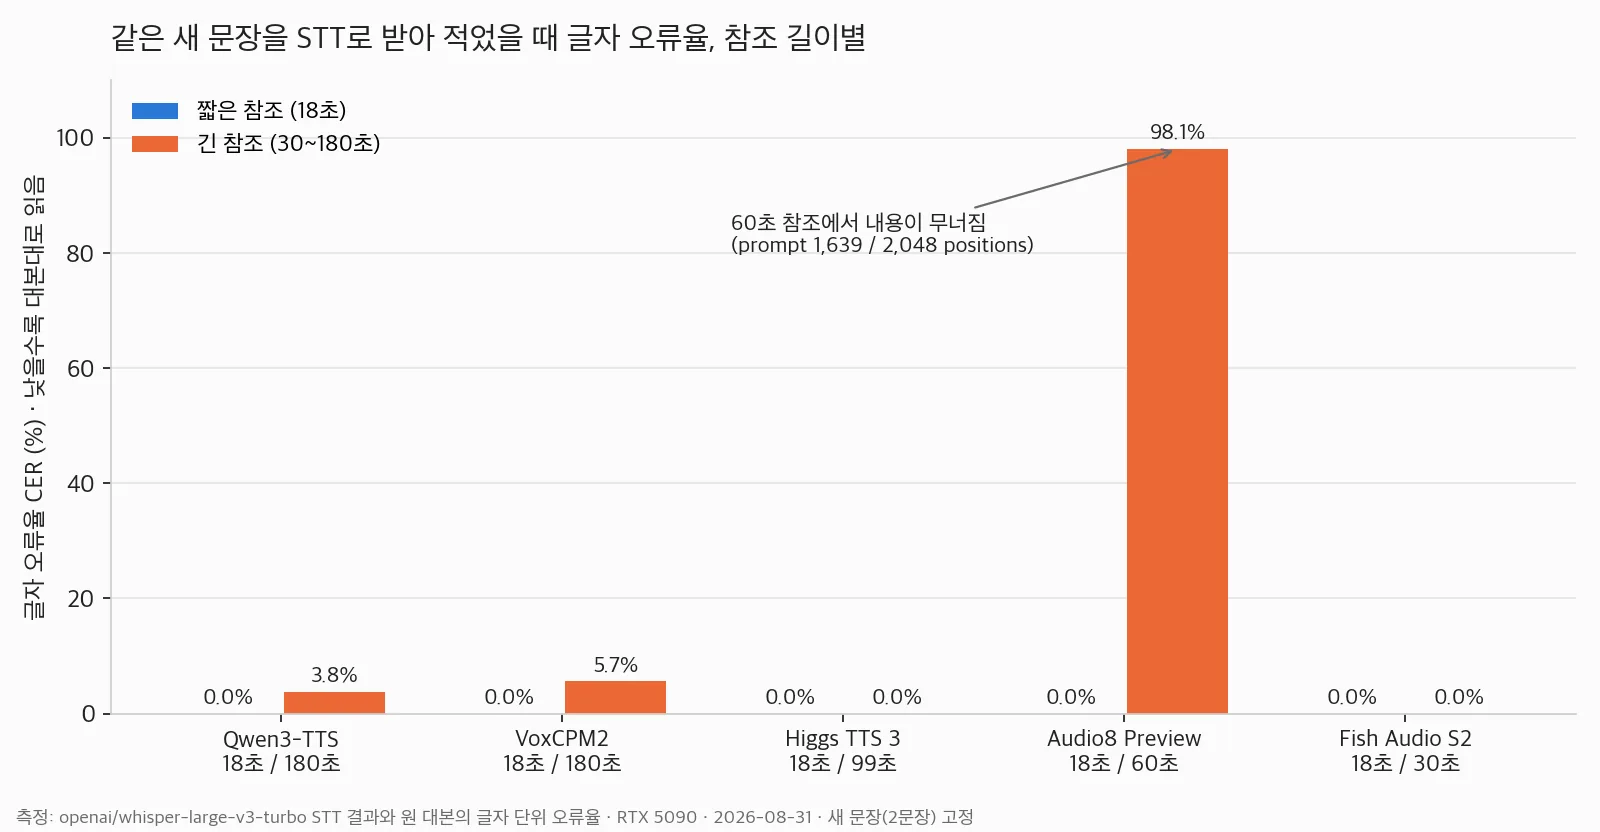
원인을 좀 더 파봤습니다. seed를 고정해 다시 돌리고 temperature(생성 무작위성)를 0.2까지 내려도 셋 다 실패해 한 번의 우연한 생성 실패만으로 설명하기는 어려웠습니다. 다만 무작위성의 영향을 완전히 배제한 것은 아닙니다. 참조를 30초로 줄이니 같은 설정에서 CER 0%로 돌아왔습니다. 로그를 보니 Audio8 Preview는 한 번에 볼 수 있는 자리가 2,048칸(context length)인데 60초 참조가 1,639칸을 차지해 새 문장을 만들 자리가 409칸밖에 남지 않았습니다(30초 참조는 848칸). 칸이 정해진 메모장을 참조로 다 채워버린 셈이라, 이번 입력에서는 긴 참조로 컨텍스트 여유가 줄어든 것을 유력한 원인으로 봤습니다. 다른 변수까지 통제해 원인을 확정한 실험은 아니며, 이 결과를 Audio8의 한국어 전체 성능으로 확대하지 않습니다. (생성 시간이 30초 조건 13.9초, 60초 실패 3.1초와 0.9초였던 것도 힌트였습니다.)
공개한 진단 기록(audio8-diagnostics.json)의 숫자를 그대로 막대로 옮기면 다음과 같습니다.
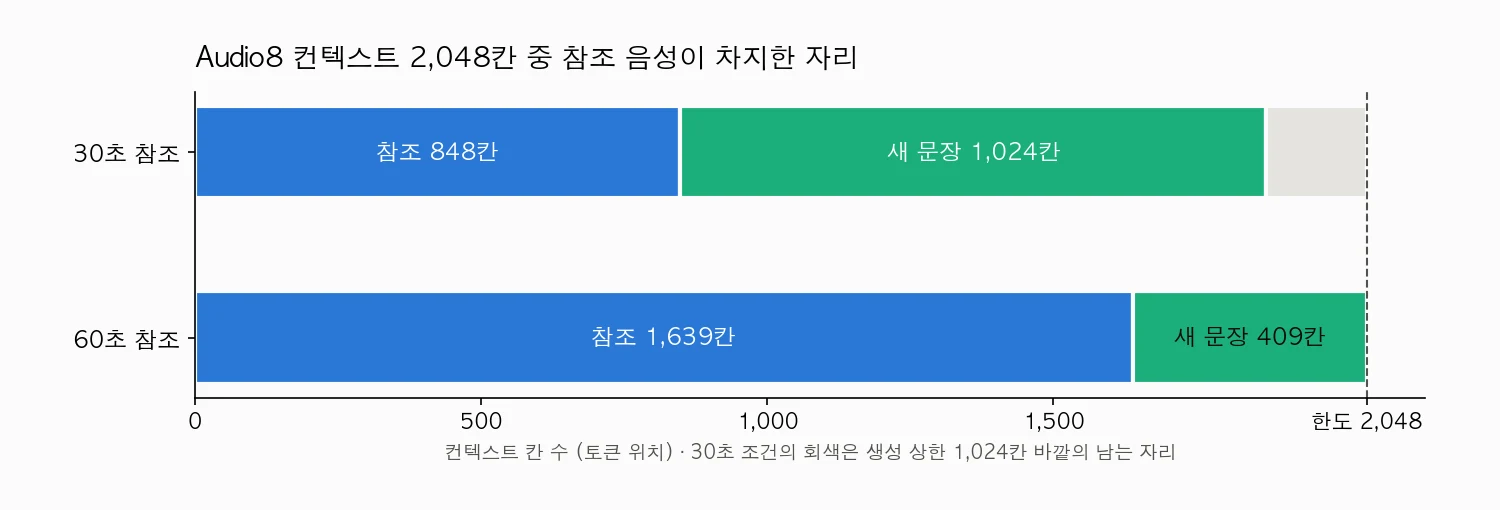
30초 참조는 새 문장에 1,024칸(기록상 생성 가능 자리)을 쓸 수 있었지만, 60초 참조는 409칸만 남았습니다. 다만 이 그림은 자리 배분을 보여줄 뿐이고, 원인을 확정하는 실험은 아닙니다.
여기서 나온 규칙은 하나입니다. 원본은 3분 이상 보관하되 모델에 넣는 참조는 허용 길이로 잘라 넣고 STT를 먼저 통과시킨 뒤에 듣습니다. Audio8 Preview 기준으로는 정확한 대본이 붙은 깨끗한 30초 이하가 안전선이었습니다. (작성일 기준 preview checkpoint 결과이고 다음 버전에서는 달라질 수 있습니다.)
참조 음성 준비 요령
영상 제목의 "꿀팁"에 해당합니다. 대부분 제 경험이고 모델에 따라 다를 수 있습니다.
1. 녹음 환경 - 조용한 방, 고정된 마이크, 같은 거리와 볼륨. 편집본의 빠른 말투가 그대로 따라온 것처럼 참조에 들어간 건 잡음이든 말버릇이든 결과에 남습니다.
2. 참조 대본 - 자동화하려는 텍스트와 비슷한 단어가 섞인 대본을 카테고리별로 여러 개 만들어 두시는 편이 실용적입니다. 평소 말투용, 이름·날짜·금액용을 따로 둡니다. 숫자·명령어 처리는 대본 전처리 실습 글에서 코드로 다뤘습니다.
3. 감정 분기 - 감정 연기까지 자동화하실 거라면 분노, 슬픔 같은 감정은 별도로 녹음하고 감정별로 다른 참조 음성을 쓰도록 파이프라인에 분기를 둡니다. 내레이션 형태라면 솔직히 어느 모델을 쓰셔도 큰 차이가 없습니다.
4. 사람이 고른 합성 데이터 - 잡기술에 가깝지만 효과를 봤던 방법입니다. 모델이 만든 클론 결과 10개 중 제 귀에 100점인 7개만 골라 다시 참조 음성으로 씁니다. AI가 출력한 음성은 대부분 일관성이 있어서 꽤 안정적입니다. 단, 합성만 반복하면 발음 오류나 금속성 잡음도 증폭될 수 있으니 사람 원본을 기준으로 남겨두고 합성은 보조로만 쓰시는 편이 안전합니다.
개인적인 생각 & 한계점
한계부터 적습니다. 이번 비교는 제 목소리 하나, 참조 원본 하나, 조건당 생성 1회 기준이라 다른 목소리로 바꾸면 순위가 바뀔 수 있고, 유사도 모델도 음색만 볼 뿐 자연스러움과 발음 정확도는 재지 못합니다. Fish Audio S2는 이전 글의 5종에 없던 모델이라 속도·VRAM·라이선스는 확인하지 못했습니다. 영상에서 Higgs TTS 3와 비슷한 크기라고 말했는데 정확한 파라미터 수와 라이선스는 작성일 기준 공식 문서에서 다시 확인하셔야 하고, 최신 S2.1은 API로만 제공되고 오픈소스가 아닌 것으로 알고 있습니다(작성일 기준). Supertonic 3는 고정 preset 중심이라 같은 참조로 비교할 수 없어 뺐습니다.
그 위에서 제 취향을 적으면 같은 3분 원본에서 모델별 허용 길이로 잘라 넣은 이번 조건의 개인적인 원픽은 Fish Audio S2 Pro, 그다음이 Higgs TTS 3, Qwen3-TTS, VoxCPM2 순이고 Audio8은 18초에서도 말이 어눌해서 탈락입니다.
상황별로 나누면 이렇습니다.
- 내 브랜드가 걸린 목소리라 실패 비용이 큰 경우: 오픈소스보다 ElevenLabs(유료 보이스클론 서비스) 같은 곳에 먼저 돈을 내는 쪽을 권합니다. 저도 예전에 8시간짜리 음성으로 professional voice cloning을 만들어 쓴 적이 있습니다.
- 돈은 죽어도 못 내겠고 내레이션 위주인 경우: 위 네 모델 중 본인 PC가 감당하는 것을 고르고 3~5분 녹음해 Claude Code나 Codex에 이 글과 함께 넘기면 됩니다.
- 여러 모델을 돌려도 만족이 안 되는 경우: 사람이 고른 합성 데이터로 참조를 다시 만들어 보시고, 그래도 안 되면 그때 fine-tuning입니다. VoxCPM2가 LoRA(모델 일부만 가볍게 추가 학습하는 방식) fine-tuning을 지원하고 데이터셋 만드는 것도 Claude Code에 맡길 수 있습니다. 공식 지원 언어는 영어·중국어 위주지만 다른 언어로 굴리고 있다는 GitHub 이슈를 본 적이 있어 여지는 있는 것 같습니다.
결국 정할 것은 어떤 환경에서 어떤 대본으로 참조 음성을 녹음할지, 그리고 클론한 목소리를 어느 콘텐츠에 굴릴지 두 가지이고 모델 선택은 그다음입니다. 이번 결과는 제 목소리와 이 대본에서 참조 준비가 중요하다는 판단을 뒷받침했습니다. 모델보다 데이터가 언제나 더 중요하다고 증명한 비교는 아닙니다.
이 글을 마치며 & Reference
다음 글에는 이번에 미룬 fine-tuning, 그중 VoxCPM2 LoRA 학습용 데이터셋을 제 녹음으로 만들어 보는 과정을 다뤄보려고 합니다.
Reference
- Qwen3-TTS : speaker embedding과 ICL 두 방식의 추론 코드.
- VoxCPM : reference·continuation 모드와 LoRA 문서. 다음 글의 출발점입니다.
- Higgs TTS 3 : 참조 100초 미만 제한과 Creator Use Grant 표기 의무.
- Audio8 TTS : 60초 실패의 근거가 된 max_seq_len 처리.
- Fish Audio : S2 Pro 가중치와 S2.1 API의 구분은 작성일 기준으로 다시 확인하시길 권합니다.
긴 글 읽어주셔서 감사합니다 :)
추가 학습 자료 신청
ZEXEA 메인 사이트의 자료 신청 페이지로 이동합니다. 이름·이메일·전화번호 등의 입력이 필요합니다. 블로그 글과 실습 예제는 신청 없이 모두 읽을 수 있습니다.
관련 가이드
한국어 오픈소스 TTS 모델 5종 비교, RTX 5090에서 직접 측정한 속도와 VRAM
한국어 오픈소스 TTS 모델 5종을 같은 대사로 직접 생성해 비교했습니다. RTX 5090에서 측정한 생성 속도와 VRAM, 숫자·터미널 명령어 오독 문제, 장비와 목적에 따른 선택 기준, Apache-2.0과 OpenRAIL-M 라이선스 차이까지 정리했습니다.
전체 과정 보기
한국어 TTS 대본 전처리 실습: 원문을 보존하고 발음용 대본 따로 만들기
API·버전·시간·금액을 명시적인 발음 사전으로 바꾸는 파이썬 코드와 10문장 실행 결과를 제공합니다. 식별자 오변환을 막고 미등록 숫자·명령어를 검토 대상으로 남기는 방법을 다룹니다.
전체 과정 보기
Higgsfield API로 밈 영상 자동화하기, Genjutsu로 6편 만들어 본 과정과 한 편 비용
Higgsfield API와 Genjutsu로 레퍼런스 밈 영상에 제 사진을 넣어 새 밈을 자동으로 만든 과정을 정리했습니다. API 키 연결, 작업 폴더 구조, 검열 실패 사례, 최종 6편의 실제 비용표까지 담았습니다.
전체 과정 보기