한국어 오픈소스 TTS 모델 5종 비교, RTX 5090에서 직접 측정한 속도와 VRAM
한국어 오픈소스 TTS 모델 5종을 같은 대사로 직접 생성해 비교했습니다. RTX 5090에서 측정한 생성 속도와 VRAM, 숫자·터미널 명령어 오독 문제, 장비와 목적에 따른 선택 기준, Apache-2.0과 OpenRAIL-M 라이선스 차이까지 정리했습니다.
1인 콘텐츠 자동화 로드맵에서 다룬 파이프라인을 실제로 돌리다 보면 목소리에서 막히게 됩니다. 대본은 언어 모델이 작성하고 자막과 편집은 코드로 붙일 수 있지만, 생성된 음성이 쓸 만한지는 직접 들어봐야 알 수 있기 때문입니다. 올해 공개된 한국어 지원 오픈소스 TTS(Text to Speech, 문자를 음성으로 바꾸는 기술) 모델을 9종 정도 내려받아 실행해 봤습니다. 그중 실사용 후보로 남길 만한 5종을 추렸습니다.
이번 글에서는 이 5종에 같은 대사를 넣어 비교한 결과를 정리합니다. 설치 튜토리얼은 아닙니다. 공식 GitHub repository를 클론한 뒤 Codex나 Claude Code에 실행을 맡기면 설치 자체는 대체로 해결됩니다. 시간이 더 걸린 작업은 생성된 음성을 직접 듣고 판단하는 일이었습니다. 따라서 모델의 순위를 매기기보다 내 콘텐츠와 장비에 맞는 목소리를 고르는 데 기준을 맞췄습니다.
사용 도구 및 준비물
비교 모델 5종과 실측 조건
먼저 비교 조건부터 정리해 보겠습니다. 생성 시간과 메모리는 벤치마크 공표값이 아니라 제 PC에서 직접 측정한 값입니다.
| 모델 | 크기 | 지원 언어 | 출력 | 60초 음성 환산 시간(중앙 RTF × 60) | 최대 메모리(실측) | 라이선스 |
|---|---|---|---|---|---|---|
| Qwen3-TTS 1.7B CustomVoice | 1.7B | 10개 | 24kHz | 약 101초 | VRAM 4.592GB | Apache-2.0 |
| VoxCPM2 | 2B | 30개 | 48kHz | 약 42초 | VRAM 5.647GB | Apache-2.0 |
| Higgs TTS 3 4B | 4B | 100개 이상 | 24kHz | 약 15초 | VRAM 26.778GB | Research and Non-Commercial + Creator Use Grant |
| Supertonic 3 | 약 99M | 31개 | 44.1kHz | 약 7초 | CPU RAM 1.297GB | 가중치 OpenRAIL-M / 코드 MIT |
| Audio8 TTS Preview 0.6B | 0.6B (코덱 제외) | 권장 11개 | 44.1kHz | 약 68초 | VRAM 3.175GB | Apache-2.0 |
측정 환경: Windows 11 / 일부 WSL2 / NVIDIA RTX 5090 32GB / batch 1. Supertonic 3는 ONNX CPU 실행입니다. 원래 실험의 기록을 2026-09-16에 재집계했으며 새 음성을 생성하지 않았습니다. 표의 시간은 각 샘플의
생성 시간 ÷ 원본 음성 길이인 RTF 중앙값을 60배 한 환산값입니다. 정확히 60초인 동일 대본을 반복 생성한 평균이 아닙니다.
재집계에 사용한 샘플 수는 Qwen·VoxCPM2·Higgs 각 15개, Supertonic·Audio8 각 11개입니다. 대본·언어·보이스가 섞인 기술 통계이므로 엄밀한 동일 조건 속도 순위로 읽으면 안 됩니다. 모델 로딩 시간은 별도 필드이며 생성 시간에 더하지 않았습니다. CPU 모델과 실제 스레드 수는 당시 기록에 없어 현재 PC 정보로 대신 채우지 않았습니다.
메모리 측정법도 다릅니다. 대부분의 GPU 값은 PyTorch peak allocation이고, Higgs는 별도 서버의 nvidia-smi 사용량에서 서버 시작 전 기준값을 뺀 관측치입니다. Supertonic RAM은 생성 후 프로세스 RSS 관측값입니다. 같은 메모리 측정 도구로 통일한 벤치마크가 아닙니다.
정정: 이전 글의 Qwen 약 107초·4.593GB는 당시 정리표 값이었습니다. 현재 보관된 실행 로그를 같은 집계 규칙으로 계산하면 중앙 RTF 1.691, 약 101초·4.592GB입니다. 이전 표본 스냅샷을 복원하지 못해 차이의 원인을 확정하지 않았으며, 이 글은 아래에서 직접 확인할 수 있는 로그 기준으로 표를 갱신했습니다. 나머지 모델의 환산 시간은 기존 표와 같습니다.
실행별 측정 CSV, 집계 JSON, 집계 코드, 당시 생성 제어 설정, 자료 안내를 공개합니다. CSV에는 가중치·저장소 revision, seed, 음성 길이, 로딩·생성 시간과 실행 환경이 남아 있습니다. 같은 폴더에 CSV·JSON·코드를 저장하고 python summarize.py를 실행하면 공개 집계와 일치하는지 검사합니다.
이 글을 다시 정리하면서 공개된 파일만 내려받아 실제로 돌려봤습니다(2026-10-02, macOS, Python 3.13.3). 검사가 통과하면 아래 집계가 그대로 출력되고, 하나라도 다르면 Snapshot does not match 에러로 멈춥니다. 앞부분만 붙입니다.
$ python summarize.py
[
  {
    "model": "qwen3_tts",
    "samples": 15,
    "median_rtf": 1.691,
    "seconds_per_60s_equivalent": 101.46,
    "peak_vram_gb": 4.592
  },
  {
    "model": "supertonic3",
    "samples": 11,
    "median_rtf": 0.116,
    "seconds_per_60s_equivalent": 6.96,
    "peak_vram_gb": 0.0
  },
  ...
]
각 모델의 공식 저장소는 아래에 붙여 둡니다. 스펙과 라이선스는 발행 시점에 한 번 더 확인하시는 편이 안전합니다.
- Qwen3-TTS: GitHub · QwenLM/Qwen3-TTS · Hugging Face · Qwen3-TTS 1.7B CustomVoice
- VoxCPM2: GitHub · OpenBMB/VoxCPM · Hugging Face · OpenBMB/VoxCPM2
- Higgs TTS 3: Hugging Face · bosonai/higgs-tts-3-4b · GitHub · sglang-omni
- Supertonic 3: GitHub · supertone-inc/supertonic · Hugging Face · Supertone/supertonic-3
- Audio8: GitHub · Audio8-AI/Audio8_TTS · Hugging Face · Audio8 TTS Preview 0.6B
측정 결과, 파라미터 크기와 실제 생성 속도는 비례하지 않았습니다. 4B인 Higgs TTS 3가 1.7B인 Qwen3-TTS보다 일곱 배 빨랐습니다. 대신 VRAM을 26.778GB까지 사용했습니다. 제 측정 기본 설정에서는 사실상 32GB급 GPU가 필요한 수치입니다. 따라서 생성 속도만으로 모델을 고르기는 어렵습니다.
이전 집계로 만든 산점도는 수치 혼선을 피하기 위해 본문에서 제외했습니다. 대신 공개한 runs.csv 67행만으로 실행 한 번 한 번을 점으로 다시 그렸습니다.
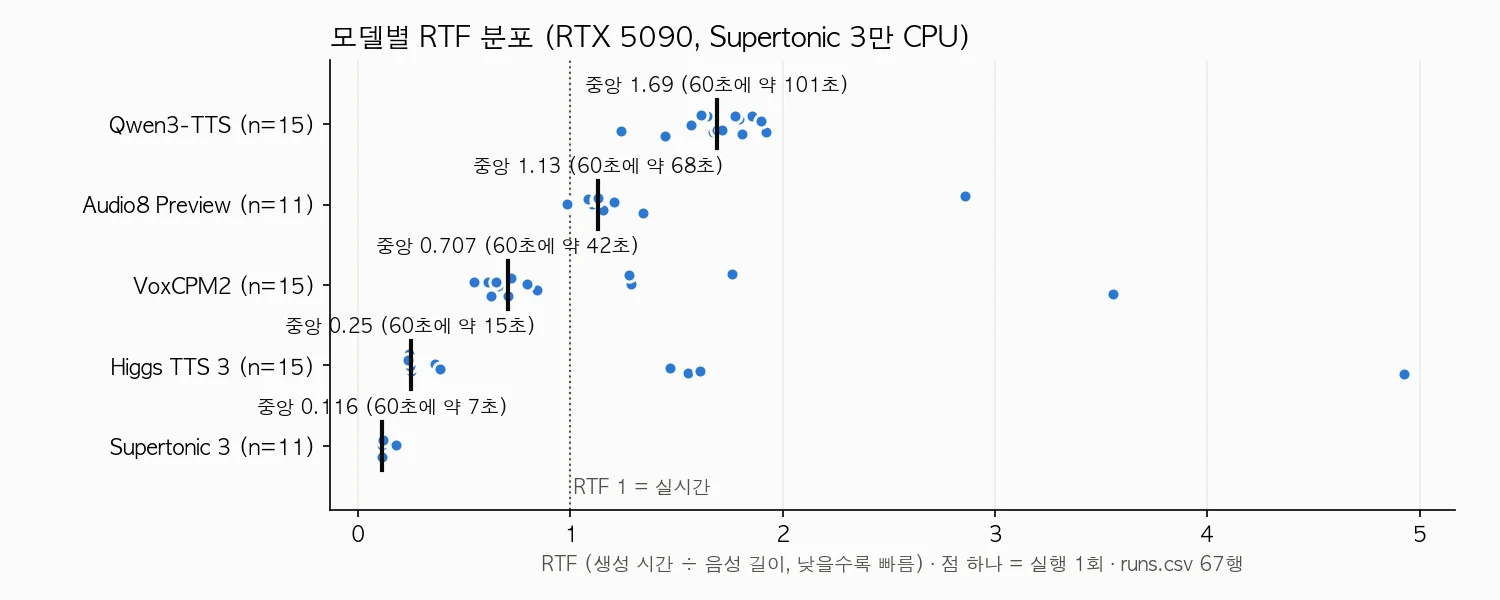
중앙값(검은 세로선)만 보면 표와 같은 순서지만, 점을 펼쳐 보면 표에 안 보이던 것이 있습니다. Higgs TTS 3는 대부분 0.25 근처에 몰려 있는데 1.54.9까지 느린 실행이 4번 섞여 있고, VoxCPM2(최대 3.55)와 Audio8(최대 2.86)에도 중앙값보다 크게 느린 실행이 섞여 있습니다. 반대로 Qwen3-TTS는 느리지만 1.21.9 사이로 고르게 모여 있습니다. 느린 실행이 첫 호출 예열 때문인지 대본 길이 때문인지는 기록만으로 확정할 수 없습니다. 중앙값만 보고 고르면 가끔 몇 배 느린 실행이 섞일 수 있다는 정도로 읽어주세요.
일반 내레이션 비교 결과
먼저 호흡과 페이싱을 비교했습니다. 긴 한국어 내레이션에서 문장 사이의 쉼, 강세, 속도, 끝부분 누락을 확인했습니다. 다섯 모델에는 같은 대사를 넣었습니다.
자동화의 장점은 단순히 빨라지는 데 있지 않습니다. 반복할 수 있고, 비교할 수 있고, 필요할 때 같은 설정으로 다시 만들 수 있다는 점이 더 중요합니다.
이 구간에서는 다섯 모델 모두 실사용을 검토할 수 있는 수준이었습니다. 2~3년 전만 해도 한국어 TTS는 선택지 자체가 좁았습니다. 지금은 정보 전달형 내레이션이라면 어느 모델을 골라도 큰 문제는 없었습니다.
이후 평가는 직접 들은 결과이므로 제 취향이 들어갑니다. 제 귀에는 Higgs TTS 3가 가장 깔끔하고 매끄러웠고, VoxCPM2는 AI 음성이라는 느낌이 조금 남았습니다. 경량 모델인 Supertonic 3도 99M 파라미터를 고려하면 내레이션 품질이 괜찮았습니다. 다만 수치로 매긴 점수가 아니라 개인적인 청취 결과입니다. 같은 파일을 듣고 다른 순서를 매길 수도 있습니다.
같은 한국어 내레이션 원본 듣기
아래는 각 모델에서 생성한 ko_pacing 원본 WAV입니다. 위 인용문 뒤에 “잠깐 멈추고 결과를 들어본 다음, 가장 잘 맞는 목소리를 고르면 됩니다”까지 이어집니다. 표 전체를 대표하는 속도 샘플이 아니라 같은 대본의 청취 비교이며, 오독이 남은 결과도 그대로 제공합니다.
Qwen3-TTS Sohee — 한국어 내레이션 WAV
Supertonic 3 F1 — 한국어 내레이션 WAV
Higgs 음성 표기: This audio was created with Boson AI's Higgs Audio — Boson AI.
다섯 파일을 한 시간축에 세우면 말하는 속도와 쉼의 차이가 눈으로 보입니다. 공개 WAV를 그대로 읽어 그렸습니다.
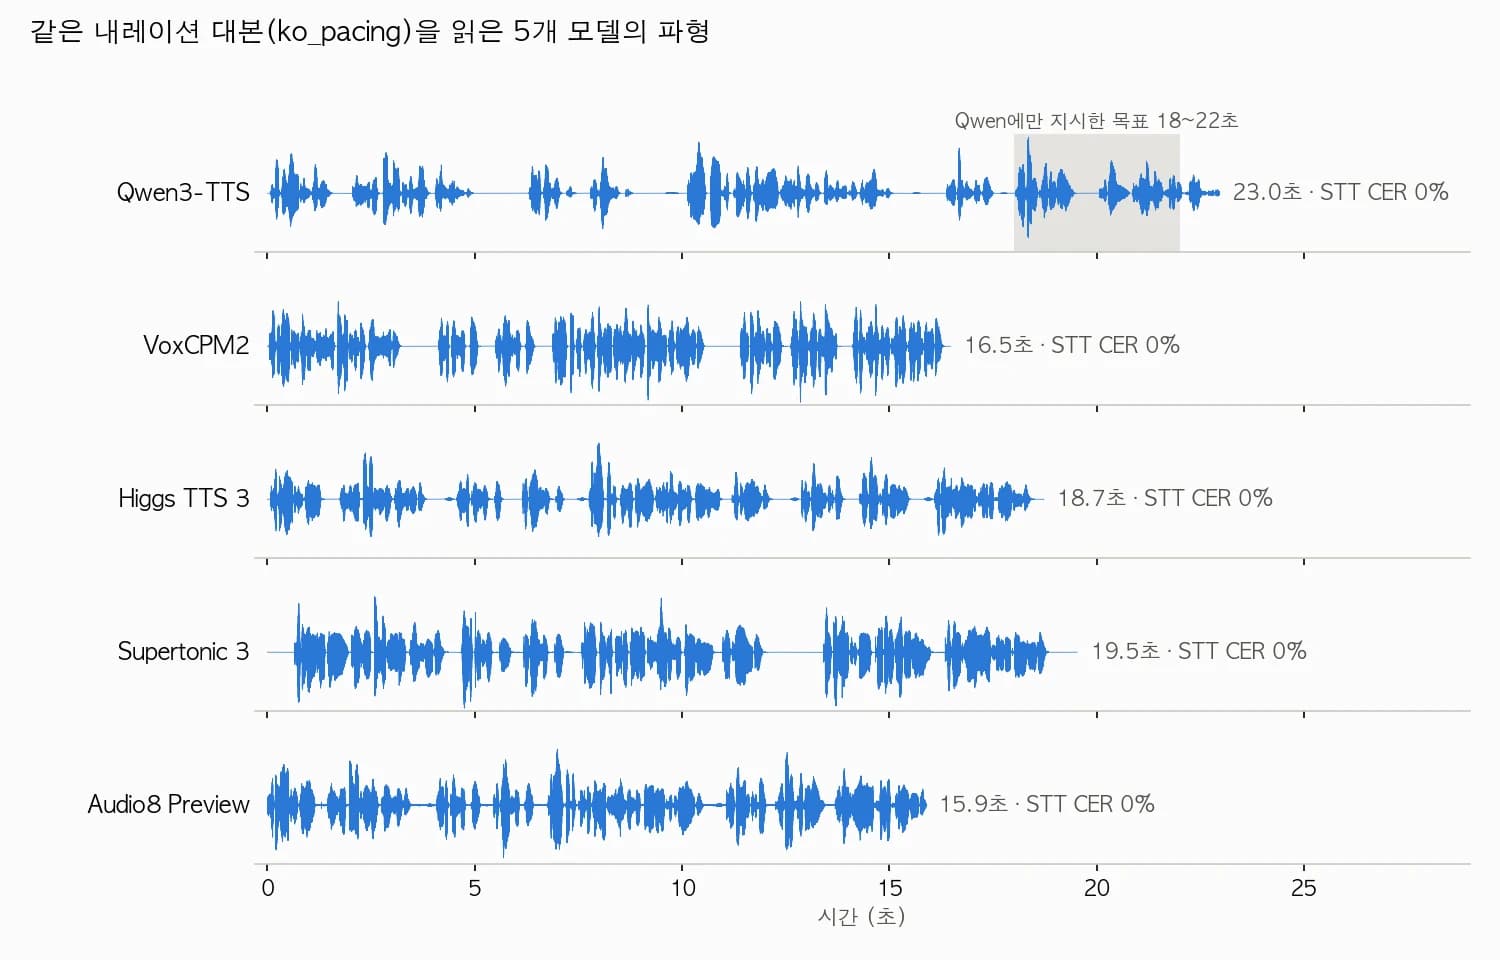
같은 대본인데 길이가 15.9초에서 23.0초까지 벌어집니다. 재미있는 건 Qwen3-TTS입니다. 다섯 모델 중 Qwen에만 자연어로 속도 지시를 넣을 수 있어서 아래 지시문을 함께 넣었는데, 결과는 목표보다 1초 긴 23.0초였고 파형에서도 문장 사이 쉼이 가장 길게 보입니다.
Speak in Korean at a natural conversational pace with only short, natural pauses between sentences. Do not speak slowly or stretch syllables. Finish the full passage in about 18 to 22 seconds.
(번역) 문장 사이에 짧고 자연스러운 쉼만 두고, 자연스러운 대화 속도로 한국어로 말해줘. 천천히 말하거나 음절을 늘이지 마. 전체 문단을 18~22초 안에 끝내.
"대본대로 읽었는가"도 다시 확인했습니다. 다섯 WAV를 mlx-whisper(whisper-large-v3-turbo, 언어 ko, temperature 0)로 받아 적어 대본과 글자 단위로 비교했더니 **다섯 개 모두 CER 0%**였습니다(문장부호·띄어쓰기 제외, 2026-10-02 macOS 재실행). 이 내레이션 대본에서는 어떤 모델도 단어를 빼먹거나 잘못 읽지 않았다는 뜻이고, 앞에서 "어느 모델을 골라도 큰 문제는 없었다"고 쓴 판단의 근거가 됩니다. 차이는 정확도가 아니라 속도와 쉼, 음색에서 났습니다.
모델별 보이스 선택 방식
다음으로 보이스 선택 방식을 확인했습니다. 다섯 모델이 모두 사람 이름 형태의 공식 성우 목록을 제공하는 것은 아닙니다. 이 차이에 따라 실제 제작 과정도 달라집니다.
| 모델 | 보이스 체계 |
|---|---|
| Qwen3-TTS | Sohee, Vivian, Ryan, Aiden 등 이름형 공식 preset(사전 정의된 보이스) |
| Supertonic 3 | F1 |
| VoxCPM2 | 고정 성우명 없이 Voice Design(자연어로 목소리 특성을 지정하는 기능)과 레퍼런스 클론 중심 |
| Higgs TTS 3 | 고정 성우명 없이 zero-shot clone(참조 음성만으로 목소리를 복제하는 방식)과 표현 제어 중심 |
| Audio8 | 고정 성우명 없이 레퍼런스 기반 zero-shot clone 중심 |
고정 성우가 없는 모델은 보이스 클론을 중심으로 설계되어 있습니다. 바로 사용할 목소리가 필요하면 Qwen3-TTS나 Supertonic 3가 편합니다. 채널 전용 목소리를 만들 계획이라면 나머지 세 모델을 검토할 수 있습니다.
참고로 Qwen3-TTS의 Sohee는 한국어 네이티브 preset이지만 Ryan과 Aiden은 영어 네이티브 preset입니다. 같은 한국어 대사를 넣어도 발음과 페이싱이 달라집니다. 한국어 내레이션을 빠르게 시작한다면 Sohee부터 확인하는 편이 좋습니다.
숫자와 터미널 명령어 발음 비교
일반 내레이션 다음으로 날짜, 금액, 소수점, 버전 번호, 주문번호, GPU 명칭을 넣어 봤습니다. 실제 제작에서 자주 쓰는 표기지만 TTS가 정확히 읽지 못하는 경우가 많았습니다. 테스트 문장은 다음과 같습니다.
2026년 8월 27일 새벽 3시 07분
RTX 5090
32GB VRAM
API v2.4.1
12,345,678원
12.7퍼센트
AI-2026-0827
Qwen3-TTS는 버전 번호 v2.4.1을 어색하게 읽었고 금액도 제대로 읽지 못하는 경우가 있었습니다. VoxCPM2도 금액에서 똑같이 걸렸습니다. VRAM을 "브람"처럼 읽는 사례가 여러 번 나왔습니다. Supertonic 3는 32GB를 "32지비"로 읽었고 Audio8은 한국어 화자가 아닌 듯한 어눌함이 섞였습니다.
가장 무거운 Higgs TTS 3도 같은 구간에서 틀렸습니다. 파라미터가 크더라도 숫자를 모두 정확히 읽는 것은 아니었습니다. 표현력과 표기 해석은 따로 확인해야 합니다.
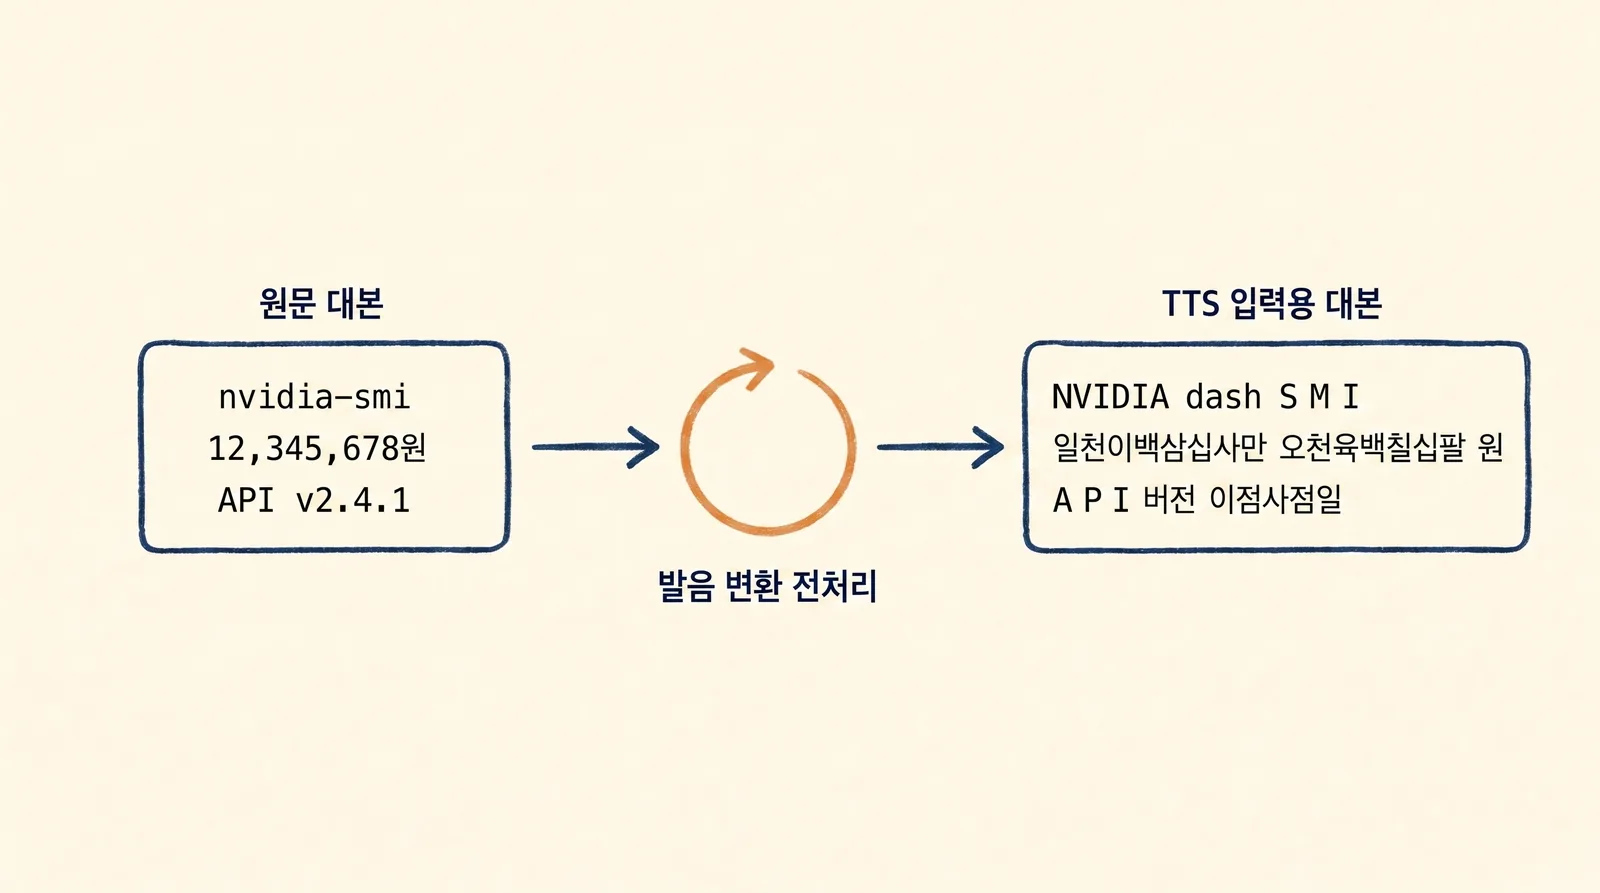
그다음 터미널 명령어를 확인했습니다. 원문과 TTS 입력용 변환문을 나란히 두면 다음과 같습니다.
[원문]
uv run python app.py
D:\voice-comparison\outputs
nvidia-smi
git --version

[TTS 입력용 전처리]
uv run python app dot py
D colon backslash voice comparison backslash outputs
NVIDIA dash S M I
git dash dash version
이 테스트에서는 VoxCPM2가 상대적으로 명령어를 잘 읽었습니다. Supertonic 3와 Audio8은 uv run을 제대로 읽지 못해 이 구간에서 제외했습니다. Higgs TTS 3도 명령어 부분에서는 발음이 흔들렸습니다. 모든 명령어를 항상 정확하게 읽은 모델은 없었습니다.
제가 이 부분을 붙잡는 건 직접 데였기 때문입니다. 테크 주제를 자동화하다 보면 생성된 대본에 명령어나 경로가 툭 튀어나옵니다. 검수 단계를 넣지 않고 TTS를 돌려버린 뒤 완성본을 들으면서 아차 싶었던 적이 몇 번 있습니다. 그 뒤로는 대본이 TTS에 들어가기 전에 정규표현식과 언어 모델을 함께 써서 발음 가능한 형태로 바꾸는 단계를 고정으로 넣습니다.
전처리를 많이 적용하면 부작용도 생깁니다. 명령어를 지나치게 한글 발음으로 바꾸면 원래 기술 용어를 알아듣기 어려워집니다. 어느 정도까지 바꿀지는 채널 성격에 맞춰 정해야 합니다.
영어와 일본어 확인 범위
영어는 다섯 모델 모두 안정적이었습니다. 따로 나눠 들을 필요가 없을 정도였습니다.
일본어도 비교 대상 모델 전부 실사용을 검토할 만한 수준으로 들렸습니다. 다만 여기에는 명확한 한계가 있습니다. 저는 일본어 원어민이 아니고 이번 비교에서 원어민 평가를 받지도 않았습니다. 억양이 자연스러운지 어색한 발음이 섞였는지는 제 귀로 판정할 수 없습니다. 일본어 콘텐츠를 실제로 발행하실 계획이라면 해당 언어 화자의 검수를 한 번 거치시길 권합니다.
다국어 채널을 운영한다면 하나 더 알아두셔야 합니다. 같은 보이스를 여러 언어에 얹을 수는 있지만 그 보이스의 원어민 언어 억양이 남습니다. 일본어 성우를 클론해 한국어를 생성하면 일본어 특유의 억양이 섞여 나옵니다.
감정 표현 비교 결과: Higgs TTS 3
감정 비교에는 감정이나 스타일을 직접 제어할 수 있는 Qwen3-TTS, VoxCPM2, Higgs TTS 3만 넣었습니다. 나머지는 감정 태그를 지원하지 않거나 결과가 나오지 않아 제외했습니다. 축은 셋으로 나눴습니다.
- 기쁨: 밝기와 에너지, 과장 정도
- 분노: 음량만 키운 것인지, 감정이 실제로 전달되는지
- 속삭임: 작은 음량과 숨 섞인 소리가 끝까지 유지되는지
제 청취 기준으로는 Higgs TTS 3가 세 축 모두에서 인상적이었습니다. Qwen3-TTS는 기쁨 대사가 국어책 읽기에 가까웠고 VoxCPM2는 텐션이 억지스럽게 들렸습니다. 분노와 속삭임에서도 Higgs TTS 3 쪽이 표현 폭이 넓었습니다. 스토리형 콘텐츠를 만든다면 장비가 감당되는 선에서 이 모델을 쓰겠습니다.
실제로 감정 표현은 제어 문법만 넣는다고 자연스러워지지 않았습니다. 대사 자체에도 해당 감정이 드러나야 했습니다. 평범한 문장에 분노 태그만 붙이면 음량만 커진 낭독이 나옵니다. 모델마다 감정 제어 문법도 다르므로 모델을 바꿀 때는 대본 포맷도 함께 수정해야 합니다.
참고로 당시 넣은 감정 지시문 원문은 공개한 generation-controls.json에 그대로 있습니다. 모델마다 문법이 얼마나 다른지 한눈에 보이도록 표로 옮깁니다.
| 감정 | Qwen3-TTS (자연어 instruct) | VoxCPM2 (문장 앞 설명) | Higgs TTS 3 (인라인 토큰) |
|---|---|---|---|
| 기쁨 | Very happy, excited, joyful, and energetic.<br>(번역) 아주 행복하고 들뜨고 기쁘고 에너지 넘치게. | extremely joyful, excited, bright and energetic<br>(번역) 몹시 기쁘고 들뜨고 밝고 활기차게 | <|emotion:elation|><|prosody:expressive_high|><|prosody:pitch_high|> |
| 분노 | Speak with an extremely angry emotion. Shout with intense anger.<br>(번역) 극도로 화난 감정으로 말해. 격렬한 분노로 소리쳐. | furious, shouting loudly, fast and intense<br>(번역) 격분해서 크게 소리치며 빠르고 강렬하게 | <|emotion:anger|><|style:shouting|><|prosody:expressive_high|> |
| 속삭임 | Speak only in a very quiet, breathy whisper. Do not use a normal speaking voice.<br>(번역) 아주 조용하고 숨 섞인 속삭임으로만 말해. 평소 목소리는 쓰지 마. | breathy whisper, extremely quiet, close to the microphone<br>(번역) 숨 섞인 속삭임, 아주 조용하게, 마이크에 가까이 | <|style:whispering|> |
Qwen은 문장으로 부탁하고, VoxCPM2는 형용사를 나열하고, Higgs는 정해진 토큰을 문장 앞에 붙입니다. 모델을 바꾸면 대본 포맷도 바꿔야 한다는 말이 이런 뜻입니다. (감정 결과 음원은 이번 공개 자료에 포함되지 않아 들려드리지 못합니다.)
모델별 라이선스 확인
라이선스를 확인하면서 영상 내용도 하나 정정합니다. 영상에서는 Supertonic의 실행 코드를 Apache-2.0이라고 설명했지만, 공식 저장소 기준 실행·샘플 코드는 MIT이고 모델 가중치는 OpenRAIL-M입니다.
라이선스는 다음 세 가지로 나뉩니다.
Apache-2.0: Qwen3-TTS, VoxCPM2, Audio8에 적용됩니다. 상업 콘텐츠와 제품 사용이 가능합니다. 모델이나 코드를 재배포할 때는 라이선스와 저작권, NOTICE 보존, 수정 표시 같은 조건을 확인해야 합니다.
OpenRAIL-M: Supertonic 3 모델 가중치에 적용됩니다. 상업 이용 자체를 막지는 않지만 불법, 사기, 차별, 무동의 성대모사 같은 금지 용도를 지켜야 합니다. 모델을 재배포하거나 서비스로 제공할 때는 같은 사용 제한을 다음 이용자에게도 넘겨야 합니다.
Higgs TTS 3 Creator Use Grant: Higgs TTS 3는 본인이 운영하는 영상, 팟캐스트, 오디오북, SNS 콘텐츠라면 수익화가 가능합니다. 대신 음성이나 설명란에 Boson AI의 Higgs Audio를 썼다는 사실을 눈에 띄게 표시해야 합니다.
This audio was created with Boson AI's Higgs Audio — https://www.boson.ai/higgs-audio
Higgs 모델을 API, SaaS, 앱, 플러그인처럼 제3자용 음성 생성 서비스로 제공하거나, 모델을 재배포·재판매하거나, 재판매를 목적으로 fine-tuning 하려면 Boson AI와 별도 상업 라이선스가 필요합니다. 개인이 자기 콘텐츠에 쓰는 범위라면 위의 표기 의무만 지키면 추가 라이선스는 필요 없습니다.
모델 라이선스와 목소리에 대한 권리는 별개입니다. Apache-2.0 모델이라도 실존 인물이나 성우의 목소리를 동의 없이 복제할 수 있는 것은 아닙니다.
TTS 자동화 검수 단계
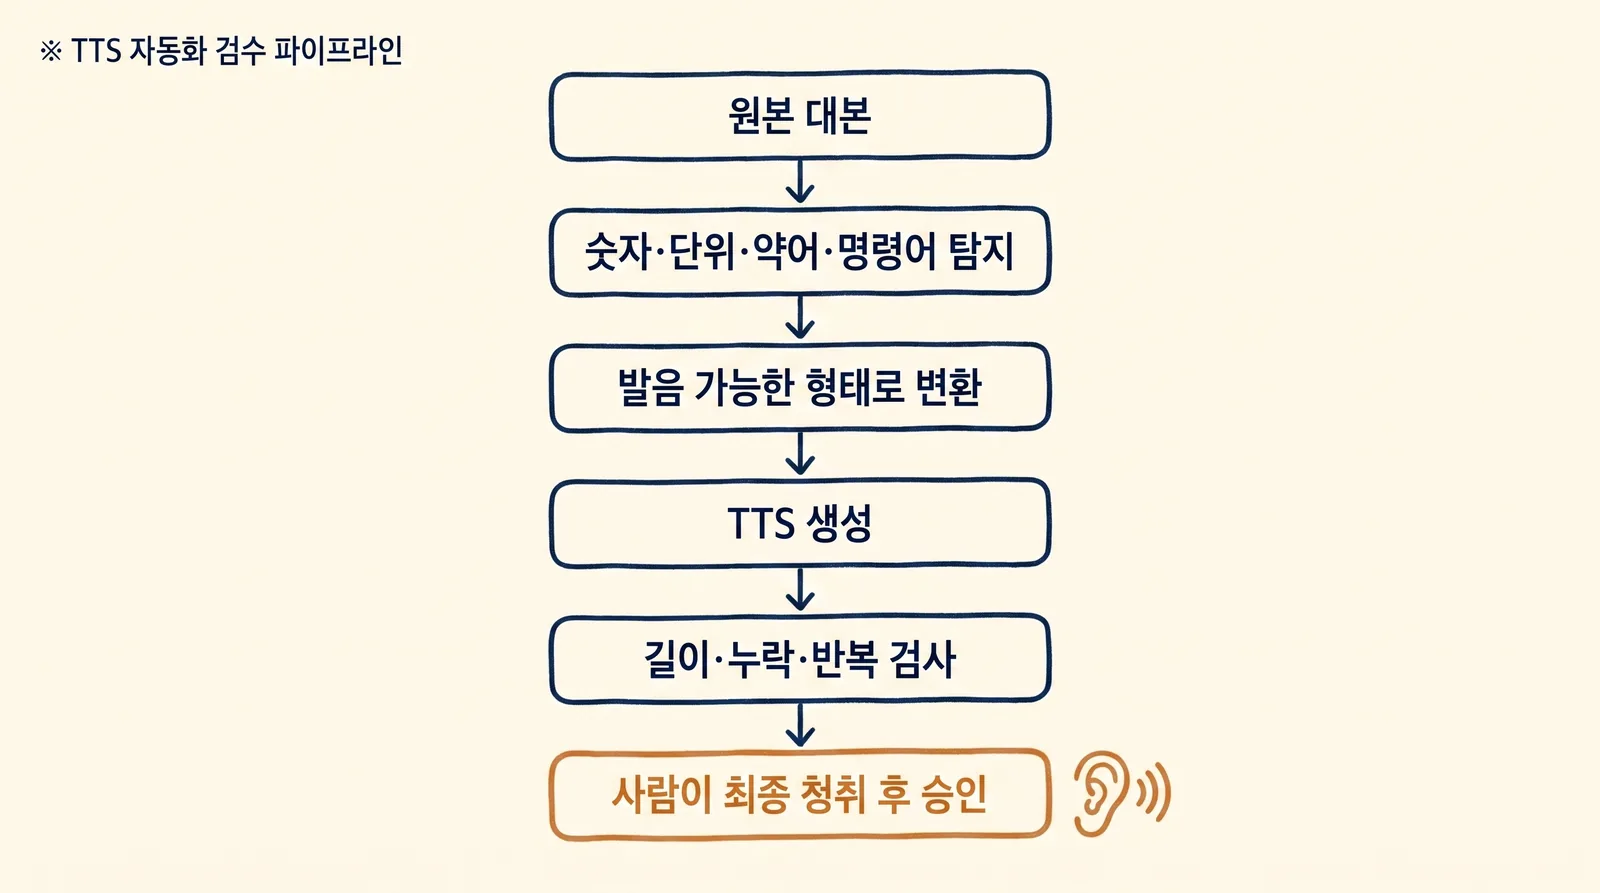
위 실험 결과를 파이프라인에 적용한다면 다음과 같은 순서로 구성할 수 있습니다.
원본 대본
  ↓
숫자·단위·영문 약어·명령어 탐지
  ↓
발음 가능한 형태로 변환
  ↓
TTS 생성
  ↓
길이·문장 누락·반복 검사
  ↓
사람이 최종 청취 후 승인
점검 항목은 이렇게 잡고 있습니다.
- 날짜와 시간을 의도한 방식으로 읽는가
- 금액과 소수점을 빠뜨리지 않는가
- GB, VRAM, API 같은 약어를 이상하게 읽지 않는가
- 파일명과 경로의 슬래시, 백슬래시를 구분하는가
- 문장 끝이 잘리거나 같은 문장을 반복하지 않는가
- 감정 지시 때문에 발화가 지나치게 느려지지 않는가
- 보이스 클론에 쓴 레퍼런스의 동의를 확보했는가
마지막의 청취 검수 단계는 아직 제외하기 어렵습니다. 자동화 범위를 넓히더라도 사람이 한 번 듣고 승인하는 단계를 남겨두는 편이 안전합니다.
참고로 이번 비교에서 만든 음원 파일 중 오독 가능성이 있는 것에는 CHECK, 반복이나 문장 누락이 실제로 확인된 것에는 FAIL 표시를 붙여 그대로 남겼습니다. 잘 나온 샘플만 골라 보여주면 어떤 지점에서 파이프라인이 깨지는지 알 수 없기 때문입니다.
제 패키지의 04_terminal_commands 폴더는 이렇게 생겼습니다.
01F_01_qwen3_tts_sohee.wav
01F_02_voxcpm2_design.wav
01F_03_higgs_tts_3_sohee__FAIL_REPEAT_81S.wav
01F_04_supertonic3_f1.wav
01F_05_audio8_sohee__CHECK_COMMANDS.wav
FAIL_REPEAT_81S는 Higgs TTS 3가 같은 문장을 반복해 81초까지 늘어진 결과이고, CHECK_COMMANDS는 Audio8이 명령어를 제대로 읽었는지 직접 들어봐야 하는 샘플입니다.
대본 전처리 코드 실행
전처리 단계를 시작할 수 있도록 원문과 발음용 대본을 분리하는 실습을 추가했습니다. 명시적으로 정한 발음 사전만 적용하고, 미등록 숫자·명령어는 그대로 남겨 사람이 검토하도록 표시합니다. 자막과 복사할 코드를 보존하기 위해 원문은 별도 필드에 유지합니다.
이 추가 실습에서는 10문장의 텍스트 변환을 실행했습니다. 7문장은 사전에 따라 치환했고, 나머지 3문장은 미등록 표기를 검토 대상으로 남겼습니다. 새 음성을 생성한 실험은 아니므로 위 모델 비교의 표본이나 오독 개선율에 합산하지 않습니다. 코드 실행 결과가 맞아도 실제 음성을 들어보는 단계는 필요합니다.
전처리 코드·입력·검사·결과 ZIP과 변환 전후 CSV를 신청 없이 받을 수 있습니다. API를은 바꾸고 API_KEY는 보존하는 차이, 처음 보는 12.5를 억지로 변환하지 않는 이유를 실습 글에서 설명했습니다.
내 대본으로 비교할 때 기록할 항목
위 실측값은 제 장비에서 후보를 좁히기 위한 자료입니다. 같은 모델을 고르더라도 자신의 채널 대본에서는 다른 오류가 나올 수 있습니다. 다음은 독자가 추가 비교를 할 때 사용할 기록 양식이며, 이 글의 실측 결과에 새 표본을 더한 것은 아닙니다.
| 기록 항목 | 남길 내용 |
|---|---|
| 실행 조건 | 모델·가중치 버전, 보이스, 실행 장치, 생성 설정 |
| 대본 | 원문과 발음용 변환문을 각각 저장 |
| 시간 | 모델 로딩 시간과 실제 생성 시간을 구분 |
| 결과 길이 | 배속을 바꾸기 전 음원의 길이 |
| 오류 위치 | 금액·버전 오독, 반복, 누락이 들린 시각 |
| 사용 판단 | 그대로 사용 / 해당 문장 재생성 / 보이스나 모델 변경 |
연습 문장은 “오후 3시 20분에 버전 2.5를 설치하고, 저장 공간 3.5GB를 확인합니다”처럼 시간·버전·단위를 섞어 만들 수 있습니다. 이 문장은 기존 실험에 사용한 대사가 아니라 새 검수용 예시입니다. 원문과 발음형을 각각 생성해 들으면 전처리가 개선한 지점과 오히려 어색하게 만든 지점을 구분할 수 있습니다. 화면 자막과 복사할 명령어는 원문으로 남기고 음성 입력만 분리하세요.
속도는 음원 길이와 함께 봅니다. 예를 들어 60초 음성을 생성하는 데 30초가 걸렸다면 생성 시간/음원 길이는 0.5입니다. 설명용 계산이며 특정 모델의 추가 측정값이 아닙니다. 서로 다른 길이의 음원이나 로딩 포함 여부가 다른 시간을 그대로 비교하지 않기 위한 지표입니다.
성공한 파일만 남기면 비교하기 어렵습니다. 같은 문장을 몇 번 재생성했는지와 검수에 걸린 시간도 함께 기록해야, 생성은 빨라도 손으로 고칠 일이 많은 후보를 골라낼 수 있습니다. 이 글은 한 PC의 서로 다른 대본·보이스를 집계한 결과입니다. 같은 입력의 반복 평균이나 분산을 측정한 자료가 아니므로 다른 PC의 예상 처리량으로 그대로 사용할 수는 없습니다.
목적별 모델 선택
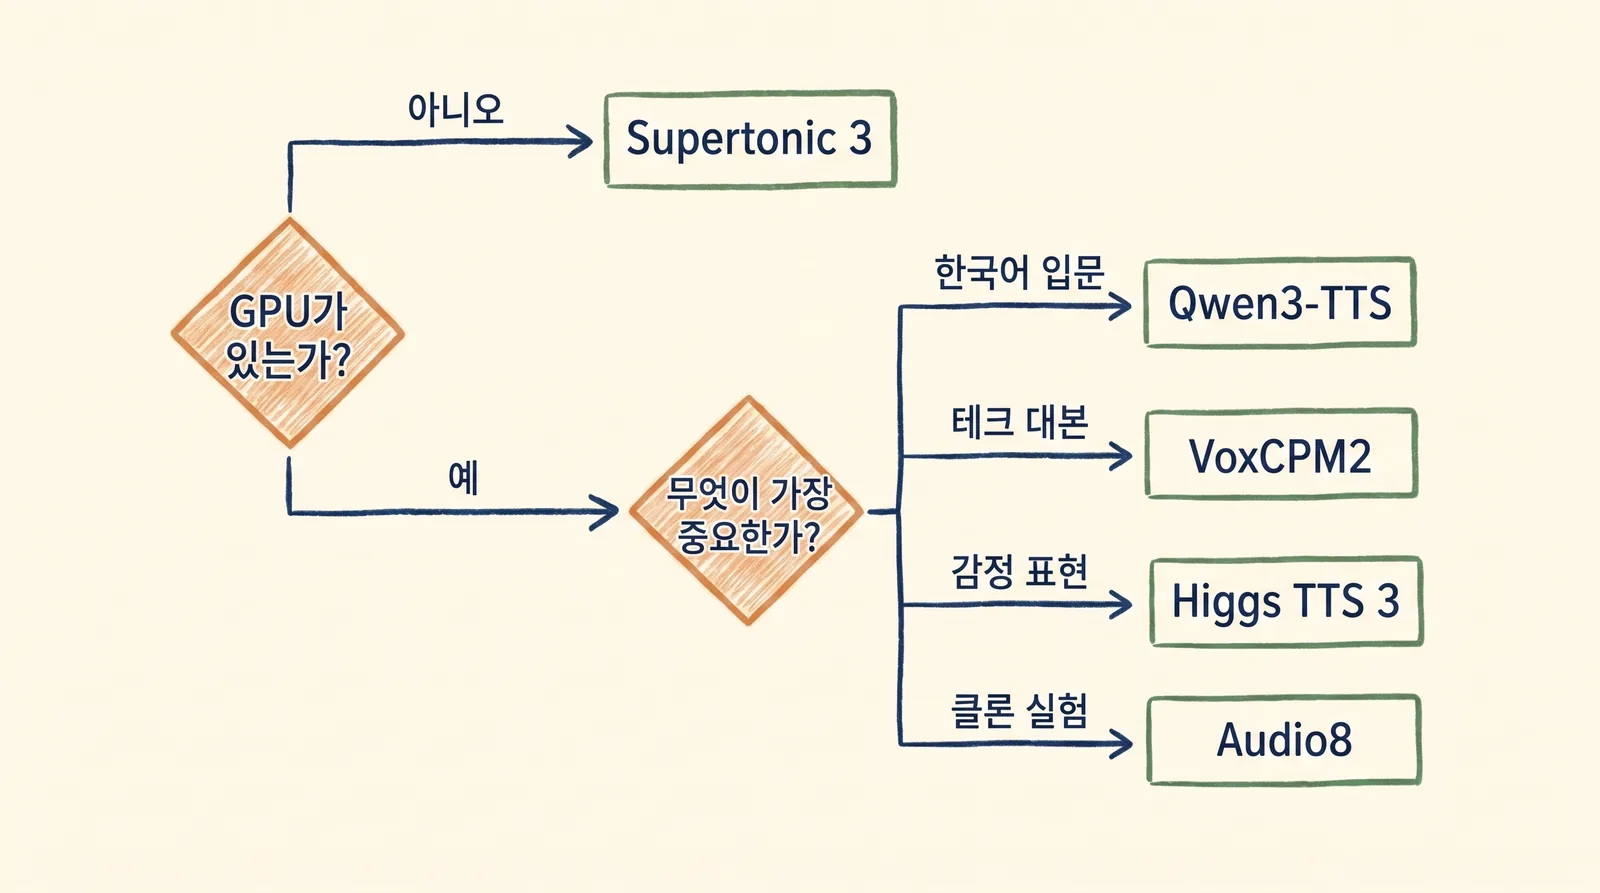
한 모델을 절대적인 1위로 정하기는 어렵습니다. 일반 내레이션, 감정 표현, 다국어, 테크 대본, 장비 조건에 따라 선택이 달라집니다. 제가 확인한 결과를 기준으로 정리하면 다음과 같습니다.
GPU가 없거나 처음 시작하는 경우: Supertonic 3입니다. CPU에서 돌아가고 이번 CPU 실행 기록의 중앙 RTF는 0.116으로, 60초 음성으로 환산하면 약 7초입니다. 모든 CPU에서 같은 속도가 나온다는 뜻은 아닙니다. 여성 5종, 남성 5종 공식 스타일이 있어 고르기도 쉽습니다. 입문 단계에서 이만큼 문턱이 낮은 선택지는 없습니다. 다만 숫자와 터미널 명령어 구간에서는 이 글의 테스트 중 가장 약했습니다. 테크 대본을 다룬다면 VoxCPM2 쪽을 먼저 보세요.
한국어 내레이션을 빠르게 시작하는 경우: Qwen3-TTS의 Sohee preset을 쓰겠습니다. 자연어로 말투를 지시할 수 있어 편합니다. 대신 숫자, 금액, 버전, 경로는 반드시 따로 확인하셔야 합니다.
속도와 품질의 균형이 필요한 경우: VoxCPM2입니다. 48kHz 출력에 Voice Design을 지원하고 이번 터미널 명령어 테스트에서 상대적으로 안정적이었습니다. 테크 대본 비중이 높다면 우선 후보로 놓겠습니다.
스토리와 감정 표현이 중요한 경우: 장비 여유가 있다면 Higgs TTS 3입니다. VRAM 26.778GB는 사실상 32GB급 GPU를 전제합니다. 라이선스 표기 의무도 먼저 확인하셔야 합니다.
작은 모델로 보이스 클론을 실험하는 경우: Audio8입니다. 0.6B 크기에 44.1kHz 출력이라는 조합이 흥미롭습니다. 다만 아직 Preview 단계입니다. 한국어 장문, 숫자, 명령어는 실제 제작 전에 충분히 테스트해야 합니다.
벤치마크 점수표는 후보를 좁히는 용도로 사용할 수 있습니다. 마지막 선택은 같은 대사를 직접 생성해 들어본 뒤 정하는 편이 낫습니다. 목소리는 정성 평가가 필요한 영역이고 콘텐츠마다 필요한 말투와 호흡도 다르기 때문입니다.
다음 글 예고 & Reference
후속편인 보이스클론 5종의 참조 길이·방식 비교를 발행했습니다. 제 목소리를 참조로 넣은 결과와 Audio8의 긴 참조 실패를 원본 음원·STT 기록으로 확인할 수 있습니다.
이 글의 수치는 2026-08-29 기준이며, 모델 버전과 라이선스 조항은 바뀔 수 있습니다. 스펙과 라이선스는 아래 공식 문서에서 다시 확인하시길 권합니다.
모델 공식 저장소
- Qwen3-TTS 1.7B CustomVoice: 공식 코드 · 모델 카드
- VoxCPM2: 공식 코드 · 모델 카드
- Higgs TTS 3 4B: 모델 카드 · 실행 프레임워크
- Supertonic 3: 공식 코드 · 모델 카드
- Audio8 TTS Preview 0.6B: 공식 코드 · 모델 카드
라이선스 표기 안내
원본 영상
추가 학습 자료 신청
ZEXEA 메인 사이트의 자료 신청 페이지로 이동합니다. 이름·이메일·전화번호 등의 입력이 필요합니다. 블로그 글과 실습 예제는 신청 없이 모두 읽을 수 있습니다.
관련 가이드
오픈소스 TTS 보이스클론 5종 비교, 짧은 참조 18초와 긴 참조 30~180초 실측
오픈소스 TTS 5종에 제 음성 18초와 모델별 30~180초 참조를 넣어 보이스클론 결과를 화자 유사도와 STT 오류율로 실측했습니다. 긴 참조가 항상 낫지 않은 이유, Audio8 60초 실패 원인, 참조 음성 준비 요령까지 정리했습니다.
전체 과정 보기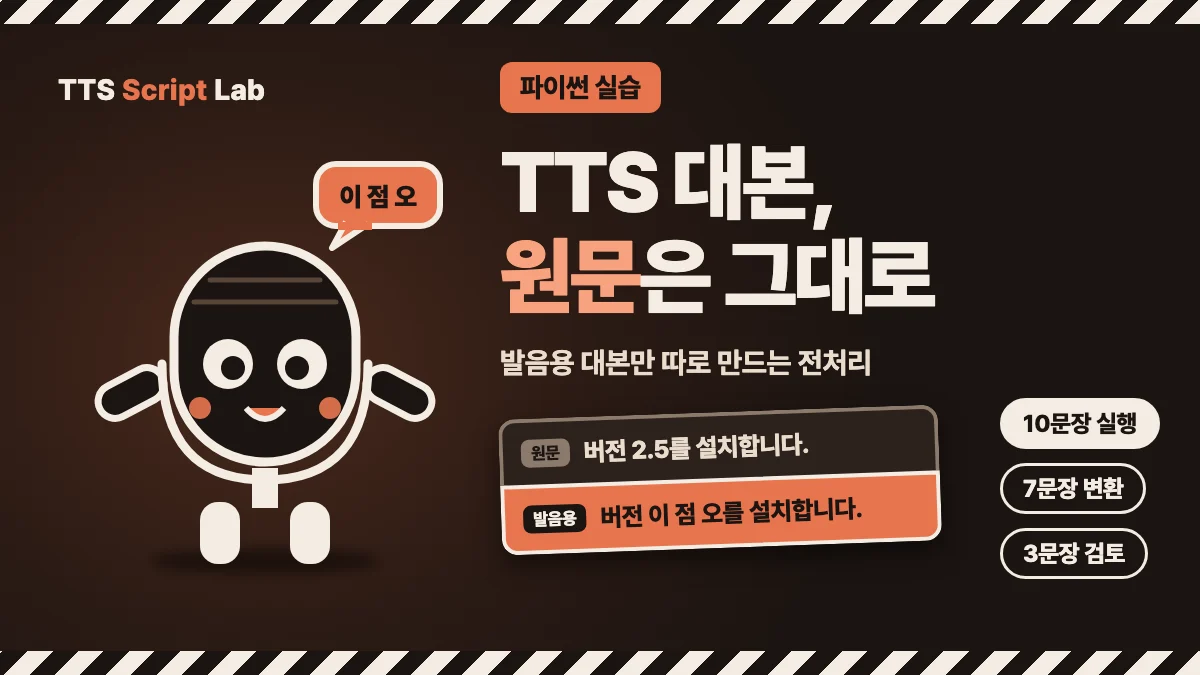
한국어 TTS 대본 전처리 실습: 원문을 보존하고 발음용 대본 따로 만들기
API·버전·시간·금액을 명시적인 발음 사전으로 바꾸는 파이썬 코드와 10문장 실행 결과를 제공합니다. 식별자 오변환을 막고 미등록 숫자·명령어를 검토 대상으로 남기는 방법을 다룹니다.
전체 과정 보기
Higgsfield API로 밈 영상 자동화하기, Genjutsu로 6편 만들어 본 과정과 한 편 비용
Higgsfield API와 Genjutsu로 레퍼런스 밈 영상에 제 사진을 넣어 새 밈을 자동으로 만든 과정을 정리했습니다. API 키 연결, 작업 폴더 구조, 검열 실패 사례, 최종 6편의 실제 비용표까지 담았습니다.
전체 과정 보기