한국어 TTS 대본 전처리 실습: 원문을 보존하고 발음용 대본 따로 만들기
API·버전·시간·금액을 명시적인 발음 사전으로 바꾸는 파이썬 코드와 10문장 실행 결과를 제공합니다. 식별자 오변환을 막고 미등록 숫자·명령어를 검토 대상으로 남기는 방법을 다룹니다.
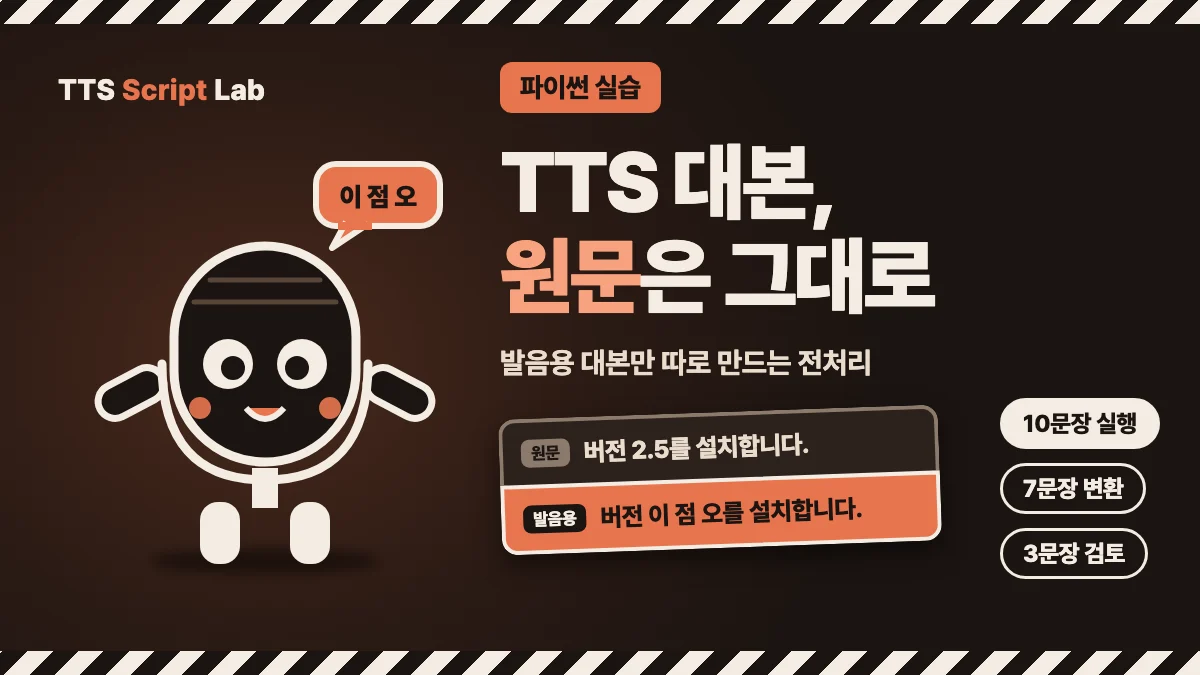
“버전 2.5를 설치합니다”라는 문장을 음성에 맞게 고치다 보면 자막이나 복사할 명령어까지 한글 발음으로 바뀌는 경우가 생깁니다. 원문을 덮어쓰지 않고 음성용 대본을 따로 만들면 이 문제를 피할 수 있습니다.
한국어 TTS 모델 비교에서 다룬 숫자와 명령어 검수를 코드로 옮겨 봤습니다. 명시적으로 등록한 표기만 바꾸고, 처음 보는 숫자와 식별자는 사람이 확인할 수 있도록 남깁니다. 이번에 실행한 범위는 텍스트 전처리입니다. 새 음성 샘플이나 모델별 발음 개선율을 측정한 결과는 아닙니다.
사용 도구 및 준비물
1. 실습 코드와 실행 결과
별도 신청 없이 내려받을 수 있습니다. 코드를 실행하기 전에 10문장 결과 CSV 또는 치환 기록 JSON을 먼저 확인해도 됩니다. JSON에는 원문과 변환문, 바꾼 구문, 미등록 상태로 남은 항목이 들어 있습니다.
ZIP 안의 fixture.json에는 발음 사전과 입력 문장, 기대 결과가 들어 있습니다. prepare.py로 대본을 변환하고, test_prepare.py로 식별자 보존과 구문 겹침을 검사합니다. 결과 파일은 실행할 때 같은 폴더에 다시 생성됩니다.
Python 3.11 이상에서 실행합니다. 공개 결과는 Windows 11, Python 3.11.15에서 2026년 9월 5일 확인했습니다. 외부 API나 TTS 모델을 사용하지 않아 GPU와 API 키가 필요하지 않습니다.
2. 발음 사전 작성
먼저 이번 대본에서 사용할 읽기 규칙을 정했습니다. 아래는 발음 사전의 일부입니다.
{
  "API": "에이피아이",
  "VRAM": "브이램",
  "3.5GB": "삼 점 오 기가바이트",
  "버전 2.5": "버전 이 점 오",
  "오후 3시 20분": "오후 세 시 이십 분",
  "12,500원": "만 이천오백 원",
  "uv run": "유브이 런"
}
이 표기가 모든 채널에 맞는 정답은 아닙니다. 같은 약어도 채널에 따라 읽는 방식이 다를 수 있습니다. 그래서 일반적인 한국어 수사 변환기를 만들기보다 이번 대본에서 사용할 표현을 먼저 정했습니다. ‘버전 2.5’를 등록해도 ‘버전 12.5’까지 자동으로 읽게 하지는 않습니다.
사전에 없는 값은 원문 그대로 남깁니다. 소수점, 버전 구분점, 문장 부호는 모양이 같아도 읽는 방식이 다르기 때문입니다. 처음 보는 값을 추측해서 바꾸기보다 검토 대상으로 표시하면 나중에 수정한 근거도 확인할 수 있습니다.
3. 원문과 발음용 대본 저장
그다음 ZIP을 새 폴더에 풀고 prepare.py가 있는 위치에서 다음 명령을 실행합니다.
python prepare.py
python -m unittest -v
첫 번째 명령은 results.json과 results.csv를 생성하거나 덮어씁니다. fixture.json은 변경하지 않습니다. 두 번째 명령을 실행하면 검사 5개가 동작합니다. Python 실행 파일을 찾지 못할 경우에는 설치 여부와 실행 경로부터 확인합니다.
실행 결과에는 다음 두 필드가 저장됩니다.
{
  "original": "VRAM 3.5GB를 확인합니다.",
  "spoken": "브이램 삼 점 오 기가바이트를 확인합니다."
}
original은 자막과 복사할 텍스트에 사용합니다. spoken은 사람이 읽어본 뒤 TTS에 넣는 초안입니다. 이 코드는 대본에 적힌 명령을 실행하지 않으며 음성 생성 도구로 자동 전송하지도 않습니다.
4. 치환 코드에서 확인할 세 가지
첫 번째는 치환 순서입니다. uv를 먼저 바꾸면 uv run이라는 긴 구문이 더 이상 매칭되지 않을 수 있습니다. 따라서 사전 키를 길이순으로 정렬한 뒤 원문에 대해 한 번만 치환합니다. 바뀐 결과를 사전에 다시 넣는 연쇄 치환은 하지 않습니다.
두 번째는 정규표현식 처리입니다. 사전 표기를 정규표현식 문법으로 해석하지 않도록 re.escape를 사용합니다. C++의 더하기 기호도 글자 그대로 찾기 위해서입니다. 이 동작은 Python re 공식 문서에서 확인할 수 있습니다.
세 번째는 식별자 보존입니다. API를의 API에는 읽기 규칙을 적용하지만 API_KEY나 CAPITAL의 일부까지 바꾸면 코드와 이름이 훼손됩니다. 코드에서는 영문·숫자·밑줄 경계를 확인합니다. 한국어 조사와 붙은 경우는 허용하므로, 한국어 단어 안에서 생기는 모든 모호함을 해결하는 범용 경계 규칙은 아닙니다.
5. 10문장 실행 결과
준비한 10문장을 실행한 결과, 모두 사전에 정해둔 텍스트 결과와 일치했습니다. 이 중 7문장은 치환됐고 3문장은 미등록 문자열이 남아 검토 대상으로 표시됐습니다.
| ID | 원문 | 결과 또는 검토 이유 |
|---|---|---|
| T1 | API를 연결합니다. | 에이피아이를 연결합니다. |
| T2 | VRAM 3.5GB를 확인합니다. | 브이램 삼 점 오 기가바이트를 확인합니다. |
| T3 | 버전 2.5를 설치합니다. | 버전 이 점 오를 설치합니다. |
| T4 | 오후 3시 20분에 만납니다. | 오후 세 시 이십 분에 만납니다. |
| T5 | 가격은 12,500원입니다. | 가격은 만 이천오백 원입니다. |
| T6 | uv run을 실행합니다. | 유브이 런을 실행합니다. |
| T7 | C++를 사용합니다. | 씨 플러스 플러스를 사용합니다. |
| T8 | CAPITAL과 API_KEY는 식별자입니다. | 원문 유지, 미등록 영문 검토 |
| T9 | 버전 12.5와 30GB를 확인합니다. | 원문 유지, 미등록 숫자·단위 검토 |
| T10 | python app.py --port 8080을 실행합니다. | 원문 유지, 미등록 명령어 검토 |
여기서 ‘10문장 일치’는 발음 정확도가 100%라는 뜻이 아닙니다. 코드가 기대한 문자열을 만들었다는 검사 결과입니다. 검토 대상으로 남기는 것이 정답인 T8~T10도 이 결과에 포함됩니다. 따라서 이를 발음 성공률로 보면 안 됩니다.
결과의 needs_text_review가 false여도 음성이 자연스럽다는 뜻은 아닙니다. 남은 영문·숫자 패턴이 없다는 신호일 뿐입니다. 한글로 바뀐 대본에도 잘못된 읽기나 어색한 조사가 있을 수 있습니다. unresolved 목록의 영문 또한 모두 오류는 아닙니다. 그대로 읽어도 되는 이름인지 사람이 판단해야 합니다.
6. 실제 음성 제작에 적용
먼저 T9의 숫자를 어떻게 읽을지 정한 뒤 사전에 정확한 구문을 추가합니다. 결과 파일을 다시 만들고 원문과 나란히 읽어 봅니다. 같은 문자열이 문맥에 따라 다른 뜻을 가진다면 대본별로 사전을 분리합니다. 파일 경로나 URL 전체를 한글로 바꾸는 규칙은 이 예제에 포함하지 않았습니다.
그다음 사용 중인 TTS 모델에서 원문과 변환문을 각각 생성해 들어봅니다. 모델 버전, 보이스, 생성 설정은 동일하게 두고 숫자와 명령어 구간의 오독, 문장 누락을 기록합니다. 입력만 바꿔야 전처리의 영향을 구분할 수 있습니다. 변환한 소리가 더 어색할 때 원문으로 돌아갈 수 있도록 두 입력과 음원을 함께 남깁니다.
실제 생성 전에 이번 코드에서 확인된 범위는 원문 보존, 정해둔 치환, 미등록 값 표시입니다. 음성 생성·청취 검수까지 통과해야 제작에 쓸 수 있습니다. 기존 TTS 비교 글의 실측 조건과 청취 기준을 함께 사용하면 모델 선택과 대본 검수를 따로 판단할 수 있습니다.
7. Supertonic 3로 원문과 발음용 대본 직접 들어보기
위 6단계의 "원문과 변환문을 같은 설정으로 각각 생성해 들어본다"를 실제로 해봤습니다. GPU 없이 CPU에서 돌아가는 Supertonic 3로 10문장을 원문 그대로 한 번, 발음용 대본으로 한 번씩 합성했습니다. 모델·보이스·설정은 같고 입력 글자만 다릅니다.
- 실행: 2026-10-02, macOS(Apple Silicon) CPU, pip
supertonic1.3.1, 모델 supertonic-3, 보이스 F1, 기본값(steps 8, speed 1.05), 문장당 1회 - 판정: 결과 음성을 mlx-whisper(whisper-large-v3-turbo, 언어 ko, temperature 0)로 받아 적어 TTS가 실제로 무엇이라고 말했는지 확인
| ID | 원문을 그대로 넣었을 때 STT | 발음용 대본을 넣었을 때 STT |
|---|---|---|
| T1 | APL을 연결합니다. | API를 연결합니다. |
| T2 | VURM 3.5G 리비를 확인합니다. | VRAM 3.5GB를 확인합니다. |
| T3 | 버전 2.5를 설치합니다. | 버전 2.5를 설치합니다. |
| T4 | 오후 3시 20분에 만납니다. | 오후 3시 20분에 만납니다. |
| T5 | 가격은 12,500원입니다. | 가격은 12,500원입니다. |
| T6 | 우 룬을 실행합니다. | UV Run을 실행합니다. |
| T7 | C.L. 루슈를 사유 | C++를 사용합니다. |
| T8 | CPTL과 APA KE는 식별자입니다. | (변환하지 않아 원문과 같은 입력) |
| T9 | 버전 12.5와 삼심지비를 확인합니다. | (변환하지 않아 원문과 같은 입력) |
| T10 | 피했던 app API, port-posing80을 실행합니다. | (변환하지 않아 원문과 같은 입력) |
STT가 숫자를 다시 아라비아 숫자로 적어 주기 때문에 T3~T5처럼 양쪽이 같게 보이는 줄은 "둘 다 숫자를 읽긴 읽었다"까지만 알 수 있습니다. 차이는 영문 약어와 기호에서 뚜렷했습니다.
- T1·T2:
API는 "APL"처럼,VRAM 3.5GB는 "VURM 3.5G 리비"처럼 들렸습니다. 발음용 대본(에이피아이, 브이램 삼 점 오 기가바이트)은 그대로 읽혔습니다. - T6:
uv run은 "우 룬"이 됐습니다. 영문 소문자 명령어를 한국어 문장 안에 넣으면 이렇게 읽힐 수 있습니다. - T7:
C++를 사용합니다는 "C.L. 루슈를 사유"에서 끊겼습니다. 기호 때문에 문장 끝이 잘린 경우라 전처리가 가장 필요한 유형입니다. - T8~T10: 사전에 없어서 검토 대상으로 남겨 둔 문장들입니다. 실제로
30GB는 "삼심지비"처럼, 명령어 줄은 거의 알아들을 수 없게 읽혔습니다. 이 실습이 이 문장들을 자동 변환하지 않고 "사람이 볼 것"으로 표시한 이유가 소리로 확인된 셈입니다.
정리하면 원문 10개 중 7개(T1·T2·T6·T7·T8·T9·T10)에서 읽기 문제가 나타났고 T3~T5는 STT로는 판별할 수 없었습니다. 발음용 대본으로 바꾼 7개는 모두 의도대로 받아 적혔습니다. 다만 모델 1종, 보이스 1개, 문장당 1회 결과이고 STT도 완벽한 귀가 아니라서, 다른 모델에서는 결과가 달라질 수 있습니다. 직접 들어보시는 게 가장 정확합니다.
T2 원문 "VRAM 3.5GB를 확인합니다." WAV
T2 발음용 "브이램 삼 점 오 기가바이트를 확인합니다." WAV
T7 발음용 "씨 플러스 플러스를 사용합니다." WAV
T9 원문 "버전 12.5와 30GB를 확인합니다." WAV (검토 대상)
T10 원문 "python app.py --port 8080을 실행합니다." WAV (검토 대상)
나머지 음원까지 20개 전부와 합성·STT 기록은 A/B 결과 CSV에, 같은 실험을 다시 돌리는 코드는 synthesize_ab.py에 있습니다. 합성 시간은 문장당 0.6~1.3초였습니다(모델 로딩 제외).
실행 파일과 Reference
공개한 입력 문장과 기대 결과, 실행 코드, 치환 기록을 함께 비교할 수 있습니다. 독자도 같은 파일로 직접 검사할 수 있도록 미등록 값과 식별자 사례를 제외하지 않았습니다.
- Python re 공식 문서:
re.escape의 리터럴 처리와re.sub의 콜백 치환 동작을 확인하는 자료입니다. - Python unittest 공식 문서: 함께 제공한
test_prepare.py를 실행하고 자신의 대본 사례를 검사에 추가할 때 참고합니다.
추가 학습 자료 신청
ZEXEA 메인 사이트의 자료 신청 페이지로 이동합니다. 이름·이메일·전화번호 등의 입력이 필요합니다. 블로그 글과 실습 예제는 신청 없이 모두 읽을 수 있습니다.
관련 가이드
한국어 오픈소스 TTS 모델 5종 비교, RTX 5090에서 직접 측정한 속도와 VRAM
한국어 오픈소스 TTS 모델 5종을 같은 대사로 직접 생성해 비교했습니다. RTX 5090에서 측정한 생성 속도와 VRAM, 숫자·터미널 명령어 오독 문제, 장비와 목적에 따른 선택 기준, Apache-2.0과 OpenRAIL-M 라이선스 차이까지 정리했습니다.
전체 과정 보기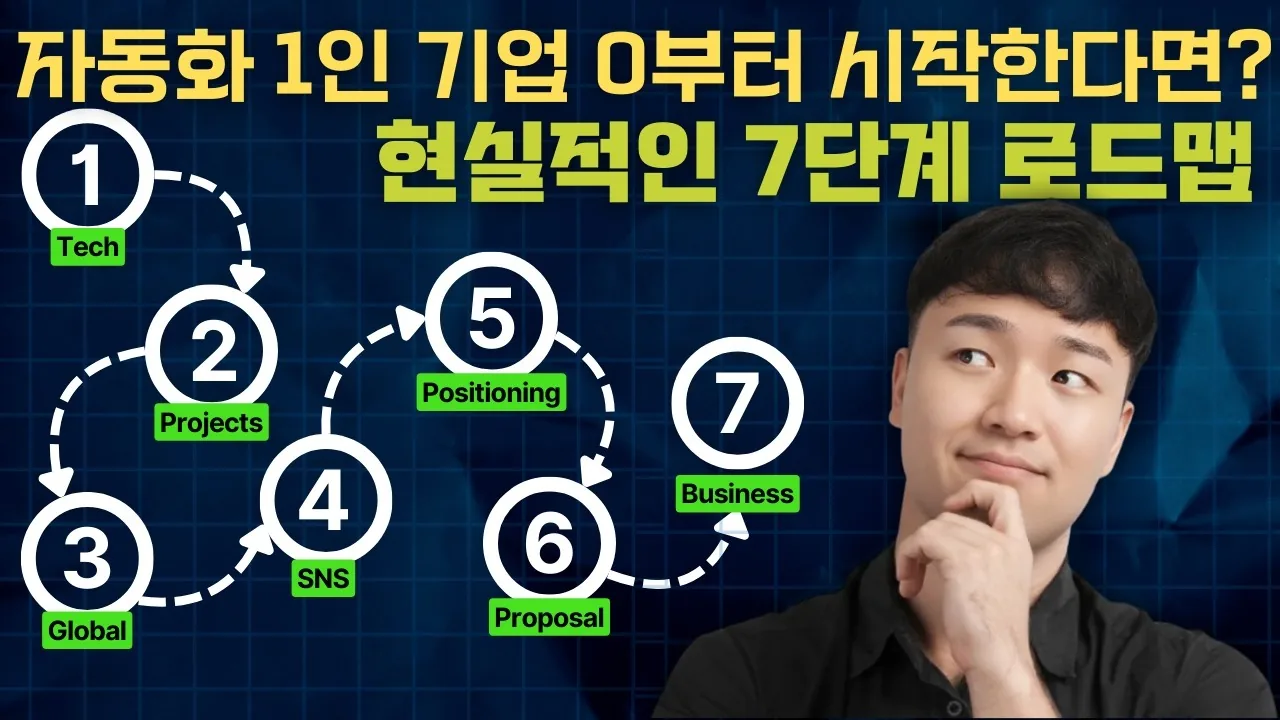
비전공자가 AI 자동화로 1인 기업 만드는 현실 로드맵 7단계 (학위도 부트캠프도 없이)
학위도 부트캠프도 없이 AI 자동화 부업에서 1인 기업까지 가는 7단계 로드맵. 기술 습득, 개인 프로젝트, 글로벌 인증, 과정 전시, 포지셔닝, 첫 실적을 만드는 오퍼 구조까지 순서대로 정리했습니다.
전체 과정 보기
Higgsfield API로 밈 영상 자동화하기, Genjutsu로 6편 만들어 본 과정과 한 편 비용
Higgsfield API와 Genjutsu로 레퍼런스 밈 영상에 제 사진을 넣어 새 밈을 자동으로 만든 과정을 정리했습니다. API 키 연결, 작업 폴더 구조, 검열 실패 사례, 최종 6편의 실제 비용표까지 담았습니다.
전체 과정 보기