RAG 검색 품질 진단: 청크 확인부터 하이브리드 검색·리랭커까지
RAG 검색 실패를 청크 원문과 정답 문서로 진단하는 방법입니다. 하이브리드 검색·리랭커·맥락 보완의 적용 조건을 설명하고, 제목 보존 전후를 비교하는 실행 코드와 결과로 연결합니다.
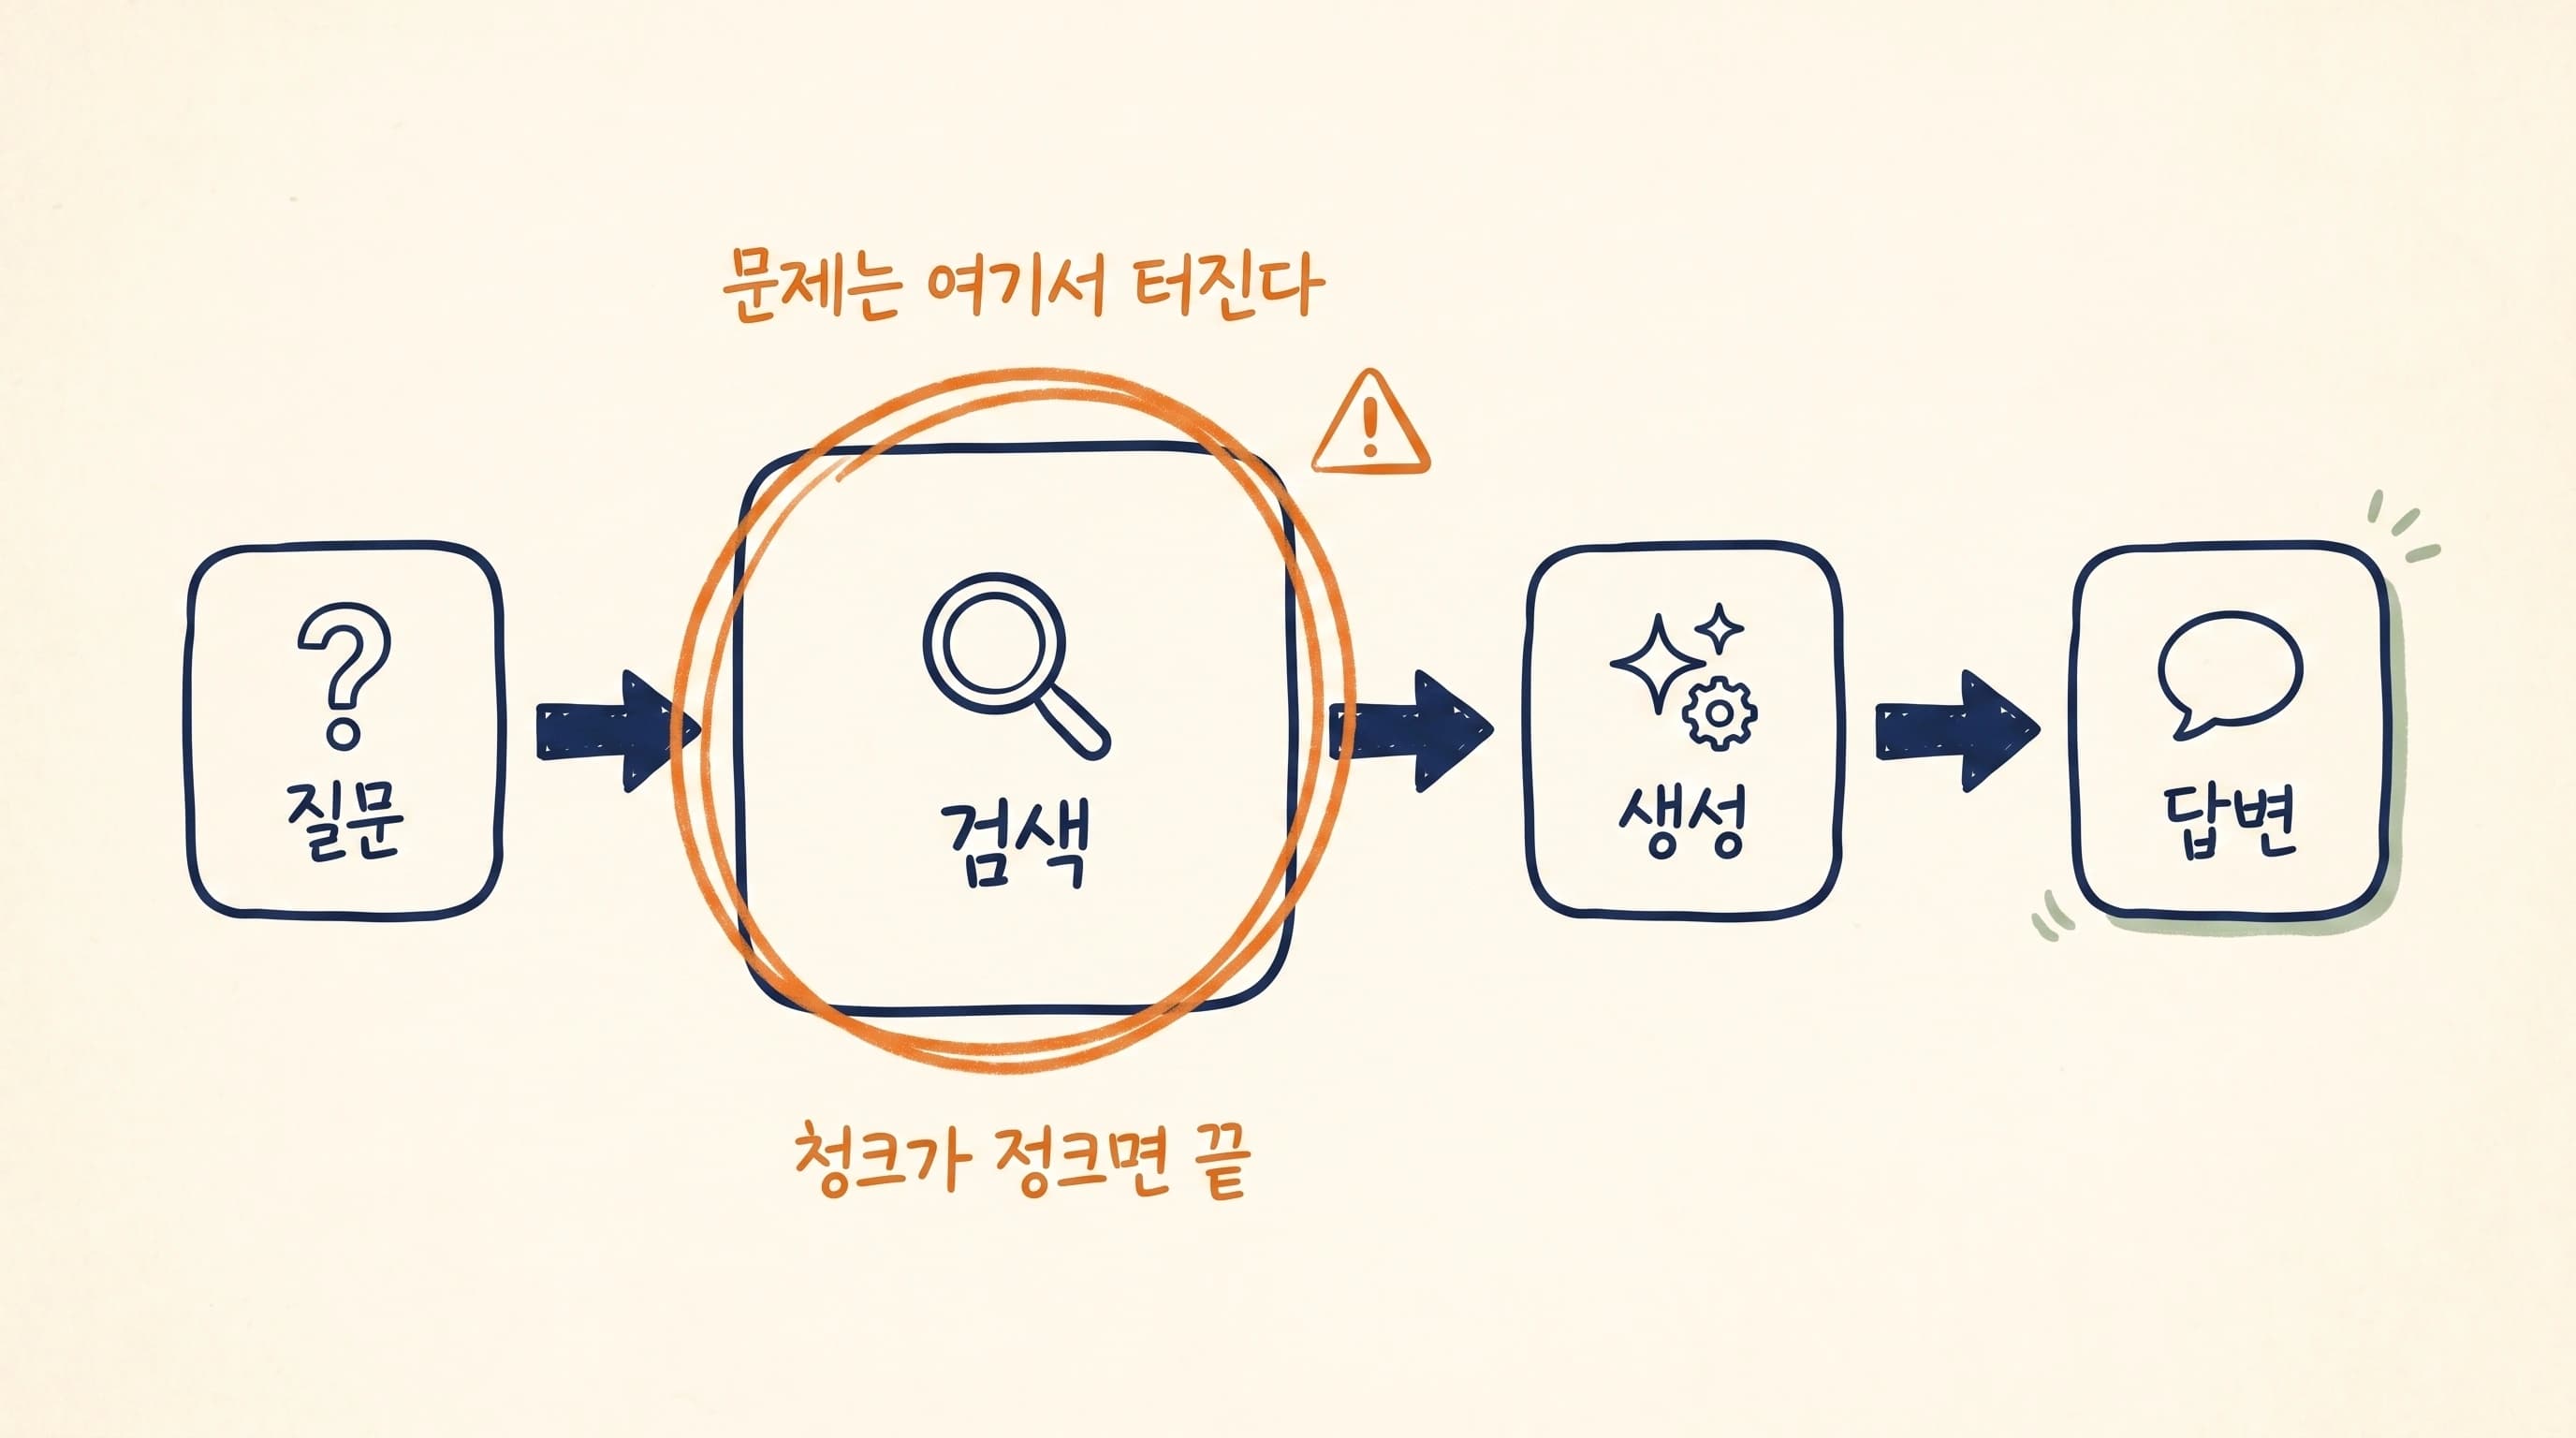
RAG를 처음 붙였을 때는 대체로 잘 돌아갑니다. 문서 스무 개로 만든 데모에서는 답변도 그럴듯하게 나옵니다. 하지만 검색 대상이 수백, 수천 개로 늘어나면 결과가 달라집니다.
지난 글에서는 RAG(검색 증강 생성)의 뼈대를 다뤘습니다. 문서를 청크로 자르고 임베딩으로 숫자화하고, vector database(벡터 데이터베이스)에서 비슷한 숫자 묶음을 찾는 구조입니다.
이번 글에서는 그다음 단계인 RAG 성능 개선을 정리합니다. 제가 3년 동안 RAG 프로젝트를 하면서 가장 많이 부딪힌 구간이기도 합니다.
사용 도구 및 준비물
검색된 원문부터 확인
제가 겪은 RAG 문제에서는 답변 생성보다 검색된 청크부터 확인하는 편이 원인을 찾기 쉬웠습니다. 엉뚱한 청크가 올라오면 생성 모델에 정답 근거가 전달되지 않기 때문입니다. 다만 올바른 근거를 찾고도 답을 잘못 만들 수 있으므로 검색과 생성을 따로 확인해야 합니다. 모든 RAG 오류가 검색에서 생긴다는 뜻은 아닙니다.
초기 디버깅에서는 자주 받는 질문 5개에서 10개를 먼저 고릅니다. 그리고 질문마다 검색된 청크를 1위부터 20위까지 직접 읽어봅니다. 그러면 "이 청크가 왜 3위에 있지", "이 정보가 왜 10위 안에 없지"와 같은 지점을 찾을 수 있습니다.
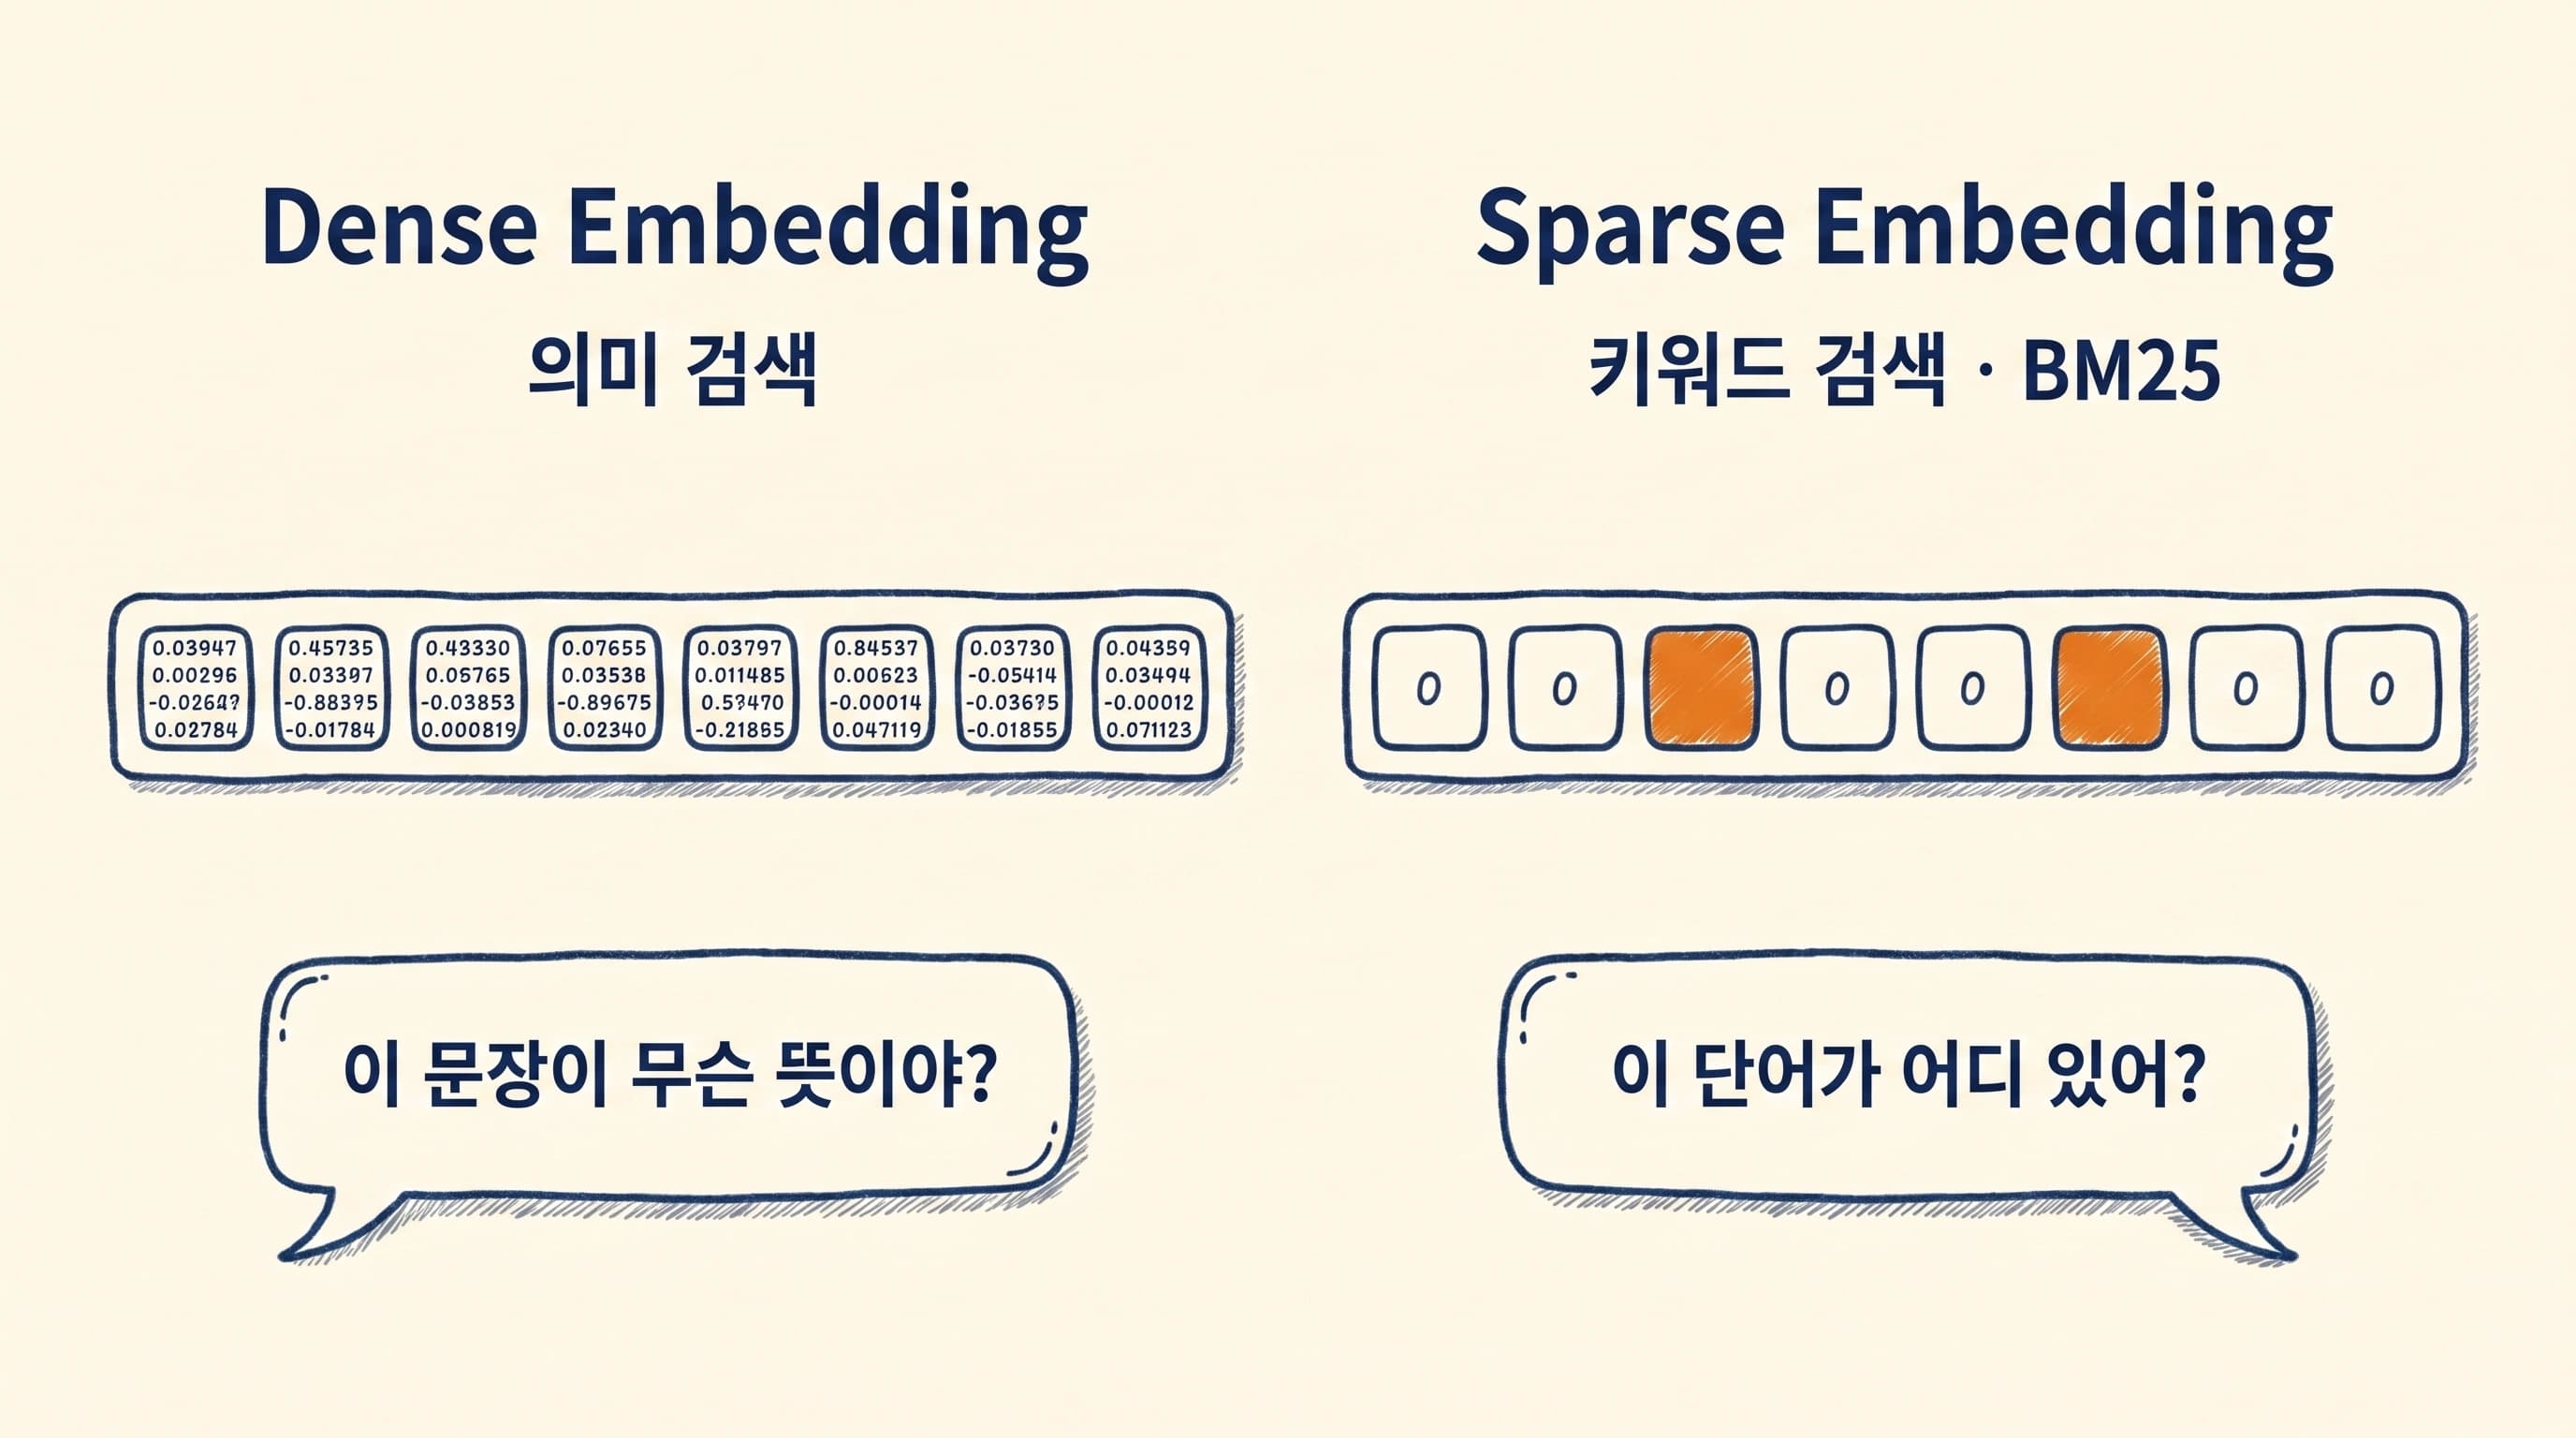
Dense와 Sparse 검색의 차이
Dense vector search는 텍스트를 수백~수천 개의 실수 값으로 표현하며 값 대부분이 0이 아닌 밀집 벡터를 사용합니다. 반면 BM25는 단어 출현 정보를 이용하는 lexical sparse retrieval(어휘 기반 희소 검색) 방식입니다. 최근에는 학습된 sparse embedding 모델도 있지만 이 글에서는 BM25 기반 키워드 검색을 기준으로 비교하겠습니다.
| 구분 | Dense vector search | Lexical sparse search(BM25) |
|---|---|---|
| 묻는 것 | 이 문장이 무슨 뜻인가 | 이 단어가 어디 있는가 |
| 강한 상황 | 표현이 달라도 의미가 같은 문서 | 약어·전문 용어 정확 매칭 |
| 약한 상황 | 도메인 특수 약어 | 동의어 표현 |
두 방식의 차이는 도메인 특수성이 강한 산업군에서 분명하게 나타납니다. 반도체 공정 문서에서 "CVD 챔버 온도 이상"을 검색하면 Dense는 온도 관련 공정 이슈라는 의미를 잡지만 CVD라는 약어 매칭에는 약합니다. Sparse는 CVD가 들어간 문서를 바로 찾습니다. "BW 전환청구권 행사 조건"과 같은 금융 문서도 마찬가지입니다. 제 경험상 이런 도메인에서는 전문 용어를 정확히 매칭하는 방식의 기여도가 더 높았습니다.
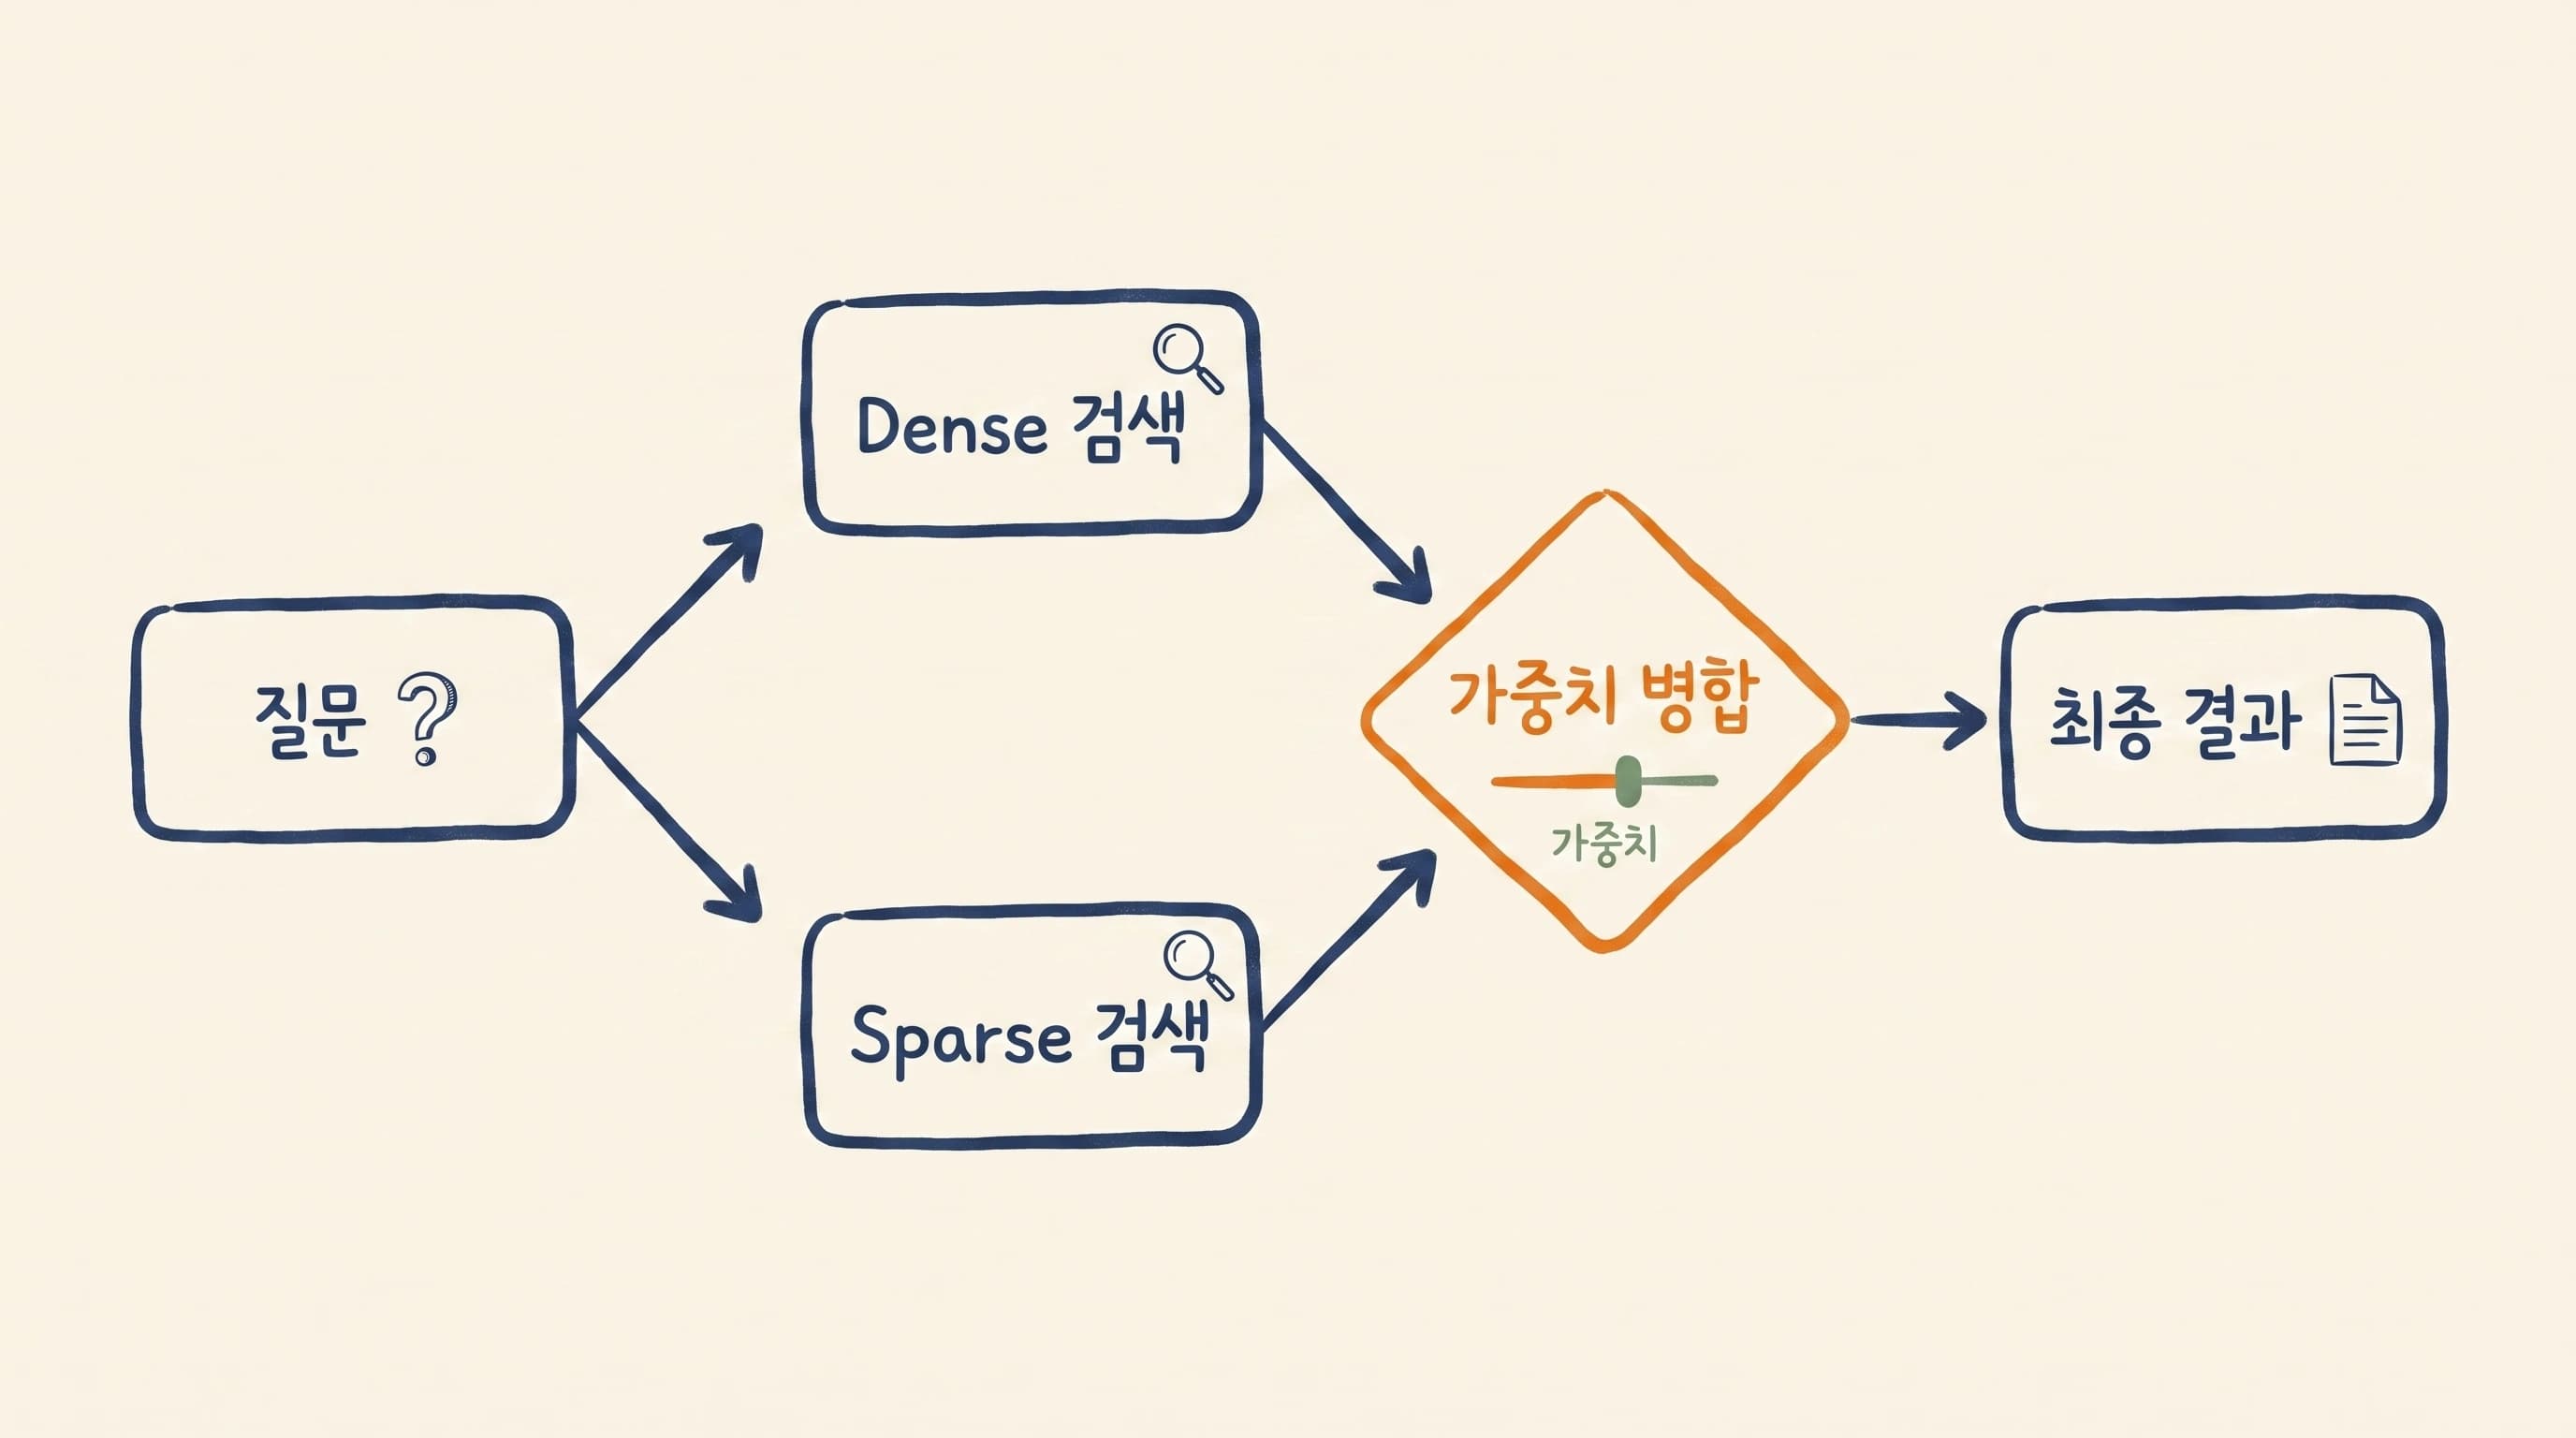
하이브리드 검색 결과 결합
Dense와 Sparse 검색을 함께 사용하는 방법이 hybrid search(하이브리드 서치)입니다. 두 검색을 동시에 실행한 뒤 결과를 합칩니다. 품질은 각 검색기의 후보 수, 점수 결합 방식, 가중치 또는 rank fusion 설정에 따라 달라집니다. 따라서 범용적인 고정 비율을 적용하기보다 실제 질문과 정답 청크로 평가 세트를 만들고 조정해야 합니다.
reranker(재정렬기) 적용: 소개팅 2차 만남
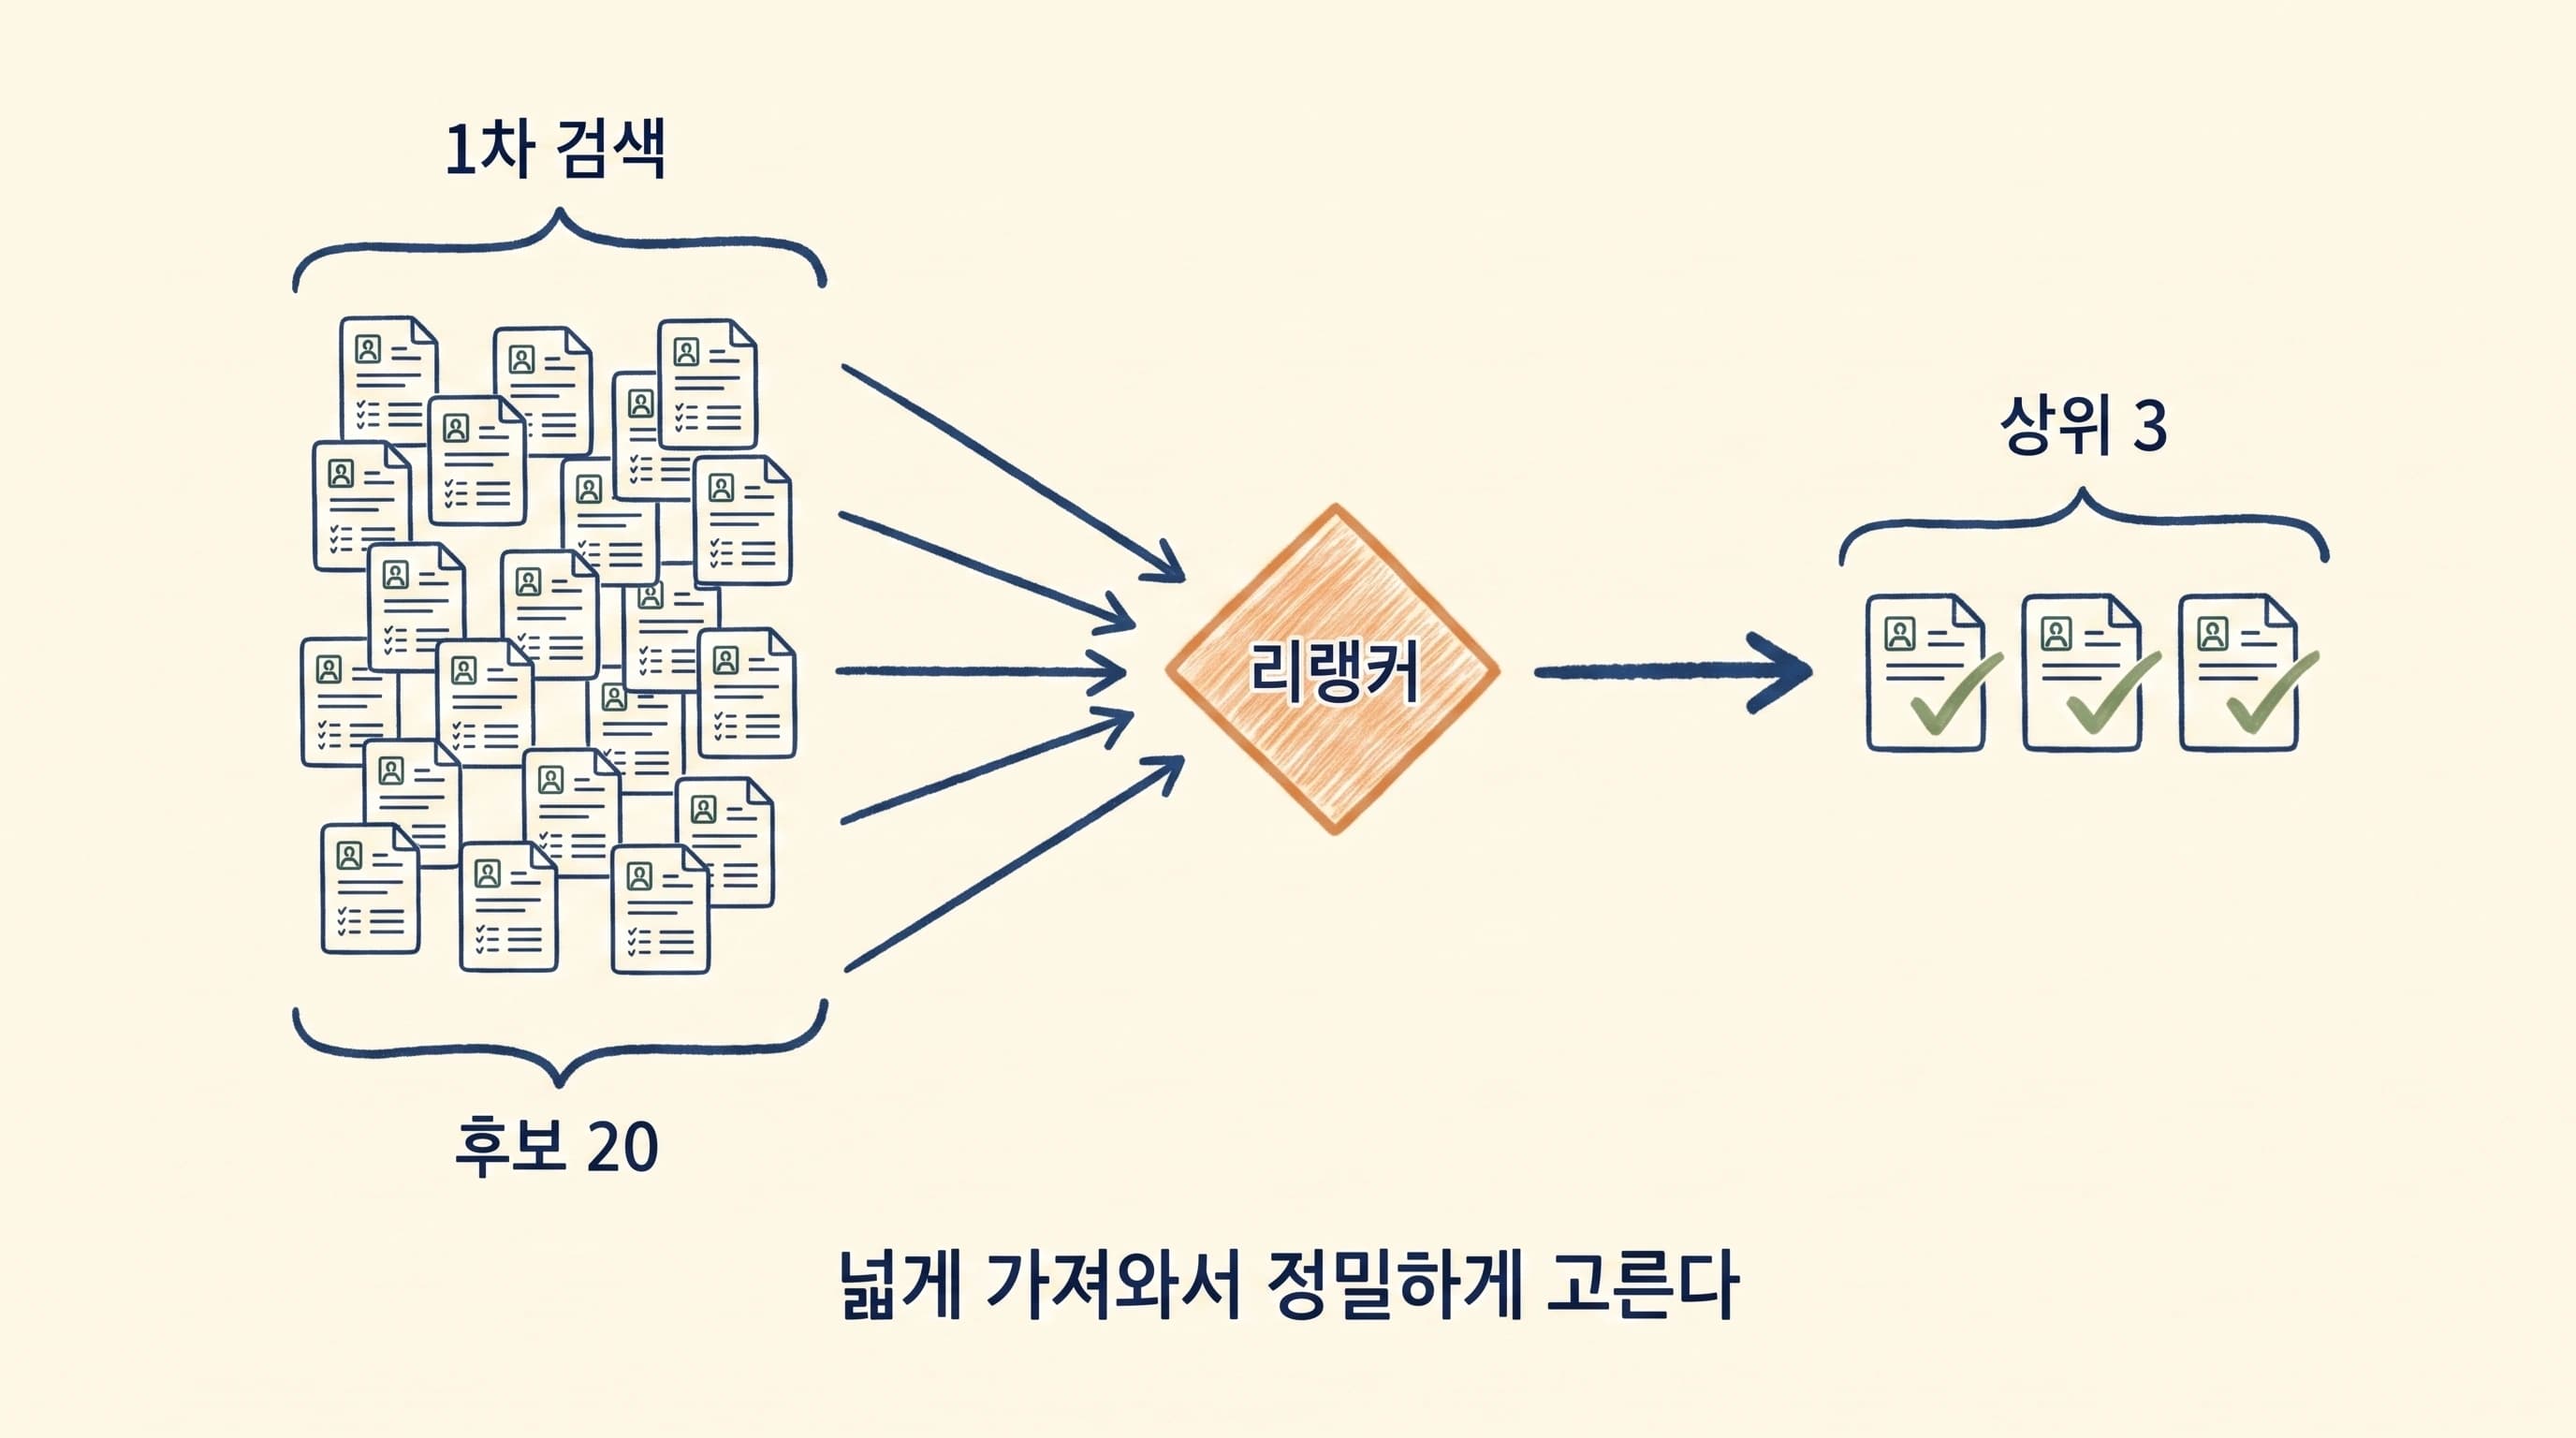
1차 품질을 올려도 후보군에는 노이즈가 남습니다. 여기서 reranker(재정렬기), 흔히 리랭커라고 부르는 단계가 들어갑니다. 넓게 가져온 후보를 질문과 나란히 놓고 다시 점수를 매깁니다.
소개팅으로 보면 1차 검색은 주선자가 조건에 맞는 후보 10명을 추려주는 단계입니다. 나이, 지역, 직업으로 넓게 거른 프로필만 본 상태죠. 성격이 맞는지는 직접 만나봐야 압니다. 그 10명 중 진짜 잘 맞는 3명을 골라내는 게 리랭커입니다.
다만 정확도를 높이는 대신 처리 속도가 느려집니다.
- 내 문서를 검색하는 개인 비서 용도라면 조금 느려져도 리랭커를 권합니다. 결과를 믿고 의사결정을 해야 하니 신뢰도가 우선입니다.
- 다수 사용자 대상 서비스는 다릅니다. 수백 명이 동시에 질문하는데 응답이 몇 초씩 밀리면 경험이 나빠집니다. 조건부 적용이나 더 가벼운 리랭킹이 필요합니다.
Contextual Retrieval 적용과 비용
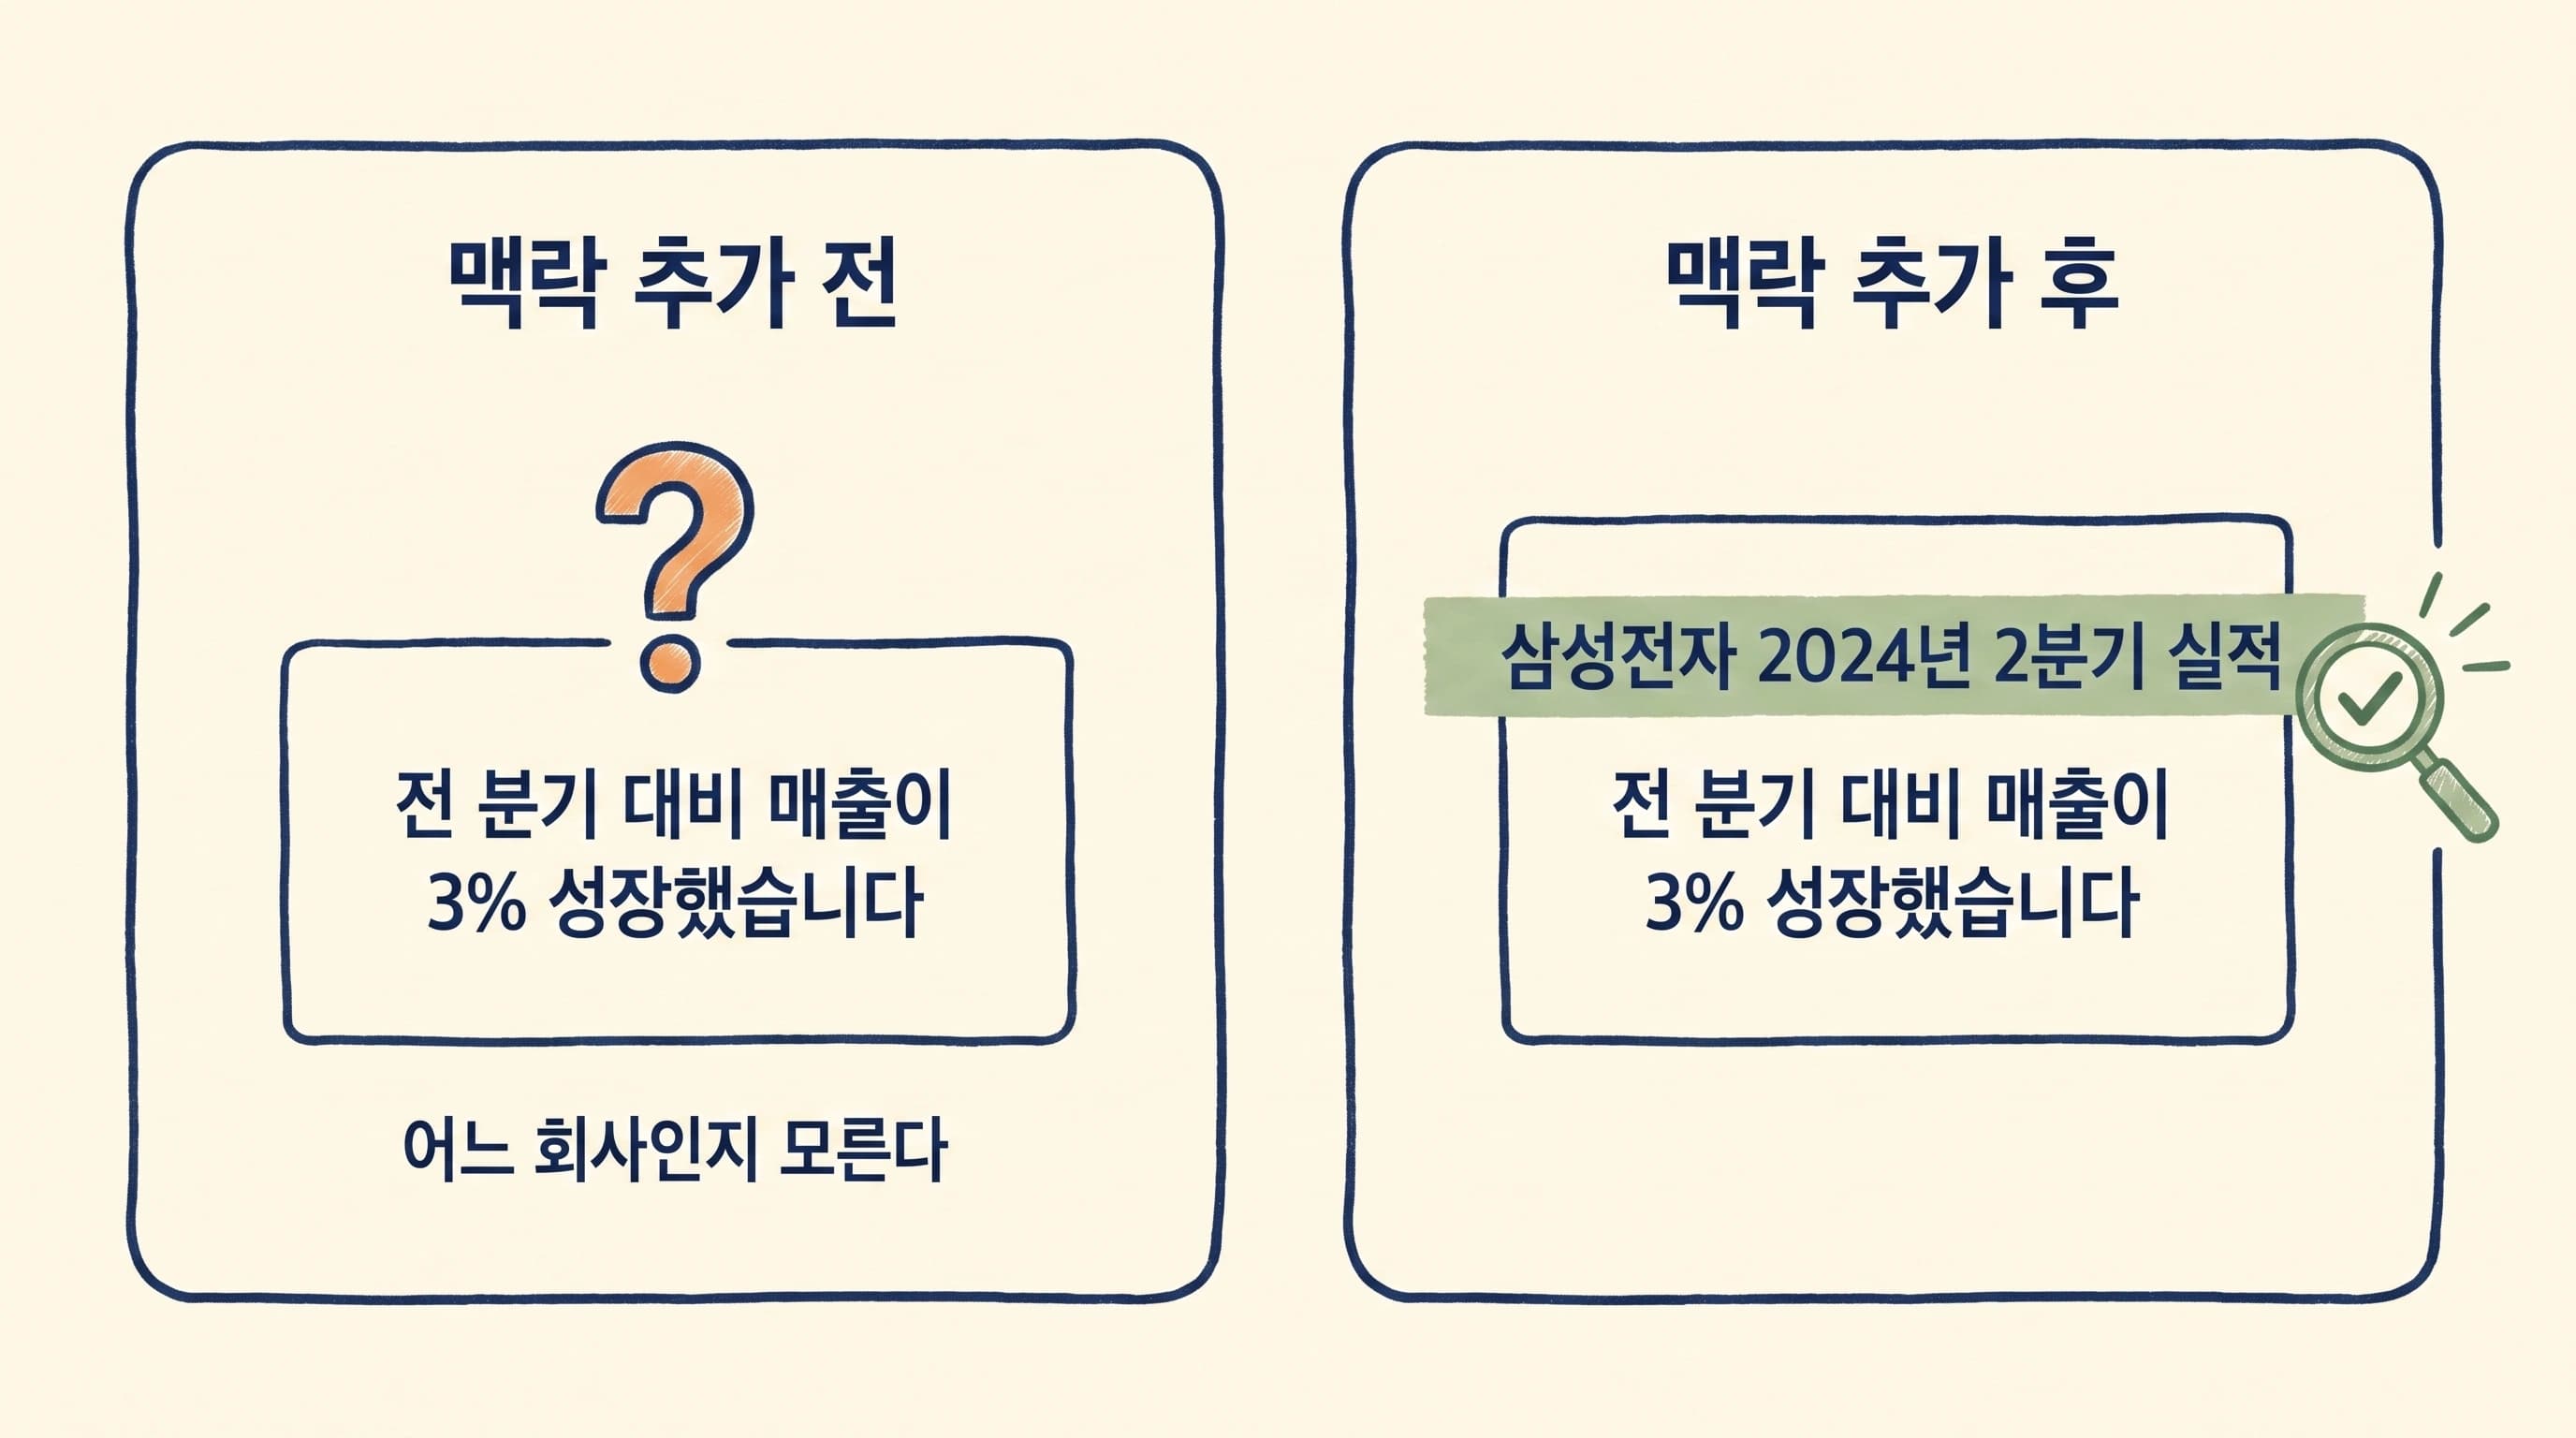
기본 RAG에서는 청킹할 때 맥락이 잘리는 문제가 있습니다. 재무 보고서를 나눈 뒤 "전 분기 대비 매출이 3% 성장했습니다"만 남은 청크가 생겼다고 가정해 보겠습니다. 이 문장만으로는 어느 회사의 어느 시점인지 알 수 없습니다. 앞에 있던 "삼성전자의 2024년 2분기 실적"이라는 맥락이 빠졌기 때문입니다.
Anthropic이 2024년 9월에 발표한 Contextual Retrieval은 이 문제를 보완하는 방법입니다. 청크를 임베딩하기 전에 LLM을 사용해 해당 청크가 문서의 어느 부분인지 설명하는 짧은 맥락을 붙입니다. Anthropic의 실험에서 Contextual Embeddings는 top-20 청크 검색 실패율을 5.7%에서 3.7%로 낮춰 35% 상대 감소를 보였습니다. Contextual BM25까지 결합했을 때는 2.9%로 49%, Cohere 리랭커를 더했을 때는 1.9%로 67% 감소했습니다. 코드베이스·소설·논문 등 Anthropic의 평가 데이터와 설정에서 나온 결과이므로 실제 프로젝트에서는 별도 평가가 필요합니다.
여기서 확인할 부분은 비용입니다. 청크마다 LLM을 호출하므로 청크 수만큼 처리량이 늘어납니다. Anthropic은 800토큰 청크, 8천토큰 문서, 100토큰 맥락과 prompt caching을 가정했을 때 맥락 생성의 일회성 비용을 문서 100만 토큰당 1.02달러로 계산했습니다. 실제 비용은 문서·청크 크기와 사용하는 모델에 따라 달라집니다. 제 프로젝트에서는 앞단에 판별 과정을 하나 더 넣었습니다. 청크 전부에 맥락을 붙이지 않고 의미 있는 정보를 담았는지 바이너리로 구분해 목차와 빈 서식을 걸러낸 뒤 적용했고, 해당 환경에서는 처리 비용을 줄일 수 있었습니다.
Late Chunking의 처리 순서
Contextual Retrieval이 청크에 맥락을 붙인다면, Late Chunking은 순서를 뒤집습니다. 문서 전체 또는 긴 컨텍스트 임베딩 모델이 처리할 수 있는 최대 범위를 먼저 Transformer에 통과시켜 토큰 임베딩을 만든 뒤, 미리 정한 청크 경계에 따라 pooling해 청크별 벡터를 만듭니다.
영화로 비유하면 일반 청킹은 장면별로 나눈 뒤 각각 요약하는 방식입니다. 앞뒤 장면을 알 수 없으므로 "그가 울었다"에서 그가 누구인지 파악하기 어렵습니다. Late Chunking은 더 긴 범위를 먼저 확인한 뒤 장면별 표현을 만듭니다. 문서 전체를 먼저 처리하는 전처리 비용이 들며 장거리 문맥 의존성이 있는 검색에서는 도움이 될 수 있습니다. 다만 논문에서도 데이터셋과 청크 크기에 따라 기본 청킹이 비슷하거나 더 좋은 경우가 있어 실제 검색 평가가 필요합니다.
원논문(Günther 외, 2024)의 숫자를 몇 개 옮기면 감이 옵니다. 먼저 논문의 첫 예시는 베를린 위키백과 문단입니다. "베를린"이라는 단어와 각 문장의 유사도를 일반 청킹과 Late Chunking으로 비교했습니다(jina-embeddings-v2-small).
| 문장 (요지) | 일반 청킹 | Late Chunking |
|---|---|---|
| 베를린은 독일의 수도이자 최대 도시다 | 0.8486 | 0.8495 |
| 그 도시의 인구는 385만 명이 넘는다 ("Its ...") | 0.7084 | 0.8249 |
| 이 도시는 독일의 주이기도 하다 ("The city ...") | 0.7535 | 0.8498 |
"베를린"이 직접 들어간 첫 문장은 둘 다 비슷하지만, "그 도시"라고만 쓴 문장은 Late Chunking에서 유사도가 0.1 안팎 올라갑니다. 앞 문장을 보고 나서 청크 벡터를 만들기 때문입니다.
벤치마크 평균은 생각보다 작습니다. 모델 3개 × 데이터셋 4개 평균으로 문장 경계 청킹에서 1.9%p, 고정 길이 청킹에서 1.8%p, 의미 기반 청킹에서 1.5%p 올랐습니다(상대 개선 2.7~3.6%). 그리고 긴 문서 독해형 데이터셋 일부에서는 청크를 크게 잡으면 일반 청킹이 더 좋았다고 논문 스스로 적고 있습니다. 위에서 "실제 검색 평가가 필요하다"고 쓴 근거가 이 부분입니다.
제목 보존 전후의 실행 결과
청크의 맥락이 왜 필요한지 확인할 수 있도록 제목 보존 전후 검색 실습을 추가했습니다. 가상 장비 문서 6개에 같은 단어 포함 검색을 적용하고 제목 사용 여부만 바꿨습니다. 정답이 있는 6문항의 top-1 적중은 2/6에서 5/6으로 달라졌습니다. 제목이 효과를 갖도록 설계한 작은 교육용 데이터의 결과이며 실제 고객 데이터나 임베딩 모델의 성능 개선율은 아닙니다.
실패한 질문도 함께 확인했습니다. ‘빛 장비 돌려주기’라는 동의어 질문은 두 방식 모두 후보가 없었고, 문서에 없는 ‘삼각대 신청’에는 두 방식 모두 잘못된 후보가 나왔습니다. 제목을 보존하는 것만으로는 의미 검색과 근거 부족 판정을 해결할 수 없었습니다.
그렇다면 점수 계산을 단순 단어 수 세기에서 BM25(단어 빈도·희귀도·문서 길이를 함께 보는 표준 키워드 점수)로 바꾸면 달라질까 싶어 같은 실습 데이터에 붙여 봤습니다. 임베딩 모델 없이 순수 파이썬으로 돌아가는 코드라 bm25_lab.py를 실습 폴더에 넣고 python bm25_lab.py로 바로 실행할 수 있습니다. 2026-10-02 실행 결과입니다.
body_only
  Q1 카메라 신청     expected=D1  top=D1  score=0.699  ties=3 hit
  Q2 마이크 신청     expected=D2  top=D1  score=0.699  ties=3 miss
  Q3 조명 신청      expected=D3  top=D1  score=0.699  ties=3 miss
  Q4 카메라 반납     expected=D4  top=D5  score=0.735  ties=1 miss
  Q5 마이크 반납     expected=D5  top=D5  score=0.735  ties=1 hit
  Q6 빛 장비 돌려주기  expected=D6  top=-   score=0      ties=0 miss
  Q7 삼각대 신청     expected=-   top=D1  score=0.699  ties=3 no-answer
title_and_body
  Q1~Q5            모두 hit (단독 1위)
  Q6 빛 장비 돌려주기  expected=D6  top=-   score=0      ties=0 miss
  Q7 삼각대 신청     expected=-   top=D1  score=0.995  ties=3 no-answer
BM25로 바꿔도 본문만 검색하면 2/6, 제목을 붙이면 5/6으로 적중 수는 그대로였습니다. 바뀐 건 어떤 오답을 고르느냐입니다. 본문만 검색할 때 Q4(카메라 반납)는 원래 동률에서 우연히 맞았는데, BM25는 문서 길이를 보정하면서 더 짧은 D5(마이크 반납)를 1위로 올려 틀렸습니다. 반대로 Q5는 같은 이유로 맞았습니다. 점수 공식을 바꿔도 잘린 맥락은 돌아오지 않고, 동의어(Q6)와 근거 없는 질문(Q7)은 키워드 방식으로는 여전히 풀리지 않았습니다. 이 두 실패를 해결하는 쪽이 Dense 검색과 근거 판정 단계이고, 하이브리드 검색을 쓰는 이유이기도 합니다.
입력·코드·검사·실행 결과 ZIP을 내려받거나 질문별 CSV를 열어 비교할 수 있습니다. CSV에는 동률 수와 실제 검색 텍스트도 있습니다. 본문 검색에서 정답을 맞힌 경우조차 동률 정렬 덕분일 수 있다는 점까지 확인해 보세요.
검색 방식 변경 전 진단 기록
새로운 기법을 추가하기 전에 같은 질문으로 전후를 비교할 기록을 만듭니다. 아래 내용은 실험 설계를 설명하기 위한 예시이며, 앞에서 소개한 프로젝트의 측정 결과는 아닙니다.
| 질문 유형 | 미리 지정할 정답 근거 | 검색이 실패했을 때 먼저 볼 것 |
|---|---|---|
| “CVD 챔버 온도 이상 대응은?” | CVD 장비별 대응 절차의 해당 문단 | 약어가 파싱 결과에 남아 있는지, 키워드 검색 후보에 들어오는지 |
| “지난 분기보다 얼마나 늘었나?” | 회사명·분기·수치가 함께 있는 표와 설명 | 청크에서 기간이나 표 머리글이 잘렸는지 |
| “폐기된 절차도 현재 적용되나?” | 최신 개정 문서와 적용일 | 검색 후보에 구버전이 섞였는지, 버전 필터가 작동하는지 |
| 문서에 없는 질문 | 정답 근거 없음 | 비슷한 문서를 근거로 없는 답을 만드는지 |
질문마다 검색 상위 후보의 문서 ID와 청크 원문을 저장합니다. 상위 5개를 보기로 했다면 실험 내내 같은 개수를 사용합니다. 5개는 설명을 위한 선택이지 권장 최적값이 아닙니다. 단일 정답 청크를 정한 질문 10개 중 7개에서 그 청크가 상위 5개에 있었다면, 이 작은 평가 세트의 적중 비율은 7/10입니다. 서비스 전체 정확도나 답변 정확도로 확대해서 읽으면 안 됩니다.
기록을 만든 다음에는 한 번에 변수 하나만 바꿉니다. 청킹을 바꿨다면 같은 문서로 색인을 다시 만들고, 검색 방식을 바꿨다면 같은 질문을 다시 넣습니다. 정답 청크가 후보에 없을 때는 리랭커만 붙여도 해당 청크를 되살릴 수 없습니다. 정답 청크가 후보에는 있지만 뒤로 밀린 경우에 재정렬을 시험합니다.
검색 결과가 좋아졌으면 답변의 근거 인용과 누락도 따로 봅니다. 질문별 검색 시간, 전체 응답 시간, 호출 비용을 함께 기록해야 작은 정확도 개선을 위해 감당하기 어려운 지연이 생기지 않았는지 판단할 수 있습니다. 여러 설정을 고르는 데 쓴 질문 외에, 따로 남겨둔 질문에서도 확인하세요.
입력 문서를 만드는 단계가 불분명하면 입문편의 세 문서 예제부터 시작하면 됩니다. 문서 수를 늘리기 전에 무엇을 정답으로 볼지 합의하는 데 쓸 수 있습니다.
"RAG is dead" 논쟁을 보는 기준
출발점은 코딩 에이전트입니다. Claude Code를 만든 Anthropic의 Boris Cherny는 초기 Claude Code에서 코드베이스 RAG를 시험했지만 최종적으로 glob·grep을 반복 사용하는 agentic search(에이전틱 서치)를 택했다고 설명했습니다. 내부 평가와 체감상 더 나았고 RAG 색인이 코드 변경과 어긋나는 문제, 보안·운영 복잡성도 이유였습니다. 공개된 범용 벤치마크 결과는 아니며 코드 검색이라는 특정 영역의 사례입니다.
이 결론을 모든 데이터에 그대로 적용하기는 어렵습니다. 계약서에서 "손해배상 관련 조항 찾아줘"라고 하면 grep만으로는 답을 찾기 어렵습니다. "배상 책임", "면책 사유", "위약금"처럼 의미로 연결된 표현을 검색해야 하기 때문입니다.
RAG 원논문의 공동 저자이자 Contextual AI CEO인 Douwe Kiela는 긴 컨텍스트에 필요 없는 정보까지 넣는 방식은 비효율적이며 검색 기반 접근은 답의 출처를 추적할 수 있다는 장점이 있다고 설명합니다. 비용 차이는 데이터 규모와 캐시, 모델 가격에 따라 크게 달라집니다. 예를 들어 검색 솔루션 업체 LightOn은 1,000페이지 지식 베이스와 하루 1,000회 요청 등을 가정한 자사 계산에서 RAG가 긴 컨텍스트 방식보다 8~82배 저렴하다고 추산했습니다. 이 값은 보편적인 연구 결과가 아니라 특정 가정의 비용 시뮬레이션입니다. Chroma CEO Jeff Huber도 별도의 Latent Space 인터뷰에서 "RAG"를 하나의 기법처럼 다루기보다 dense·lexical·filter·rerank 같은 검색 구성 요소를 분리해 데이터로 평가해야 한다고 강조했습니다.
제 경험에서도 초기에는 벡터 검색만 붙여 사용했지만, 제가 맡았던 문서 검색 프로젝트에서는 하이브리드 서치, 리랭킹, 메타데이터 필터링을 필요에 따라 조합하는 편이 도움이 됐습니다. 모든 서비스에 세 가지를 함께 넣어야 한다는 뜻은 아닙니다. RAG가 사라졌다기보다 요구 수준이 높아졌다고 보는 편이 맞습니다. 구조화된 데이터 영역에서는 에이전틱 서치가 RAG를 대체할 수 있습니다. 제가 다룬 사내 비정형 문서 질의응답에서는 검색과 근거 확인이 여전히 중요한 역할을 합니다.
작성일 기준 내용이라 도구와 모델 정보는 달라질 수 있습니다. 기초 개념이 흔들린다면 상편인 RAG 개념 입문 글부터 읽고 오시면 이 글의 판단 기준이 더 선명하게 잡힐 겁니다.
Reference
추가 학습 자료 신청
ZEXEA 메인 사이트의 자료 신청 페이지로 이동합니다. 이름·이메일·전화번호 등의 입력이 필요합니다. 블로그 글과 실습 예제는 신청 없이 모두 읽을 수 있습니다.
관련 가이드
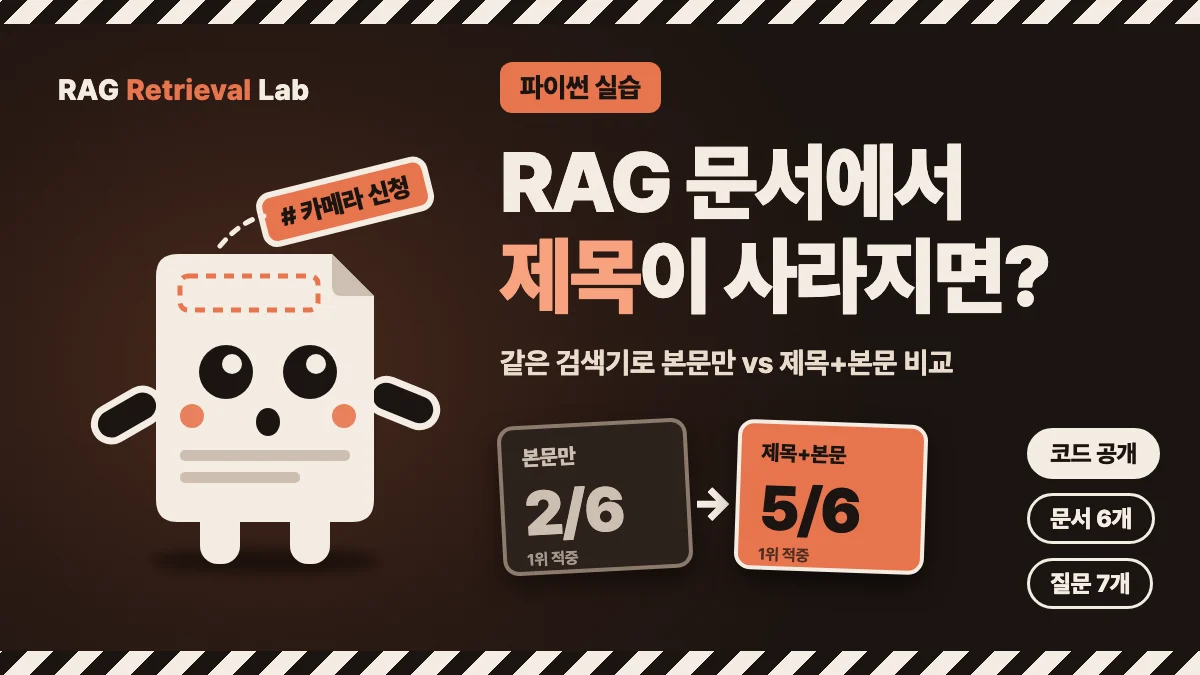
RAG 문서에서 제목이 사라지면? 같은 검색기로 비교하는 파이썬 실습
가상 장비 문서 6개와 질문 7개로 제목 보존 전후의 검색 결과를 비교합니다. 실행 코드·입력 데이터·결과 CSV를 공개하고, 동의어와 정답 없는 질문에서 남는 실패까지 확인합니다.
전체 과정 보기
RAG란 무엇인가, 오픈북 시험 비유로 이해하는 핵심 개념 (임베딩·청킹·벡터DB)
RAG란 무엇인지 오픈북 시험 비유로 정리했습니다. 임베딩이 텍스트를 숫자로 바꾸는 원리, 청킹과 Parser가 검색 품질을 가르는 이유, 벡터 데이터베이스의 유사도 검색까지 3년 RAG 프로젝트 경험으로 풀었습니다.
전체 과정 보기
Claude Code 프론트엔드 디자인 도구 5종, AI 티 나는 웹사이트를 고치는 스킬·CLI 사용법
Claude Code로 만든 웹사이트의 AI 티를 줄이는 디자인 도구 5종. Awesome DESIGN.md, Taste Skill, Image to Code, Playwright CLI, Vercel 규칙 스킬의 정체와 설치법, 쓰는 시점, 직접 돌려본 결과를 정리했습니다.
전체 과정 보기