RAG 문서에서 제목이 사라지면? 같은 검색기로 비교하는 파이썬 실습
가상 장비 문서 6개와 질문 7개로 제목 보존 전후의 검색 결과를 비교합니다. 실행 코드·입력 데이터·결과 CSV를 공개하고, 동의어와 정답 없는 질문에서 남는 실패까지 확인합니다.
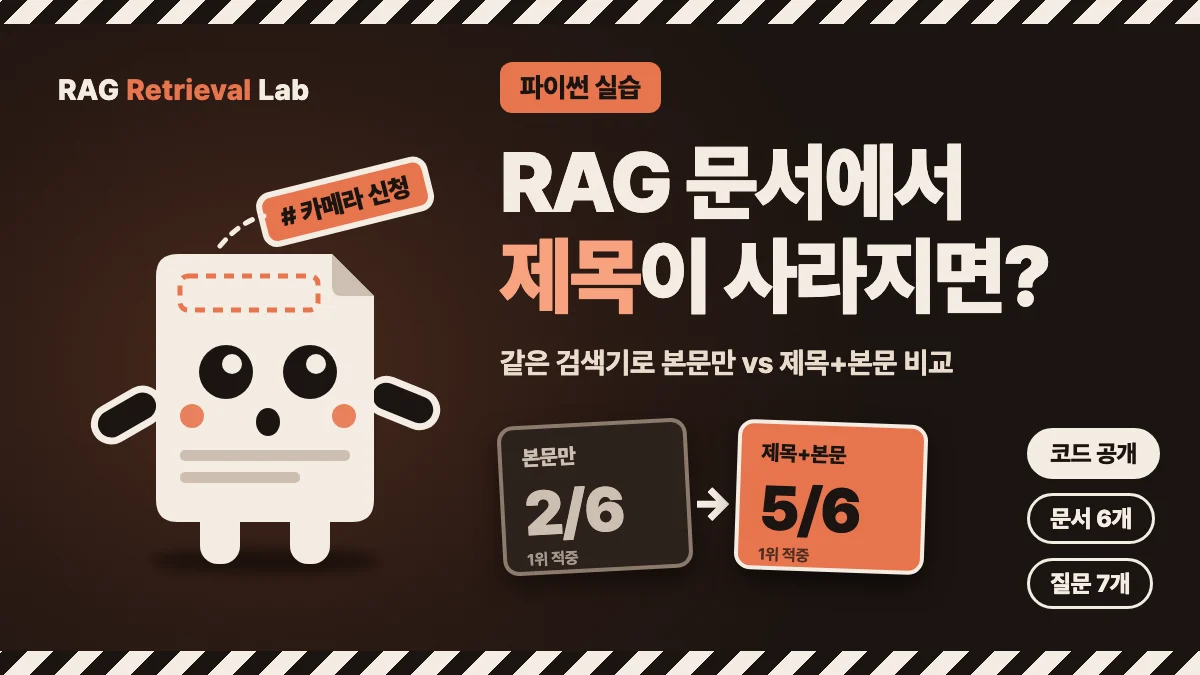
검색된 문장에 “이틀 전에 신청합니다”라고만 적혀 있다면 무엇을 신청하는지 알 수 없습니다. 원래 문서에 있던 ‘카메라 신청’이라는 제목이 청크를 만드는 과정에서 빠진 경우를 생각할 수 있습니다. 이때는 더 큰 모델을 붙이기 전에 검색에 들어간 텍스트부터 확인해야 합니다.
RAG 검색 품질 글에서 설명한 맥락 손실을 작은 코드로 확인하는 실습입니다. 새로 만든 가상 문서에 두 가지 입력 방식을 적용해 직접 실행했습니다. 고객 프로젝트나 기존 영상의 성과를 재현한 벤치마크는 아닙니다. 검색에 쓸 텍스트 한 가지 조건만 바꾸고, 결과가 달라지는 이유를 눈으로 확인하는 것이 목적입니다.
사용 도구 및 준비물
1. 실습 파일 준비
이메일이나 회원가입 없이 내려받을 수 있습니다. 코드를 실행하기 전에 결과부터 확인하려면 질문별 결과 CSV와 집계 JSON을 열면 됩니다. CSV에는 점수와 함께 실제 검색된 문장도 들어 있습니다.
ZIP에는 다음 파일이 있습니다.
| 파일 | 역할 |
|---|---|
| fixture.json | 가상 문서 6개와 질문 7개, 예상 정답 문서 ID |
| compare.py | 본문만 검색 / 제목과 본문을 함께 검색하는 코드 |
| results.csv | 질문마다 두 방식의 후보·점수·동률 수·검색 원문 |
| summary.json | 정답 문서 적중과 정답 없는 질문의 결과를 분리한 집계 |
| test_compare.py | 빈 질문, 점수 동률, 제목 사용 범위 등을 확인하는 검사 |
| README.md | 실행 방법과 결과의 적용 범위 |
Python 3.11 이상이 필요합니다. 공개 결과는 Windows 11, Python 3.11.15에서 2026년 9월 5일 실행한 것입니다. GPU나 API 키를 사용하지 않고, 인터넷에 문서를 전송하지 않습니다. 임베딩 모델이나 BM25의 우열을 비교하는 실습도 아닙니다.
2. 제목을 제외한 입력 문서 확인
문서는 카메라·마이크·조명의 신청과 반납을 각각 분리한 6개입니다. 예를 들어 입력 데이터의 D2는 다음과 같습니다.
{
  "id": "D2",
  "title": "마이크 신청",
  "body": "신청은 사용 당일에도 접수합니다. 외부 반출에는 담당자 확인이 필요합니다."
}
본문만 보면 카메라 규정인지 마이크 규정인지 구별할 수 없습니다. D1은 카메라 신청, D3은 조명 신청이지만 두 문서의 본문에도 ‘신청’이 들어 있습니다. 따라서 ‘마이크 신청’을 검색할 때 ‘신청’이라는 단어만으로는 세 문서를 나누기 어렵습니다.
이 문제를 관찰하기 위해 제목에 있던 장비명을 본문에는 반복하지 않았습니다. 제목의 효과가 드러나도록 설계한 교육용 데이터이므로 실제 사내 문서보다 조건이 단순합니다. 이 구성 자체가 결과에 유리한 가정이라는 점도 함께 읽어야 합니다.
3. 같은 검색기로 두 조건 실행
ZIP을 새 폴더에 풀고 compare.py가 있는 폴더에서 터미널을 엽니다.
python compare.py
python -m unittest -v
첫 번째 명령을 실행하면 결과 CSV와 JSON을 같은 폴더에 덮어씁니다. 입력 파일은 변경하지 않습니다. 그다음 명령은 함께 제공한 검사 4개를 실행합니다. python을 찾을 수 없다는 메시지가 나오면 Python 설치 여부와 터미널의 실행 경로를 먼저 확인합니다.
공개한 ZIP을 새 폴더에 풀어 두 명령을 그대로 실행한 화면입니다(2026-10-02 다시 실행, macOS, Python 3.13.3). 원래 실습은 Python 3.11에서 만들었는데 3.13에서도 결과가 같았습니다.
$ python compare.py
{
  "body_only": {
    "answerable_top1_hits": 2,
    "answerable_questions": 6,
    "unanswerable_false_candidates": 1,
    "unanswerable_questions": 1
  },
  "title_and_body": {
    "answerable_top1_hits": 5,
    "answerable_questions": 6,
    "unanswerable_false_candidates": 1,
    "unanswerable_questions": 1
  }
}

$ python -m unittest -v
test_fixture_keeps_unresolved_cases_visible ... ok
test_tie_break_is_independent_of_input_order ... ok
test_title_is_not_used_in_body_only ... ok
test_unrelated_and_empty_query_return_no_candidates ... ok

----------------------------------------------------------------------
Ran 4 tests in 0.000s

OK
첫 출력의 answerable_top1_hits가 정답 질문 6개 중 1위 적중 수입니다. 본문만 검색하면 2, 제목을 붙이면 5가 찍히면 이 글과 같은 결과가 재현된 것입니다. 검사 4개는 각각 "정답 없는 질문을 숨기지 않는다", "입력 순서가 바뀌어도 동률 처리 결과가 같다", "본문 모드에서 제목을 쓰지 않는다", "관계없는 질문과 빈 질문에는 후보를 내지 않는다"를 확인합니다. (테스트 이름은 실제 출력에서 클래스 경로를 줄였습니다.)
검색 규칙은 일부러 간단하게 두었습니다. 질문을 띄어쓰기 기준으로 나누고 각 단어가 문서에 포함되면 1점을 더합니다. 대소문자는 구분하지 않습니다. 중복된 질문 단어는 한 번만 세고, 점수가 같으면 문서 ID 순서로 정렬합니다. 0점 문서는 후보에서 제외합니다.
두 방식의 차이는 아래 조건문입니다.
text = document['body']
if include_title:
    text = document['title'] + '\n' + text
형태소 분석이나 동의어 사전은 없습니다. 따라서 이 검색기의 점수는 관련성을 보장하는 확률이 아닙니다. 특히 동률인 경우 첫 문서가 반환됐다고 더 적합하다고 해석하면 안 됩니다.
4. 실행 결과 확인
정답 문서가 존재하는 질문 6개에서 1위 문서가 정답과 일치한 경우는 본문만 검색할 때 2개, 제목을 붙였을 때 5개였습니다. 정답 문서가 없는 질문 1개는 두 방식 모두 잘못된 후보를 반환했습니다.
| 질문 | 기대 문서 | 본문만 | 제목+본문 |
|---|---|---|---|
| Q1 카메라 신청 | D1 | D1 · 적중 | D1 · 적중 |
| Q2 마이크 신청 | D2 | D1 · 실패 | D2 · 적중 |
| Q3 조명 신청 | D3 | D1 · 실패 | D3 · 적중 |
| Q4 카메라 반납 | D4 | D4 · 적중 | D4 · 적중 |
| Q5 마이크 반납 | D5 | D4 · 실패 | D5 · 적중 |
| Q6 빛 장비 돌려주기 | D6 | 후보 없음 | 후보 없음 |
| Q7 삼각대 신청 | 없음 | D1 · 잘못된 후보 | D1 · 잘못된 후보 |
CSV에서 Q2를 확인해 보겠습니다. 본문만 검색하면 ‘신청’ 때문에 D1·D2·D3이 동률로 나옵니다. 문서 ID 순서로 D1을 선택하는 규칙에 따라 오답이 됩니다. 제목을 붙인 경우에는 D2에 ‘마이크’와 ‘신청’이 모두 있으므로 단독 1위가 됩니다. 이 차이는 top_tie_count에서 확인할 수 있습니다.
results.csv에서 Q2 두 줄만 그대로 옮기면 다음과 같습니다.
query_id,question,mode,expected,predicted,score,top_tie_count,correct,...
Q2,마이크 신청,body_only,D2,D1,1,3,False,...
Q2,마이크 신청,title_and_body,D2,D2,2,1,True,...
본문만 검색한 줄은 score 1점에 top_tie_count가 3입니다. 1점짜리 문서 셋(D1·D2·D3)이 공동 1위였고 ID 순서로 D1이 뽑혔다는 뜻입니다. 제목을 붙인 줄은 2점 단독 1위(top_tie_count 1)라서 결과를 믿을 근거가 생깁니다. 적중 여부(correct) 열만 보지 말고 이 두 열을 같이 봐야 하는 이유입니다.
반대로 Q1의 본문 검색 적중은 ‘카메라’를 이해해서 얻은 결과가 아닙니다. 동률에서 우연히 정답의 ID가 앞섰습니다. 정답 개수만 읽으면 놓치는 부분입니다. 본문만 검색한 2/6을 안정적인 검색 능력으로 해석해서는 안 됩니다.
5. 제목을 보존한 뒤에도 남은 실패
Q6의 ‘빛 장비 돌려주기’는 사람이 읽으면 조명 반납과 연결할 수 있습니다. 하지만 문서에는 그 표현이 그대로 없습니다. 제목을 붙여도 단순 단어 검색이 의미를 이해하게 되지는 않습니다. 의미 검색이나 동의어 처리를 비교해 볼 후속 질문으로 남길 수 있습니다.
Q7에서는 문서에 삼각대가 없는데도 ‘신청’이 겹쳐 D1이 나옵니다. 이 결과로 바로 답변을 생성하면 카메라 규정을 삼각대에 잘못 적용할 수 있습니다. 검색 후보가 나온 것만으로 답변 근거가 있다고 판단하면 안 됩니다.
이 실습은 LLM을 실행하지 않아 답변 생성이나 환각을 측정하지 않았습니다. Q7에서 확인한 것은 정답이 없는 질문에도 검색기가 후보를 반환했다는 사실까지입니다. 실제 서비스에서는 근거가 충분한지 판별하는 단계와 정보가 없을 때 답을 보류하는 동작을 따로 검증해야 합니다.
6. 실제 문서에 적용하는 순서
실제 문서에 적용할 때는 정답부터 정합니다. 자주 받는 질문과 답이 들어 있는 문서 ID를 적고, 제목 없이 읽어도 대상·기간·조건을 이해할 수 있는지 확인합니다. 파일 이름, 장 제목, 표 머리글이 빠졌을 때 문장의 의미가 달라지는 구간부터 찾으면 됩니다.
제공 데이터의 단어만 바꾼 뒤 결과가 좋아졌다고 판단하면 안 됩니다. 일상적인 표현의 질문, 정답이 없는 질문, 오래된 규정과 최신 규정이 함께 있는 경우를 추가해야 합니다. 설정을 고르는 데 사용하지 않은 질문도 따로 남겨 비교합니다. 실제 임베딩 검색기를 붙일 때는 문서·질문·후보 수를 고정하고 입력 텍스트만 바꿔야 결과 차이를 해석하기 쉽습니다.
Anthropic의 Contextual Retrieval 설명도 잘린 청크의 맥락을 보완하는 문제를 다룹니다. 다만 이 글은 기존 제목을 붙였을 뿐이며, LLM이 청크별 맥락을 만드는 해당 기법을 구현하거나 논문의 성능을 재현한 것은 아닙니다.
검색 구조 자체가 낯설다면 RAG 개념 입문부터, 실제 검색 구성을 바꾸려면 하이브리드 검색과 리랭커의 적용 기준을 이어서 읽어보세요. 이번 실습에서 남긴 질문별 실패 기록이 다음 비교의 출발점입니다.
실행 근거와 Reference
이 글의 2/6·5/6 수치는 제공한 입력 데이터를 비교 코드로 실행한 결과 집계입니다. 아래 외부 자료의 성능 수치를 가져온 것이 아닙니다.
- Python 정렬 안내: 비교 코드의 정렬 키를 이해할 때 참고합니다. 코드에서는 점수 내림차순 뒤 문서 ID 오름차순을 명시합니다.
- Anthropic Contextual Retrieval: 문맥을 잃은 청크라는 문제를 더 깊게 다룹니다. 이 실습의 제목 연결 방식과는 구현 범위가 다릅니다.
추가 학습 자료 신청
ZEXEA 메인 사이트의 자료 신청 페이지로 이동합니다. 이름·이메일·전화번호 등의 입력이 필요합니다. 블로그 글과 실습 예제는 신청 없이 모두 읽을 수 있습니다.
관련 가이드
RAG란 무엇인가, 오픈북 시험 비유로 이해하는 핵심 개념 (임베딩·청킹·벡터DB)
RAG란 무엇인지 오픈북 시험 비유로 정리했습니다. 임베딩이 텍스트를 숫자로 바꾸는 원리, 청킹과 Parser가 검색 품질을 가르는 이유, 벡터 데이터베이스의 유사도 검색까지 3년 RAG 프로젝트 경험으로 풀었습니다.
전체 과정 보기
RAG 검색 품질 진단: 청크 확인부터 하이브리드 검색·리랭커까지
RAG 검색 실패를 청크 원문과 정답 문서로 진단하는 방법입니다. 하이브리드 검색·리랭커·맥락 보완의 적용 조건을 설명하고, 제목 보존 전후를 비교하는 실행 코드와 결과로 연결합니다.
전체 과정 보기
Claude Code 프론트엔드 디자인 도구 5종, AI 티 나는 웹사이트를 고치는 스킬·CLI 사용법
Claude Code로 만든 웹사이트의 AI 티를 줄이는 디자인 도구 5종. Awesome DESIGN.md, Taste Skill, Image to Code, Playwright CLI, Vercel 규칙 스킬의 정체와 설치법, 쓰는 시점, 직접 돌려본 결과를 정리했습니다.
전체 과정 보기