RAG란 무엇인가, 오픈북 시험 비유로 이해하는 핵심 개념 (임베딩·청킹·벡터DB)
RAG란 무엇인지 오픈북 시험 비유로 정리했습니다. 임베딩이 텍스트를 숫자로 바꾸는 원리, 청킹과 Parser가 검색 품질을 가르는 이유, 벡터 데이터베이스의 유사도 검색까지 3년 RAG 프로젝트 경험으로 풀었습니다.
RAG는 질문에 필요한 문서를 먼저 찾은 다음, 해당 내용을 근거로 답변을 만드는 구조입니다. 이번 글에서는 사내 문서 검색이나 개인 지식 도우미를 처음 만드는 분을 기준으로 RAG의 기본 구조를 정리합니다. 검색 품질을 개선하는 방법은 RAG 검색 품질 진단 글에서 따로 다루겠습니다.
사용 도구 및 준비물
"RAG는 죽었다"는 말의 의미
링크드인이나 X 타임라인을 보면 "RAG는 죽었다"는 문장이 자주 보입니다. RAG(검색 증강 생성)가 사라졌다기보다, 벡터 검색만 단순하게 붙여 사용하던 방식의 한계가 드러났다는 의미에 가깝습니다. 코딩 에이전트 영역에서는 맞는 부분이 있지만, 특히 최신 사내 문서나 근거 인용이 필요한 질의응답에서는 검색 단계를 여전히 검토할 가치가 있습니다. 모든 AI 시스템에 RAG가 필요한 것은 아닙니다.
이 논쟁을 판단하려면 RAG란 어떤 부품으로 조립된 구조인지부터 알아야 합니다. 저는 3년 동안 RAG 프로젝트를 주기적으로 진행했고 최근 강의를 준비하면서 수강생 온보딩용으로 기초 개념을 정리해 두었습니다. 이 글은 그 정리본을 다시 쓴 것으로, RAG의 정의와 임베딩, 청킹과 Parser, 벡터 데이터베이스까지 파이프라인 앞단을 다룹니다.
오픈북 시험으로 이해하는 RAG 구조
RAG는 Retrieval Augmented Generation의 약자입니다. 검색한 자료로 AI의 답변 능력을 보강한다는 뜻이죠.
대학교 시험을 예로 들어보겠습니다. Closed Book 시험은 기억에만 의존하기 때문에 모르는 내용은 답하기 어렵습니다. 오픈북 시험은 교재를 참고할 수 있으므로 "교재 45페이지에 따르면"과 같이 근거를 확인하면서 답을 쓸 수 있습니다. 여기서 LLM(대규모 언어 모델)은 공교육을 받은 기초 지식, 즉 Foundation Model에 해당합니다. RAG는 이 LLM이 외부 자료를 참고할 수 있도록 만드는 장치입니다.
처리 순서는 질문 입력, 관련 문서 검색, 검색된 문서를 참고한 답변 생성으로 이어집니다. 모델 파라미터만으로는 학습 이후에 바뀐 정책이나 비공개 사내 문서를 안정적으로 참조하기 어렵습니다. 이때 필요한 외부 자료를 검색해 컨텍스트에 넣는 방법이 RAG입니다.
마트의 상품 위치로 이해하는 임베딩
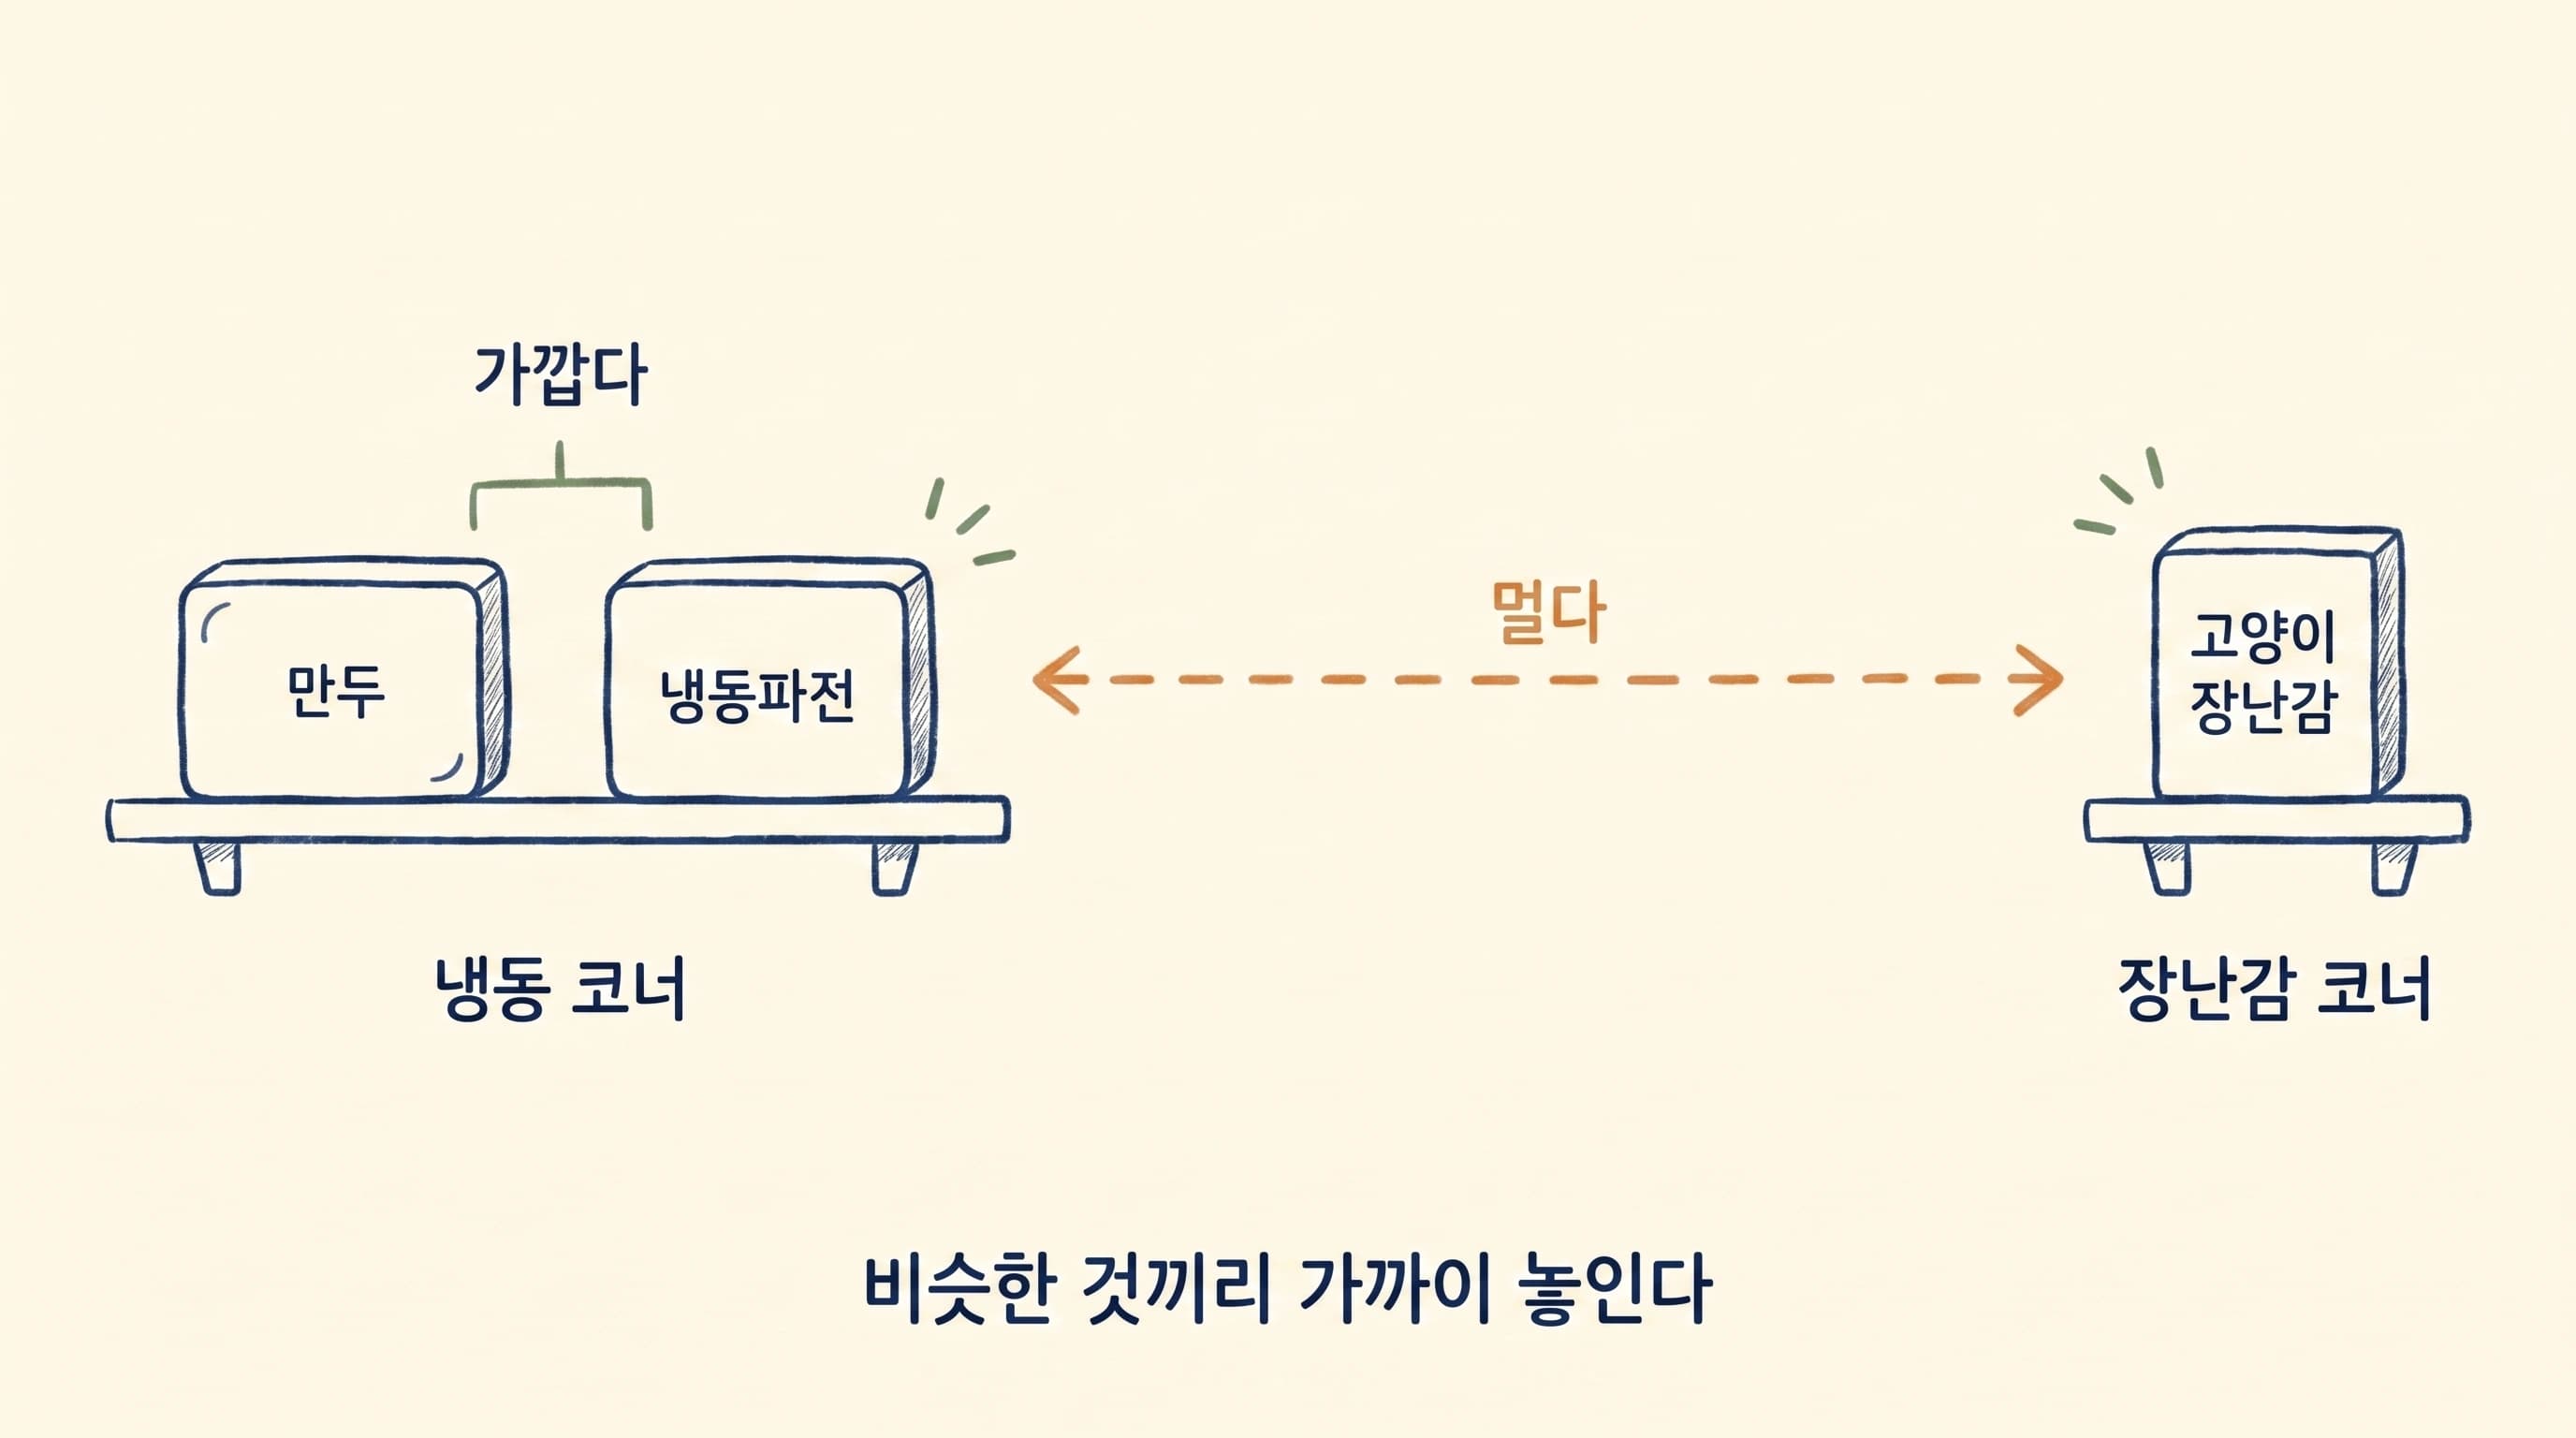
이번에는 마트를 예로 들어보겠습니다. 만두의 위치가 3번 통로 냉동고, 4번 선반, 1035번이라고 가정하겠습니다. 냉동파전은 같은 선반 근처에 있고, 고양이 장난감은 34번 통로 28번 선반처럼 전혀 다른 자리에 있습니다.
임베딩은 이 위치를 표현(Representation)하는 작업입니다. 마트가 비슷한 상품끼리 가까이 배치하듯, 임베딩은 텍스트의 의미를 숫자로 바꿔 비슷한 의미끼리 가까운 자리에 놓습니다.
"인플레이션의 원인"이라는 문장이 임베딩 모델을 통과하면 0.12, -0.45, 0.78 같은 숫자 배열로 변환됩니다. 이 배열이 벡터이고 배열의 길이를 차원이라고 부릅니다.
| 예시 | 기본 차원 | 판단할 지점 |
|---|---|---|
| all-MiniLM-L6-v2 | 384 | 가벼운 로컬 검색에 많이 쓰이지만 입력 길이와 언어·도메인 적합성을 따로 확인 |
| OpenAI text-embedding-3-small | 1536 | API 비용·품질·차원 축소 옵션을 함께 평가 |
| OpenAI text-embedding-3-large | 3072 | 기본 차원이 크지만 필요하면 축소 가능 |
차원이 크면 일반적으로 저장 공간과 검색 연산량이 늘지만, 차원 수만으로 의미 표현력이나 검색 정확도를 판단할 수는 없습니다. OpenAI는 3072차원 모델을 더 작은 차원으로 축소하는 옵션도 제공합니다. 같은 데이터와 평가 질문으로 모델을 직접 비교해야 합니다.
임베딩을 문장의 지문이라고 생각해도 됩니다. 사람마다 지문이 다르듯 문장마다 고유한 숫자 조합을 갖고, 의미가 비슷한 문장끼리는 숫자 조합도 비슷하게 나타납니다.
단어가 아니라 의미로 찾는 Semantic Search
2D 좌표로 시각화하면 더 직관적입니다. 인플레이션과 물가상승 같은 경제 용어는 좌표 위에서 가까이 모이고 조건반사나 파블로프 같은 심리학 용어는 전혀 다른 자리에 찍힙니다. 친한 친구들이 교실에서 가까이 앉는 것과 같습니다.
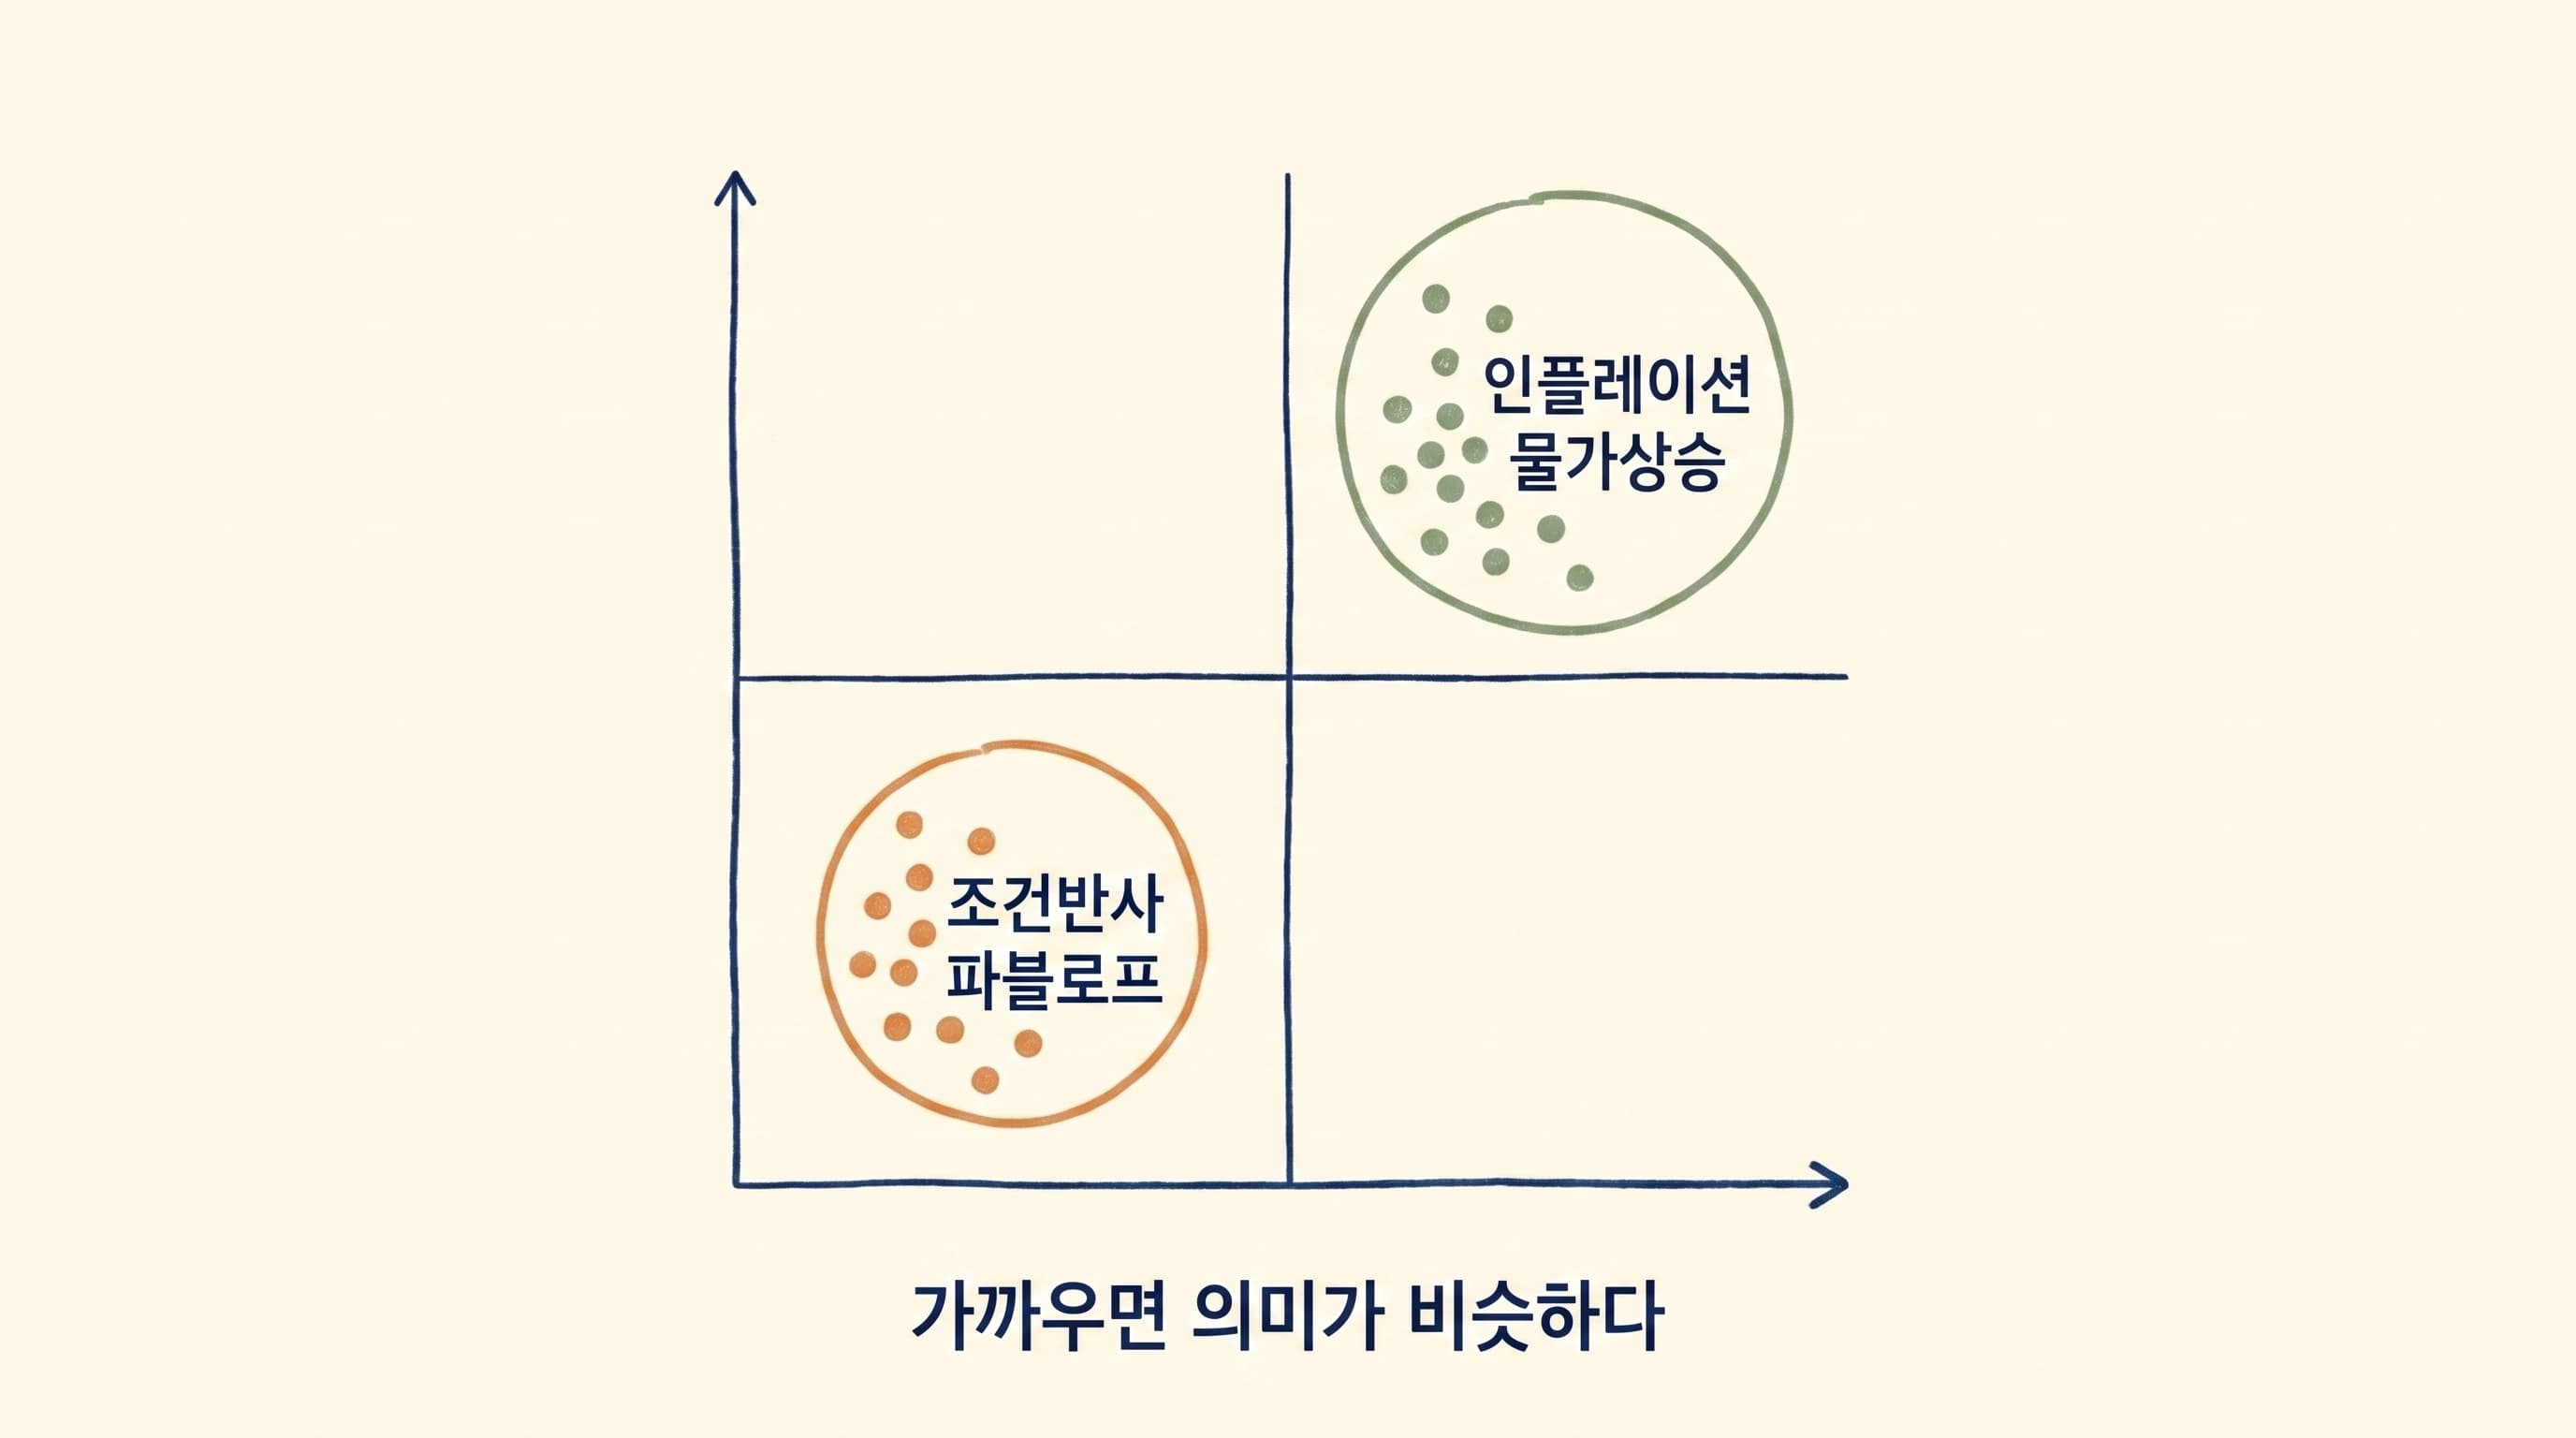
덕분에 사용자가 "과일 알레르기 정책이 뭐야?"라고 물었을 때 문서에 "과일"이라는 단어가 없어도 "사과, 복숭아 관련 식품 안전 규정" 문서를 찾아옵니다. 단어가 아니라 의미로 검색하는 것이고 이를 Semantic Search(의미 기반 검색)라고 부릅니다.
청킹과 Parser가 필요한 이유
문서를 숫자로 바꾸기 전에 먼저 확인할 부분이 있습니다. 대부분의 임베딩 모델에는 입력 길이 제한이 있습니다. 긴 문서를 한 벡터에 넣을 수 있더라도 여러 주제가 하나의 벡터에 압축되면 검색 단위가 지나치게 커집니다. 그래서 문서를 검색에 적합한 크기로 나누며, 이렇게 나눈 조각을 청크라고 부릅니다.
문제는 자르는 방식입니다. 500자마다 기계적으로 자르면 문장 중간이 잘립니다. 한 문단의 앞부분은 이 청크에, 뒷부분은 저 청크에 들어가면서 정보가 쪼개집니다.
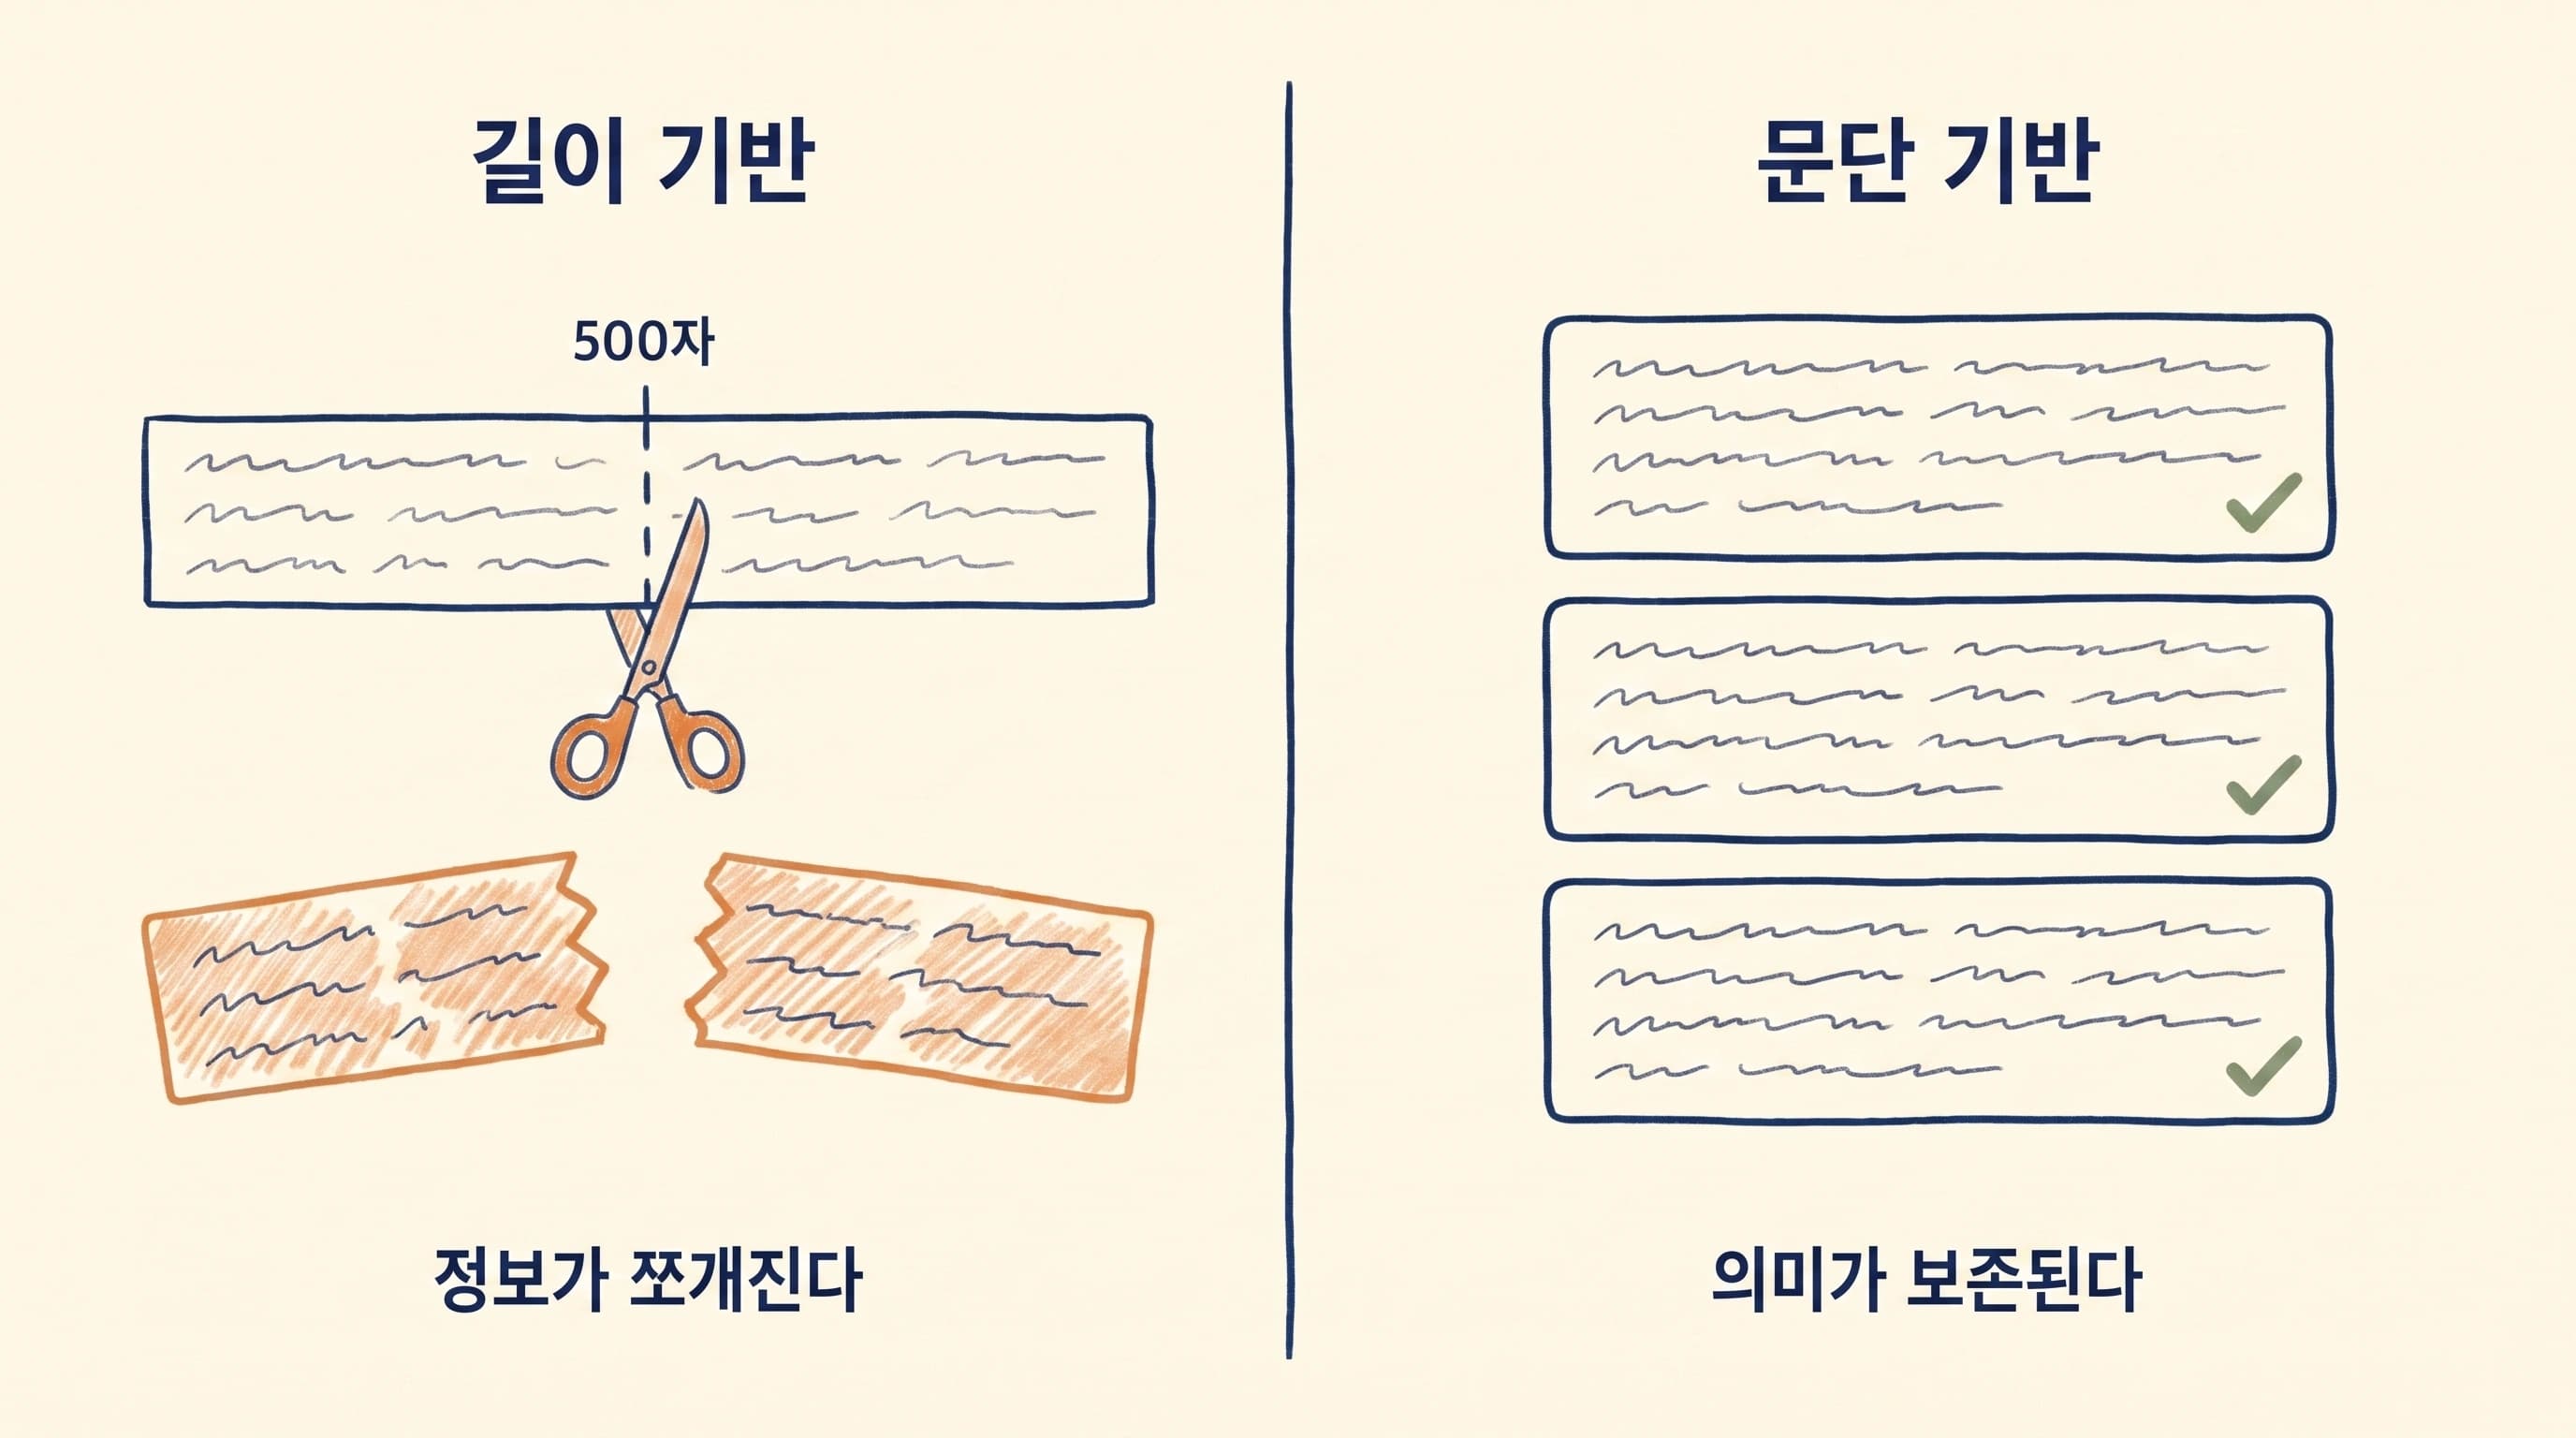
| 청킹 전략 | 장점 | 감내해야 할 부분 |
|---|---|---|
| 길이 기반 | 구현이 쉽고 빠름 | 정보 손실, 실험할 변수가 많음 |
| 의미 기반 | 문맥 보존에 유리 | 구현 난도가 높고 처리가 느림 |
말로만 하면 감이 잘 안 와서 아래 "작은 문서 세 개" 예시를 한 문서로 이어 붙인 뒤 실제로 잘라 봤습니다. 길이 기반은 40자마다, 문단 기반은 빈 줄에서 자르는 짧은 파이썬 코드입니다.
flat = text.replace("\n\n", " ")
for i in range(0, len(flat), 40):          # 길이 기반: 40자마다
    print(f"  {i // 40 + 1}: {flat[i:i + 40]!r}")
for i, para in enumerate(text.split("\n\n"), 1):   # 문단 기반: 빈 줄마다
    print(f"  {i}: {para!r}")
돌리면 이렇게 나옵니다.
[길이 기반: 40자마다 자르기]
  1: '촬영용 카메라는 사용일 이틀 전까지 신청합니다. 대여 기간은 최대 사흘입'
  2: '니다. 마이크는 사용 당일 신청할 수 있습니다. 외부 반출에는 담당자 확'
  3: '인이 필요합니다. 반납할 때 구성품 목록과 실제 수량을 확인합니다. 분실'
  4: '이 있으면 담당자에게 알립니다.'
[문단 기반: 빈 줄에서 자르기]
  1: '촬영용 카메라는 사용일 이틀 전까지 신청합니다. 대여 기간은 최대 사흘입니다.'
  2: '마이크는 사용 당일 신청할 수 있습니다. 외부 반출에는 담당자 확인이 필요합니다.'
  3: '반납할 때 구성품 목록과 실제 수량을 확인합니다. 분실이 있으면 담당자에게 알립니다.'
길이 기반 2번 청크를 보시면 카메라 문장의 끝("니다.")과 마이크의 "당일 신청" 규칙이 한 덩어리에 들어 있습니다. 누가 "카메라 당일 신청 돼요?"라고 물으면 이 청크가 잘 잡히는데, 정작 카메라의 "이틀 전" 규칙은 1번 청크에 있습니다. 아래에서 말하는 "B의 조건을 섞은 답"이 이렇게 만들어집니다. 문단 기반은 장비 하나에 청크 하나라 이런 섞임이 없습니다. 실제 문서는 이렇게 빈 줄이 깔끔하지 않으니 Parser가 중요해집니다.
청크를 적절하게 자르는 일은 생각보다 쉽지 않습니다. 실제 문서에는 표와 이미지가 섞여 있고, OCR로 스캔한 문서는 정렬이 깨지기도 합니다. 제 경험상 순수 텍스트 문서의 청킹은 어렵지 않았지만 차트와 복잡한 테이블이 들어간 순간부터 난도가 급격히 올라갔습니다.
그래서 문서를 얼마나 깔끔하게 텍스트로 바꾸느냐, 즉 Parser(문서 텍스트 변환기)를 어떻게 적용하느냐가 청킹 품질을 결정하는 첫 관문입니다. 복잡한 PDF·스캔·표·차트를 HTML이나 Markdown으로 변환하는 상용 선택지로 Upstage Document Parse가 있습니다. Upstage는 자체 DP-Bench 결과를 공개하지만 실제 도입 전에는 보유 문서로 직접 비교해야 합니다. 로컬 실행이 필요하면 MIT 라이선스의 Docling 같은 오픈소스 파서도 별도로 검토할 수 있습니다.
벡터 데이터베이스, "비슷한 숫자 묶음 찾아줘"
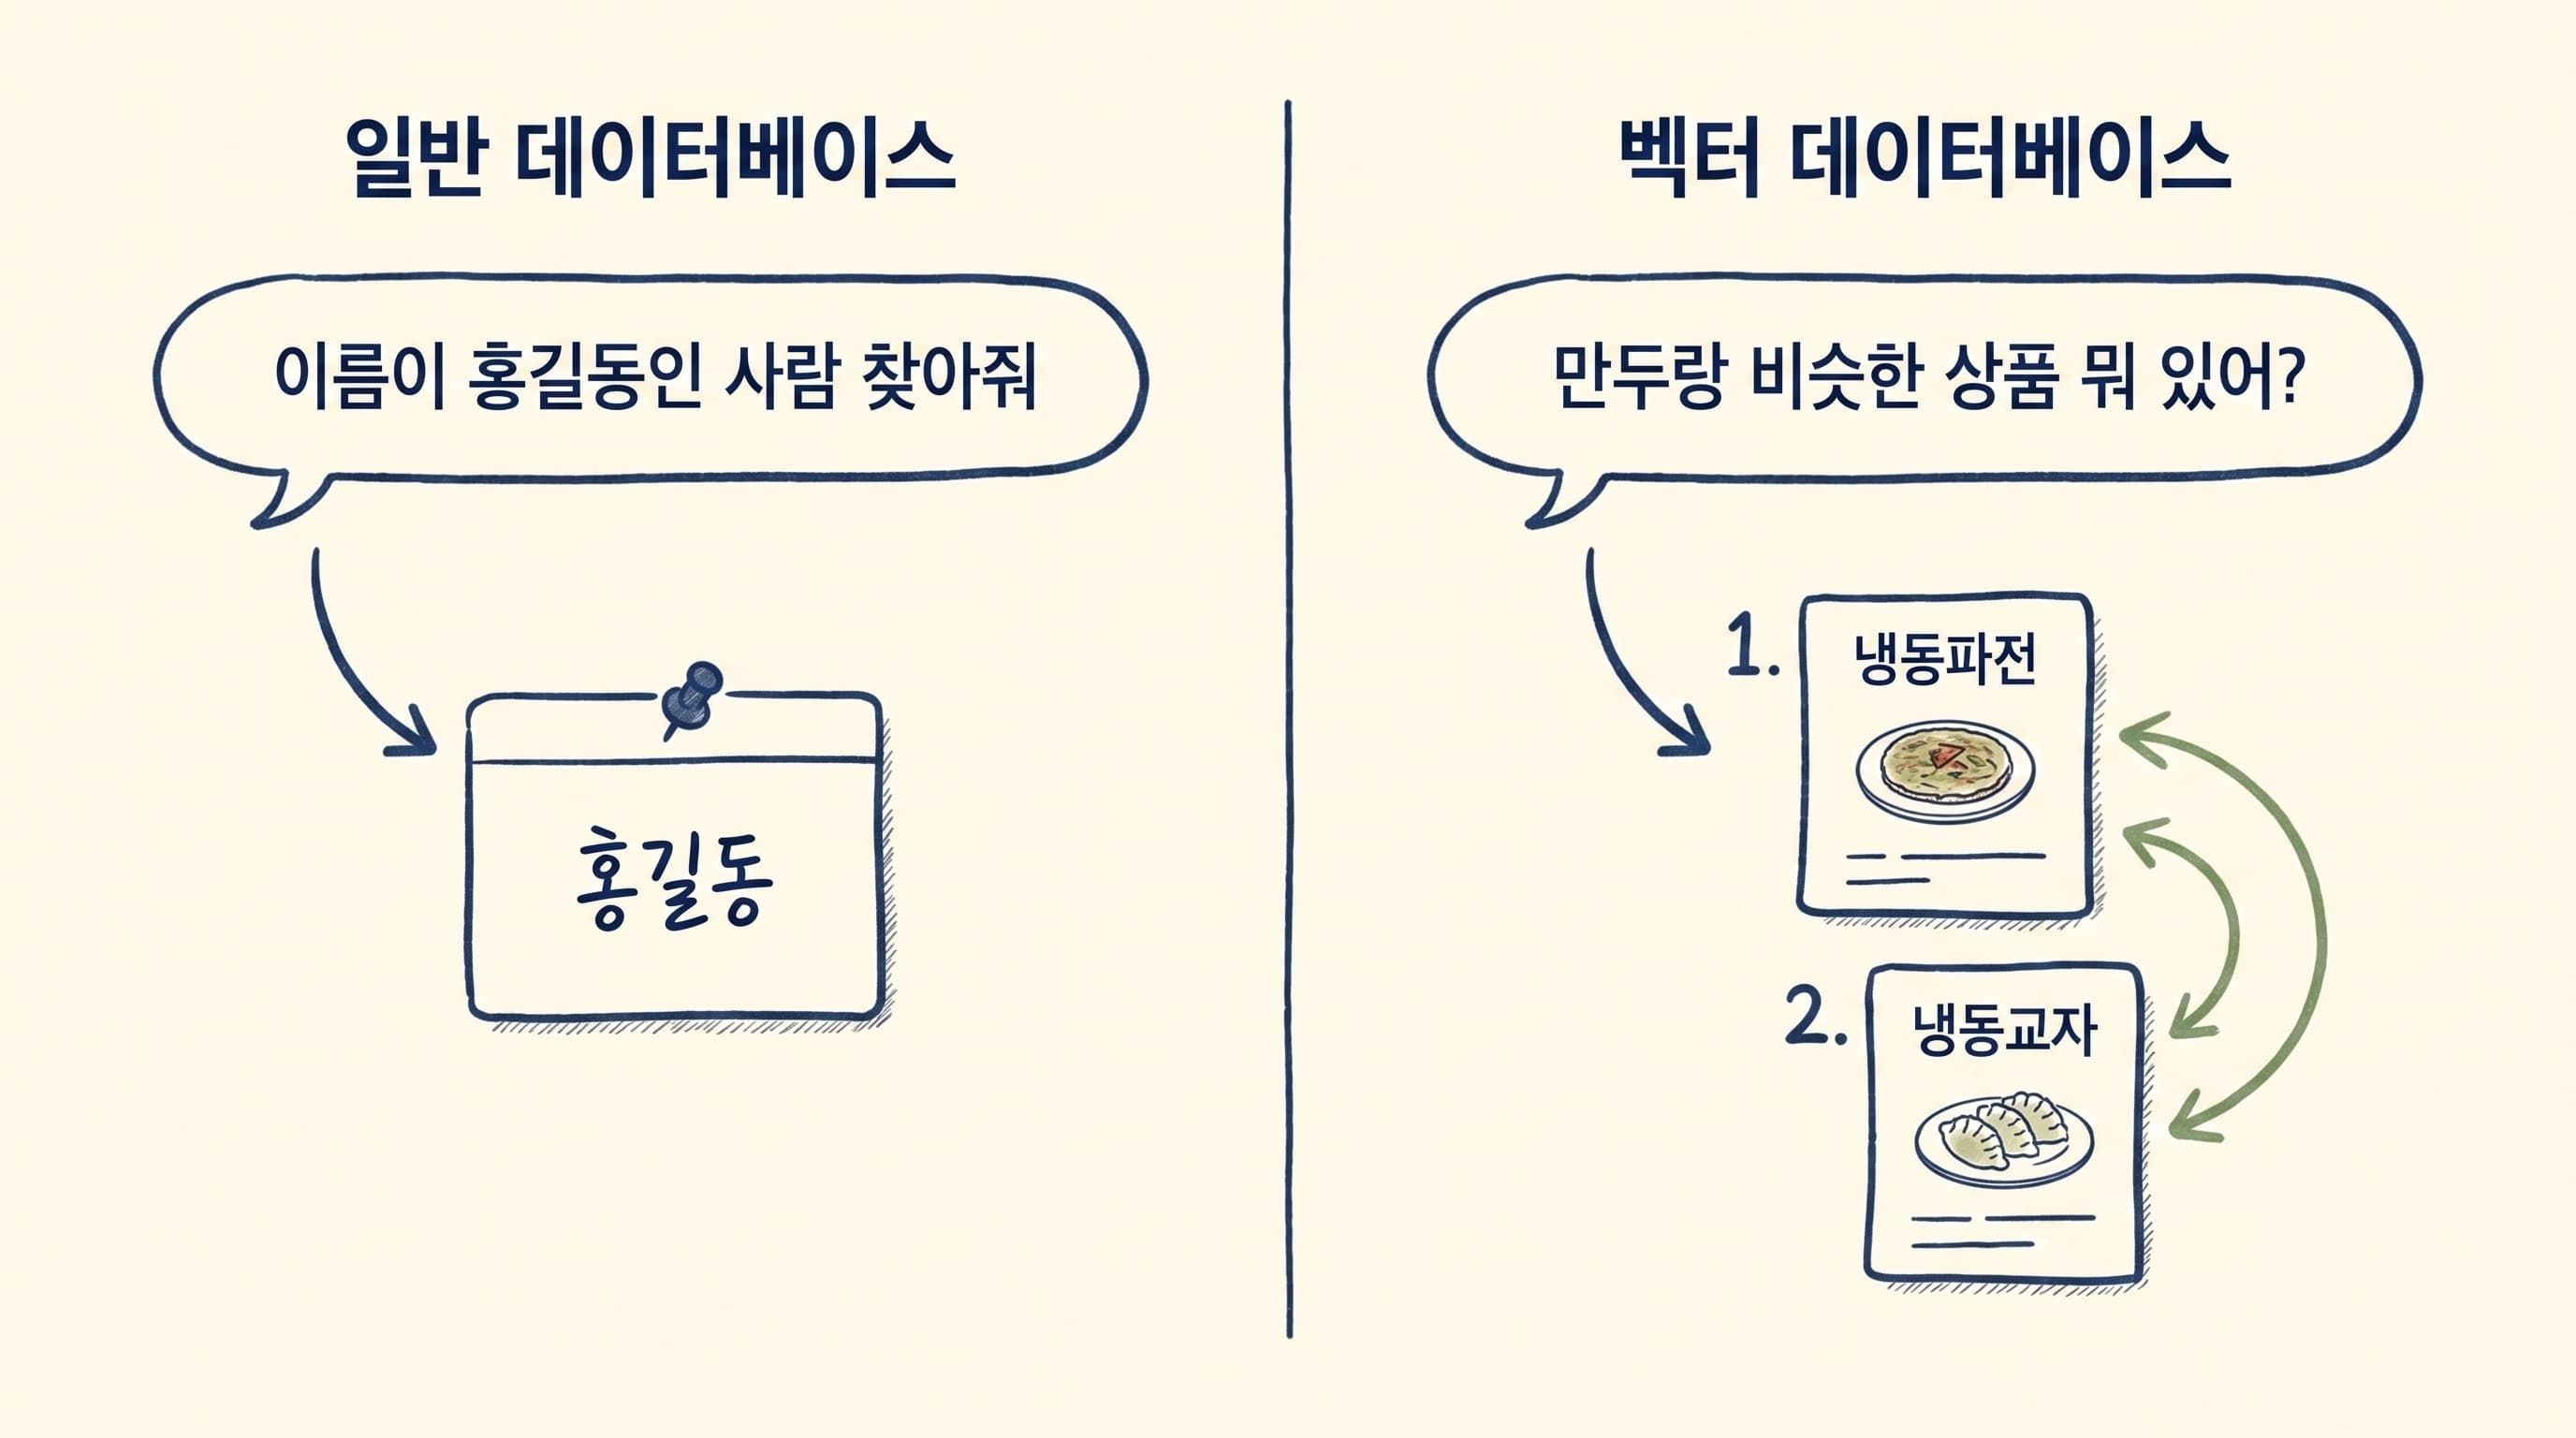
잘라서 숫자로 바꾼 청크들은 어디에 저장할까요. 여기서 벡터 데이터베이스가 등장합니다. 일반 데이터베이스는 "이름이 홍길동인 사람 찾아줘"처럼 정확한 조건으로 검색합니다. 벡터 데이터베이스는 "이 숫자 묶음이랑 가장 비슷한 숫자 묶음 찾아줘"라는 유사도 검색에 특화되어 있습니다. 마트로 치면 앞은 "3번 통로 4번 선반 1035번 가져와"이고, 뒤는 "만두랑 비슷한 상품 뭐 있어?"에 냉동파전과 냉동교자를 꺼내주는 방식입니다.
RAG 파이프라인 정리
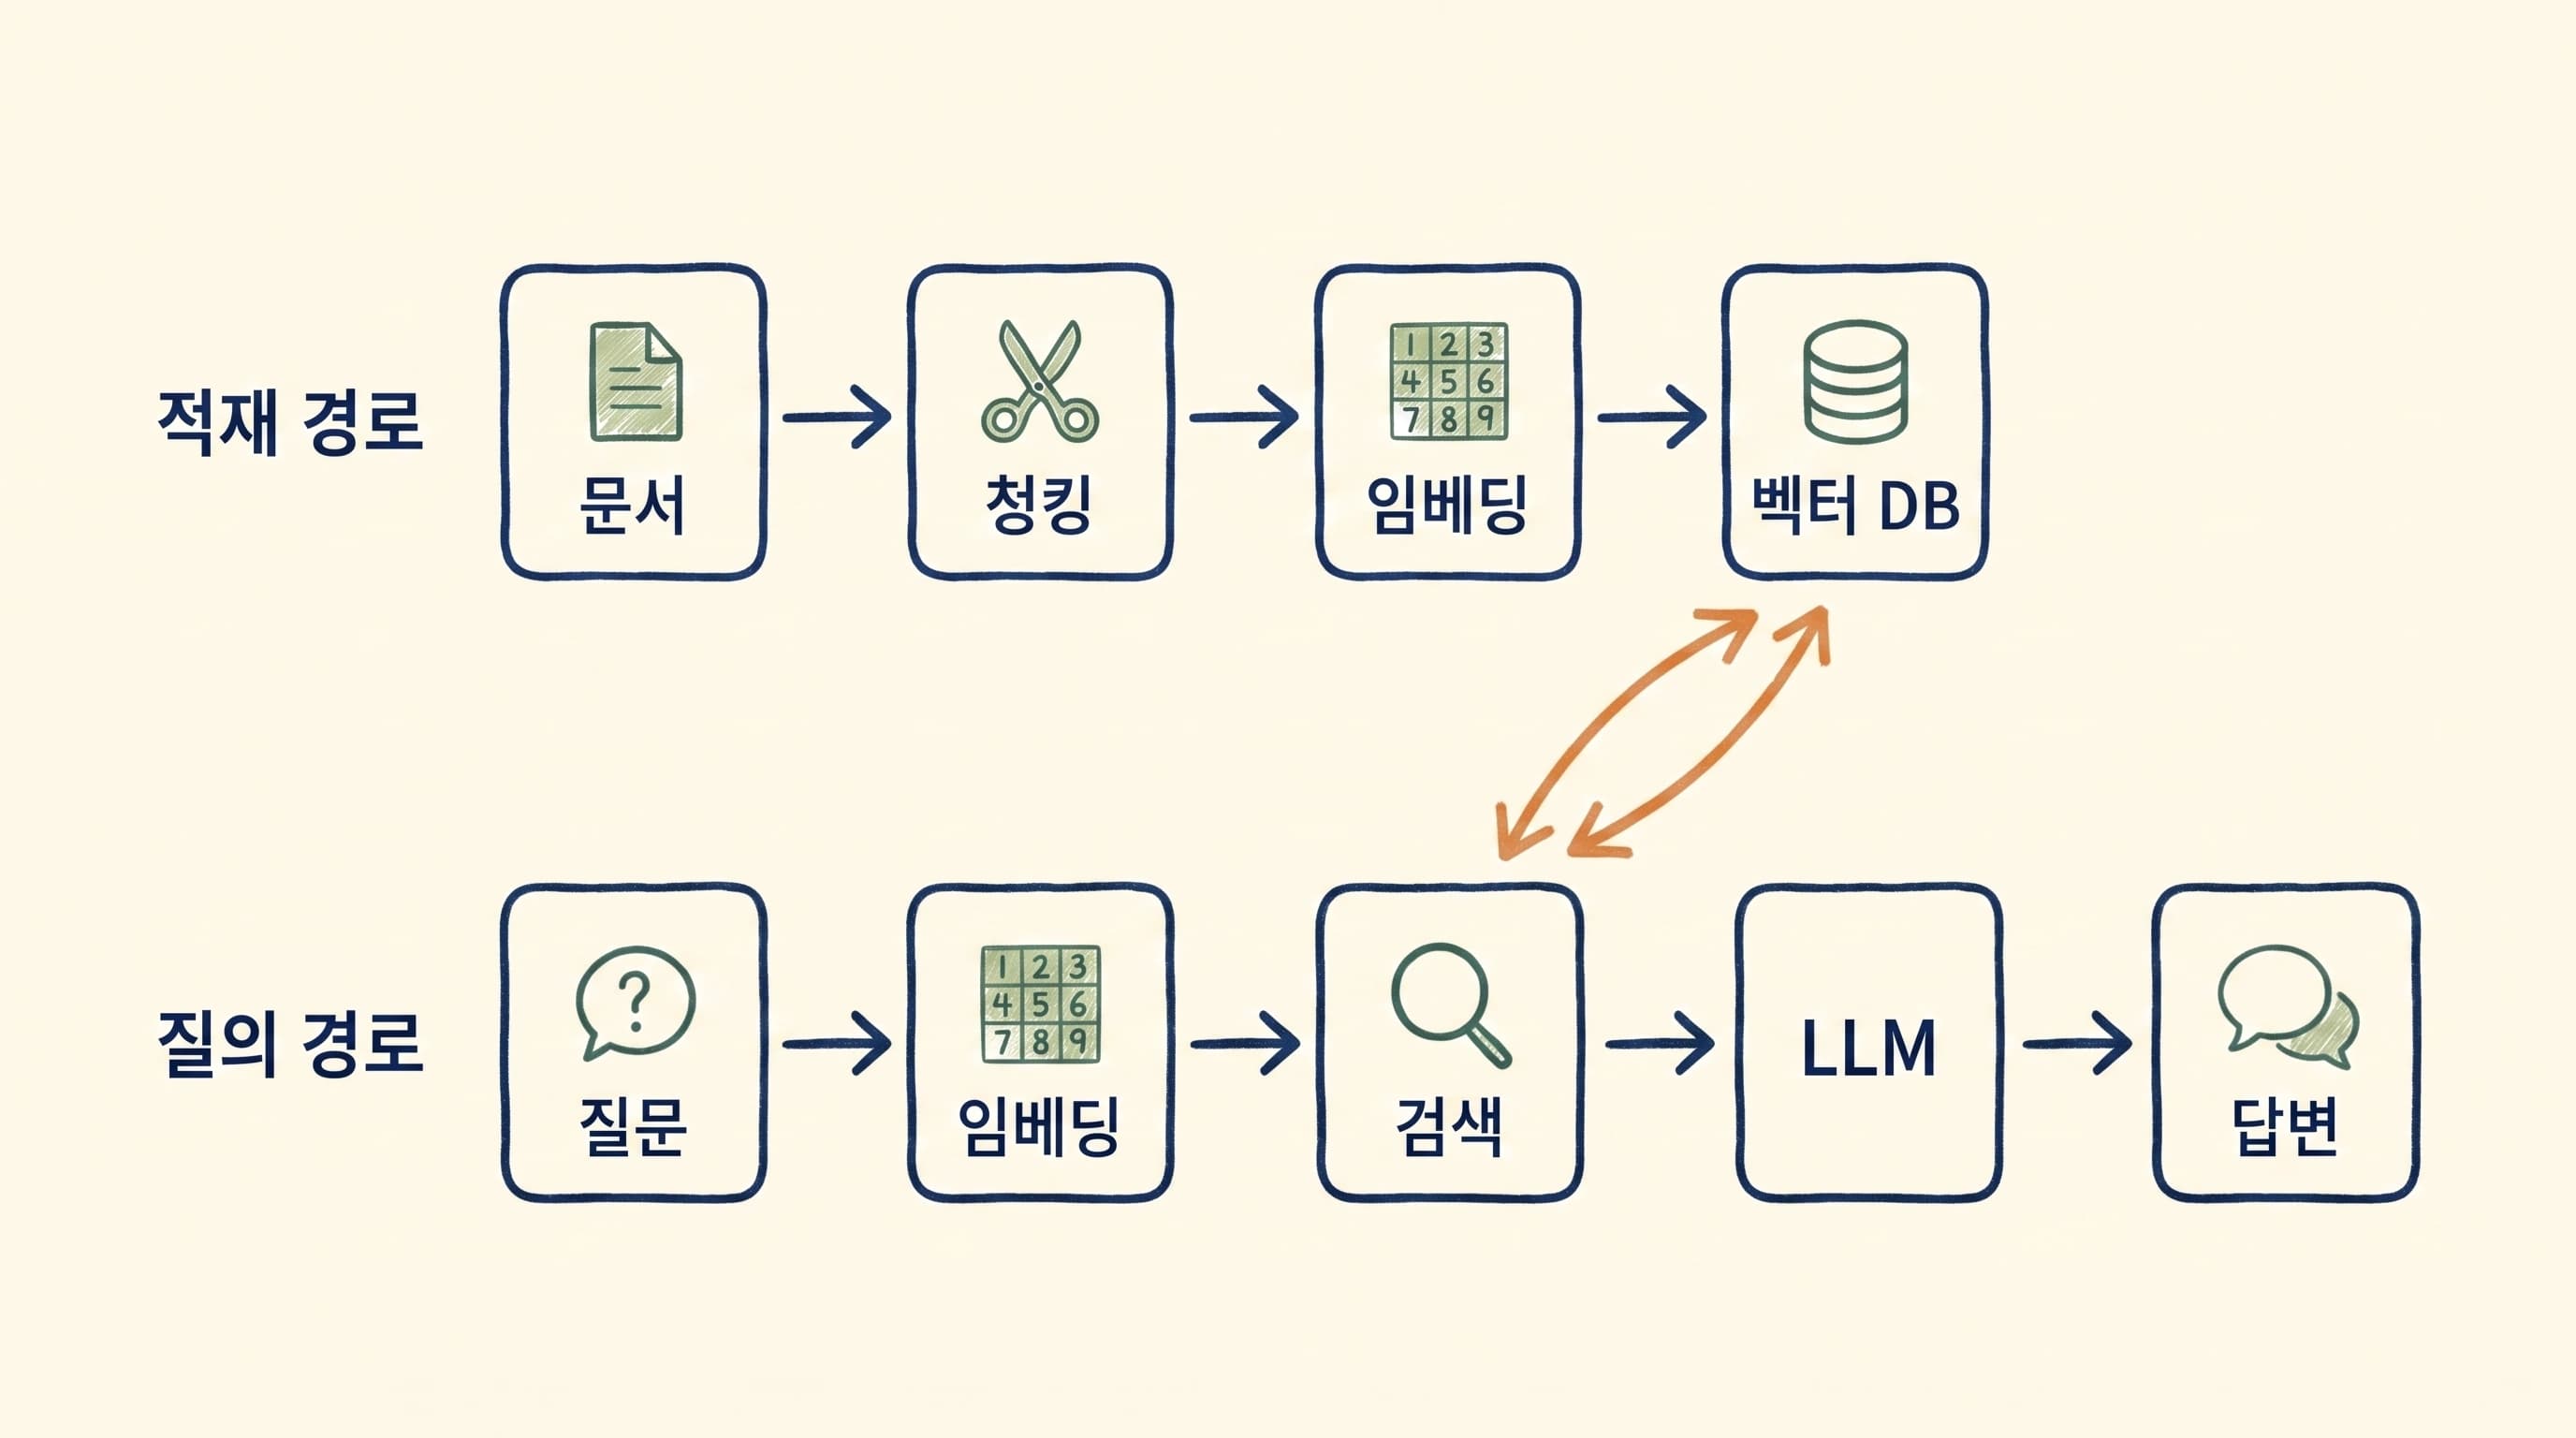
먼저 문서를 청크로 나누고 각 청크를 임베딩으로 숫자화해 벡터 데이터베이스에 저장합니다. 사용자가 질문하면 질문도 임베딩으로 바꾼 뒤 가장 비슷한 청크를 찾습니다. 검색한 청크를 LLM의 컨텍스트로 넘기면 이를 근거로 답변을 만듭니다. 문서 분할, 임베딩, 유사도 검색, 검색 결과를 근거로 한 답변 생성이 RAG 파이프라인의 기본 구성입니다.
작은 문서 세 개로 검색과 답변 분리하기
아래는 원리를 확인하기 위해 만든 가상의 장비 대여 안내입니다. 실제 회사의 규정이나 프로젝트 실적이 아닙니다. 도구를 설치하기 전에 이 정도 크기의 예시로 원하는 답과 근거부터 정해보세요.
| 문서 ID | 문서 내용 |
|---|---|
| A | 촬영용 카메라는 사용일 이틀 전까지 신청합니다. 대여 기간은 최대 사흘입니다. |
| B | 마이크는 사용 당일 신청할 수 있습니다. 외부 반출에는 담당자 확인이 필요합니다. |
| C | 반납할 때 구성품 목록과 실제 수량을 확인합니다. 분실이 있으면 담당자에게 알립니다. |
“내일 쓸 카메라를 오늘 신청해도 되나요?”라는 질문의 근거는 A입니다. 먼저 검색 결과에 A가 포함되는지 확인합니다. A가 없으면 검색 단계의 문제이고, A를 찾았는데도 “당일 신청 가능”이라고 답하면 B의 조건을 섞은 생성 단계의 문제입니다. 더 큰 모델을 고르기 전에 어디에서 잘못됐는지 나눌 수 있습니다.
예상 답은 “안내상 카메라는 이틀 전 신청해야 하므로, 내일 사용을 오늘 신청하는 것은 정해진 기한에 맞지 않습니다. 예외 승인 여부는 문서에 없습니다. [A]”입니다. 문서에 없는 예외를 만들어내지 않는 것까지가 완료 조건입니다.
다음에는 “삼각대는 언제 신청하나요?”를 물어봅니다. 세 문서에는 삼각대가 없으므로 확인할 수 없다고 답해야 합니다. 검색 결과가 있다는 사실과 답할 근거가 있다는 사실은 다릅니다. 마지막으로 A의 신청 기한을 바꾸고 다시 색인해, 예전 내용이 계속 답에 섞이지 않는지 확인합니다.
이 세 질문에서 확인할 것은 정답 문서 검색, 근거에 맞는 답변, 정보가 없을 때의 응답입니다. 실제 문서로 옮길 때도 질문·정답 근거·예상 답을 함께 보관하면 검색 품질 비교에 그대로 쓸 수 있습니다. 직접 실행해 보고 싶다면 제목 보존 전후를 비교하는 파이썬 실습에서 입력·코드·실패 결과를 함께 확인하세요.
실제 프로젝트에서 먼저 확인할 부분
개념만 놓고 보면 RAG는 어렵지 않습니다. 하지만 이 기본 구조를 그대로 프로덕션에 적용하면 문제가 생기는 경우가 많습니다. 제가 3년 동안 현장에서 가장 많이 부딪힌 지점도 이 부분입니다.
제가 진행한 프로젝트에서는 Generation, 즉 답변 생성보다 검색 단계에서 문제가 더 자주 발생했습니다. 대상 문서가 수백, 수천 건으로 늘어나면 검색 품질이 급격히 떨어집니다. 모델이 답변을 만들지 못하는 것이 아니라 관련 없는 청크가 검색되어 잘못된 답변으로 이어지는 경우였습니다. RAG가 제대로 동작하지 않은 대부분의 사례에서 원인은 검색에 쓰기 어려운 청크였습니다.
그래서 처음 붙여보는 분이라면 이렇게 나눠 판단하시면 좋겠습니다. 순수 텍스트 위주이고 건수가 수백 건 이내라면 길이 기반 청킹에 작은 차원의 임베딩 모델부터 붙여 동작을 확인하는 편이 빠릅니다. 표와 이미지가 섞인 문서를 수천 건 이상 다뤄야 한다면 임베딩 모델을 고르는 일보다 Parser와 청킹 전략에 시간을 먼저 쓰는 쪽이 결과가 좋았습니다.
다음 글과 Reference
다음 글에서는 검색 품질이 무너지는 구간을 어떻게 되살리는지 다룹니다. Dense와 Sparse 임베딩의 차이, 두 검색을 합치는 하이브리드 서치, 후보군을 다시 평가하는 리랭커, 청크에 맥락을 붙이는 Contextual Retrieval까지 이어집니다. "RAG는 죽었다"는 내러티브를 어떻게 읽어야 하는지도 그 글에서 정리하겠습니다.
Reference
추가 학습 자료 신청
ZEXEA 메인 사이트의 자료 신청 페이지로 이동합니다. 이름·이메일·전화번호 등의 입력이 필요합니다. 블로그 글과 실습 예제는 신청 없이 모두 읽을 수 있습니다.
관련 가이드
RAG 검색 품질 진단: 청크 확인부터 하이브리드 검색·리랭커까지
RAG 검색 실패를 청크 원문과 정답 문서로 진단하는 방법입니다. 하이브리드 검색·리랭커·맥락 보완의 적용 조건을 설명하고, 제목 보존 전후를 비교하는 실행 코드와 결과로 연결합니다.
전체 과정 보기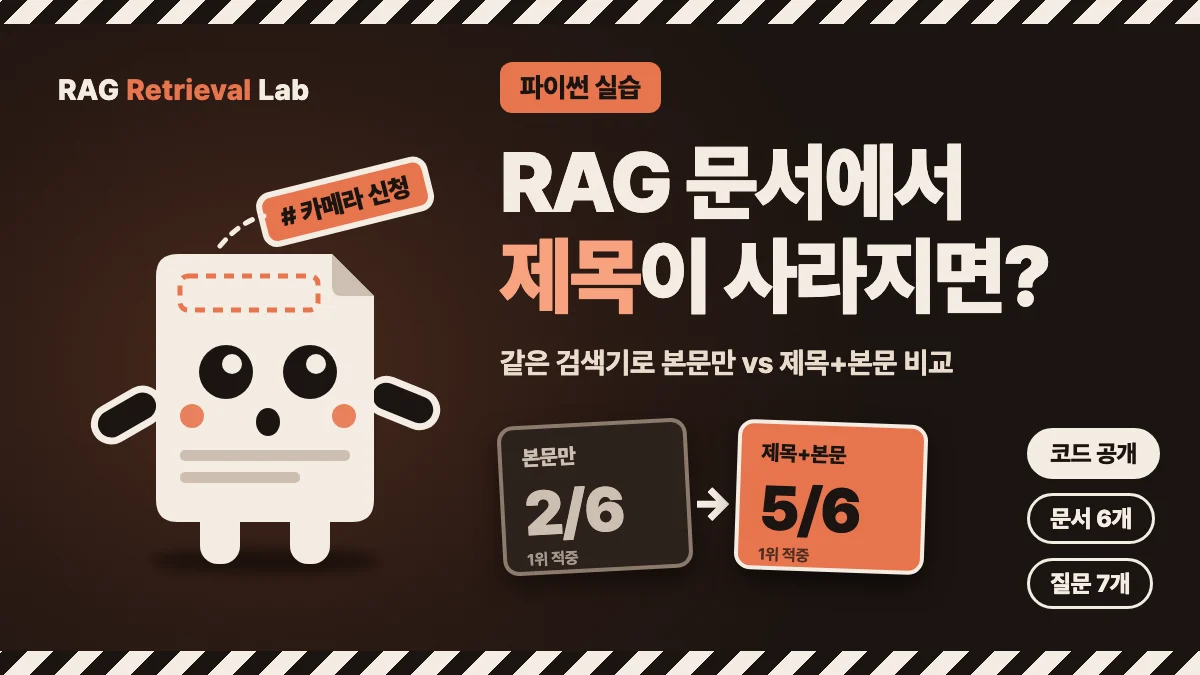
RAG 문서에서 제목이 사라지면? 같은 검색기로 비교하는 파이썬 실습
가상 장비 문서 6개와 질문 7개로 제목 보존 전후의 검색 결과를 비교합니다. 실행 코드·입력 데이터·결과 CSV를 공개하고, 동의어와 정답 없는 질문에서 남는 실패까지 확인합니다.
전체 과정 보기
Claude Code 프론트엔드 디자인 도구 5종, AI 티 나는 웹사이트를 고치는 스킬·CLI 사용법
Claude Code로 만든 웹사이트의 AI 티를 줄이는 디자인 도구 5종. Awesome DESIGN.md, Taste Skill, Image to Code, Playwright CLI, Vercel 규칙 스킬의 정체와 설치법, 쓰는 시점, 직접 돌려본 결과를 정리했습니다.
전체 과정 보기