로컬 AI 모델 4종, 콘텐츠 자동화에 쓸 수 있을까? RTX 5090에서 잰 생성 시간과 VRAM
로컬 AI 모델 4종(Qwen Image 2.1, InfiniteTalk, MiniMax H3, YuE2)을 RTX 5090과 ComfyUI로 돌려 생성 시간과 VRAM을 실측했습니다. 한글 인포그래픽, 20분 립싱크, 양자화 품질 저하까지 자동화 합격선을 적었습니다.
이전 글에서는 한국어 오픈소스 TTS 5종을 RTX 5090에서 돌려 속도와 VRAM을 비교했습니다.
한국어 오픈소스 TTS 모델 5종 비교, RTX 5090에서 직접 측정한 속도와 VRAM
이번 글에서는 음성을 뺀 나머지, 이미지·아바타·영상·음악 로컬 AI 모델 4종을 같은 PC에서 돌려보고 콘텐츠 자동화에 넣을 수 있는지 판단해 보겠습니다. Qwen Image 2.1(이미지), InfiniteTalk(아바타 립싱크), MiniMax H3(영상), YuE2(음악)이고 기준은 두 가지입니다. 사람 손 없이 반복할 수 있는지, 한 번 돌릴 때 시간과 메모리를 얼마나 쓰는지입니다. (영상에서 틀어놓고 비교한 부분은 측정 수치와 결과 화면으로 바꿔 적었습니다.)
사용 도구 및 준비물
로컬 모델과 VRAM
로컬 모델(local model)은 회사 서버에 요청을 보내는 대신 모델 파일을 내려받아 내 그래픽카드로 돌리는 AI입니다. 쓸 때마다 요금이 나가지 않지만 속도와 품질은 전부 내 장비가 감당합니다.
제일 먼저 부딪히는 숫자가 VRAM(그래픽카드 전용 메모리)입니다. 작업 책상 넓이라고 보시면 됩니다. 모델이라는 도면을 책상에 한 번에 펼쳐야 작업이 시작되는데, 책상이 좁으면 못 펼치거나 도면을 접어서 올려야 합니다. 이 접는 작업이 뒤에 나올 양자화(quantization, 모델을 가볍게 압축하는 것)입니다.
실행은 ComfyUI(모델을 블록끼리 이어서 돌리는 무료 도구)로 했습니다. 저는 ComfyUI를 다룰 줄 몰라서 Codex에 워크플로우를 짜달라고 했고 모델마다 무엇을 넣고 무엇이 나오는지만 미리 공부해 두었습니다.
측정 조건과 실측 결과
측정 조건은 다음과 같습니다.
- RTX 5090 1장, VRAM 32GB(32,607 MiB), 사례별 1회 순차 실행 (2026년 9월)
- 시간: 요청부터 결과 파일 저장까지, 모델 로딩 포함
- 메모리: nvidia-smi 1초 표본의 그래픽카드 전체 최고값, 바탕화면이 쓰던 2,000~2,500 MiB 포함
| 사례 | 입력 → 결과 | 요청~저장 | VRAM 최고 |
|---|---|---|---|
| Qwen Image 2.1 | 글 지시 → 한국어 인포그래픽 1장 | 142.8초 | 18,639 MiB |
| Qwen Image 2.1 | 인물 시트 + 지시 → 썸네일 1장 | 52.5초 | 24,357 MiB |
| InfiniteTalk | 사진 1장 + 음성 23.5초 → 립싱크 영상 23.4초 | 1,210.5초 | 21,784 MiB |
| MiniMax H3 | 첫·끝 화면 + 지시 → 15초 제품 데모 영상 | 1,148.3초 | 31,707 MiB |
| MiniMax H3 | 글 지시만 → 15초 시네마틱 영상 4편 | 1,101~1,119초 | 31,698~31,883 MiB |
| YuE2 | 장르·분위기 글 → 32초 음악 | 90.4초 | 10,529 MiB |
| YuE2 | 악보 + 스타일 → 약 30초 관현악 편곡 | 10.1초 | 9,752 MiB |
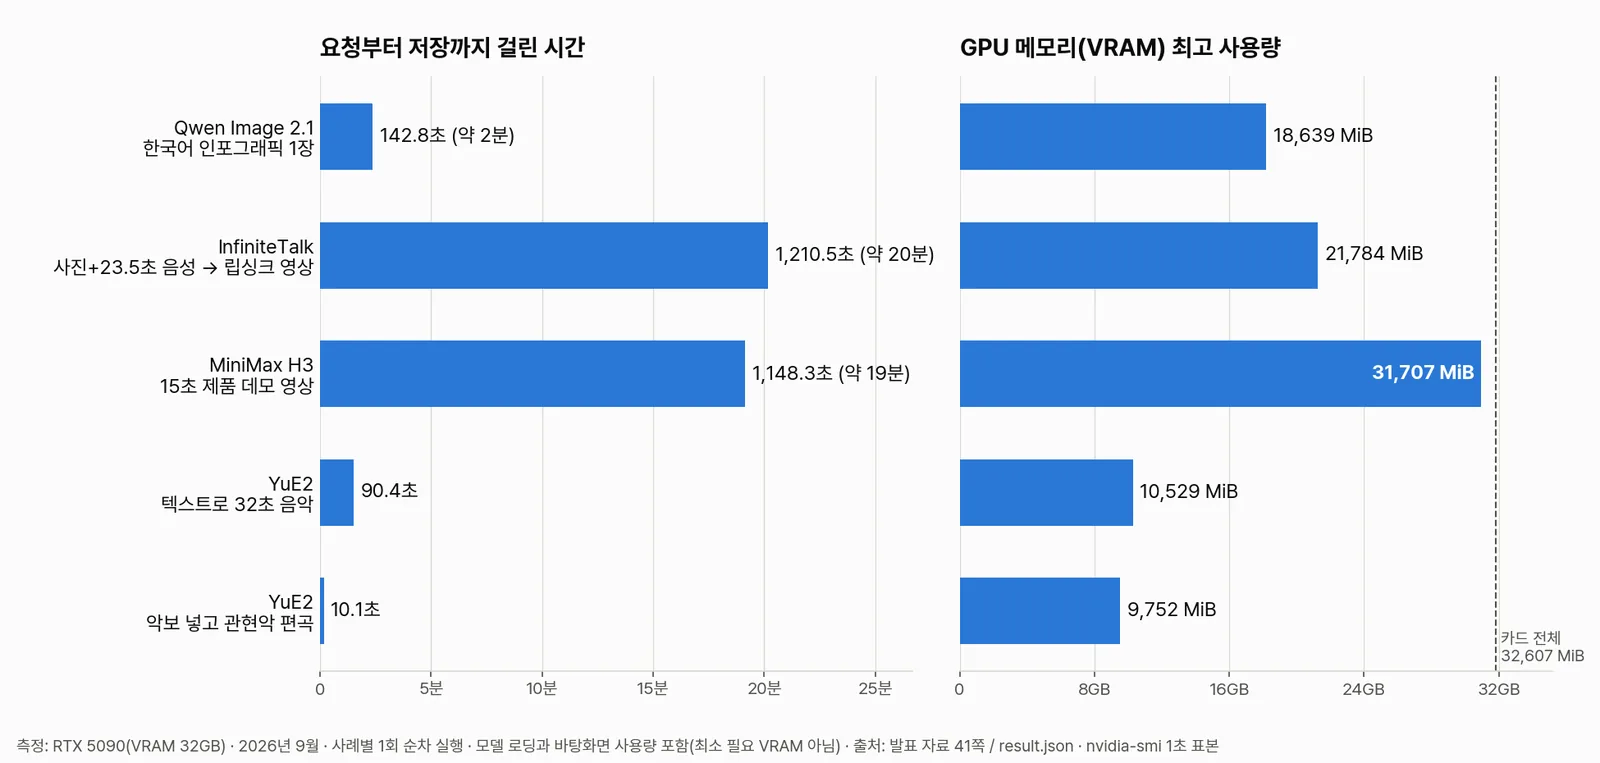
체감 단위로 바꾸면 이렇습니다. 23초 아바타 한 편에 약 20분이니 하루 24시간 돌려도 70편 남짓이고 1분 분량이면 단순 계산으로 한 편에 50분이 넘습니다. H3는 15초에 18~19분 동안 32GB 중 31GB 넘게 써서 다른 모델을 같이 못 돌립니다. 반면 음악은 10GB 안팎에서 1분 반, 악보 편곡은 10초면 끝났습니다.
이 VRAM 값은 로딩과 바탕화면을 포함한 관측값이라 최소 필요 사양이 아닙니다. 작은 그래픽카드용 경량 모델 파일을 올려두는 개발자도 많으니 본인 카드에서 다시 확인해 보셔야 합니다.
이미지와 아바타 결과
1. Qwen Image 2.1 - 한글 인포그래픽에서 탈락
먼저 글로만 지시해 인포그래픽을 만들었습니다. 한국어 문구 26개를 전부 따옴표로 적어 넣었습니다. 영어는 이미지 위에 곧잘 그리는데 한글 텍스트 렌더링은 아직 약했습니다. 결과물을 한 장씩 사람이 다시 확인해야 한다면 자동화가 아니라서, 인포그래픽에는 쓰지 않겠습니다.
제 캐릭터 시트를 넣고 썸네일도 만들어 봤습니다. 아래쪽을 자막 자리로 비우라는 조건을 함께 넣었습니다.
실제로 넣은 프롬프트 원문과 번역입니다(시드 2026092504). 캐릭터 시트의 다른 칸이 복제되지 않도록 "큰 얼굴 사진만 기준으로 삼으라"고 못 박은 부분이 핵심입니다.
Create a new text-free YouTube thumbnail from the single input character sheet, using only its large close-up portrait as the creator identity reference. Keep the same adult person and recognizable facial identity; do not reproduce the sheet layout, its other pose panels, labels or writing. In the new scene the creator appears once, chest-up on the right, wearing a plain dark shirt and listening through studio headphones with one hand near an ear cup. A luminous cyan audio waveform flows from the left toward the headphones in a dark navy recording studio, with restrained violet rim light and a sharp, natural face. Reserve the entire left half as a quiet dark area for a headline to be typeset later, and keep the bottom band clear for later labels. The composition is photorealistic and readable at thumbnail size; background, lighting and pose change strongly while facial identity remains anchored to the input portrait. There is no visible lettering, brand symbol, logo, watermark or duplicate person. Negative: Different face, copied character-sheet panels, duplicated person, extra hands, garbled headphones, visible text, symbols, logos, watermark.
(번역) 한 장의 입력 캐릭터시트에서 큰 얼굴 사진만 제작자의 정체성 기준으로 삼아 글자 없는 새 유튜브 썸네일을 만든다. 같은 성인 인물의 얼굴 정체성을 유지하고 시트의 다른 자세 칸, 배치, 라벨과 글자는 옮기지 않는다. 새 장면에서 제작자는 한 명만 오른쪽에 상반신으로 나타나며 어두운 무지 상의를 입고 스튜디오 헤드폰 한쪽에 손을 댄 채 소리를 듣는다. 짙은 남색 녹음실에서 밝은 청록색 음성 파형이 왼쪽에서 헤드폰으로 흐르고 보라색 테두리 조명과 자연스럽고 선명한 얼굴이 보인다. 왼쪽 절반은 나중에 제목을 직접 넣을 수 있도록 어둡고 조용하게 비우며 하단에도 라벨을 넣을 여백을 둔다. 사진처럼 사실적이고 작은 썸네일에서도 잘 보인다. 배경·조명·자세는 뚜렷이 바꾸되 얼굴은 입력 사진을 기준으로 유지한다. 화면 글자, 브랜드 기호, 로고, 워터마크, 중복 인물은 없다. 제외 지시: 다른 얼굴, 캐릭터시트 칸 복제, 중복 인물, 여분의 손, 망가진 헤드폰, 보이는 글자·기호·로고·워터마크.
로컬 모델
Seed: 2026092505 Create a distinct text-free YouTube thumbnail from the single input character sheet, using its large close-up portrait only to preserve the creator identity. The finished image contains one recognizable adult creator at a compact desk on the left, chest-up, facing the viewer with a calm, confident expression. On the right, five simple luminous abstract tiles suggest music, image, voice, avatar and video through shapes alone: a note, a picture frame, a waveform, a profile silhouette and a film frame. These are generic shapes, not model logos or readable UI. A thin cyan path leads from the desk across the five tiles against a deep charcoal studio background with restrained amber desk light. Keep the upper-right open for a later human-set title and the bottom strip empty for later captions. Change scene and pose clearly while holding facial identity to the input portrait; do not copy the character-sheet grid, written labels or extra views. Photorealistic portrait, crisp face, one person, mobile-readable visual hierarchy, no generated words, numbers, brands or watermark. Negative: Different face, duplicated or extra person, character-sheet grid, copied labels, fake model logos, text, numbers, malformed hands, watermark.
시드: 2026092505 한 장의 입력 캐릭터시트에서 큰 얼굴 사진만 제작자 정체성 기준으로 삼아 이전 음성 썸네일과 구별되는 글자 없는 새 유튜브 썸네일을 만든다. 결과에는 알아볼 수 있는 성인 제작자 한 명이 왼쪽의 작은 책상 앞에 상반신으로 앉아 정면을 보며 차분하고 자신 있는 표정을 짓는다. 오른쪽의 밝은 추상 타일 다섯 개는 음표, 사진 프레임, 파형, 옆얼굴 윤곽, 필름 프레임으로 음악·이미지·음성·아바타·영상을 암시한다. 모델 로고나 읽을 수 있는 UI가 아닌 일반 도형이다. 가는 청록색 선이 책상에서 다섯 타일로 이어지고 배경은 짙은 차콜색 스튜디오, 책상에는 절제된 호박색 조명이 있다. 오른쪽 위와 하단은 나중에 사람이 제목과 자막을 넣을 여백이다. 얼굴 정체성은 입력 큰 사진에 고정하되 장면과 자세는 뚜렷하게 바꾼다. 시트 격자, 글자, 다른 시점 사진을 복제하지 않는다. 사진처럼 사실적인 얼굴, 한 사람, 작은 화면에서도 읽히는 구성이다. 생성된 단어·숫자·브랜드·워터마크는 없다. 제외 지시: 다른 얼굴, 중복·추가 인물, 캐릭터시트 격자, 복제된 라벨, 가짜 모델 로고, 글자·숫자, 뒤틀린 손, 워터마크.
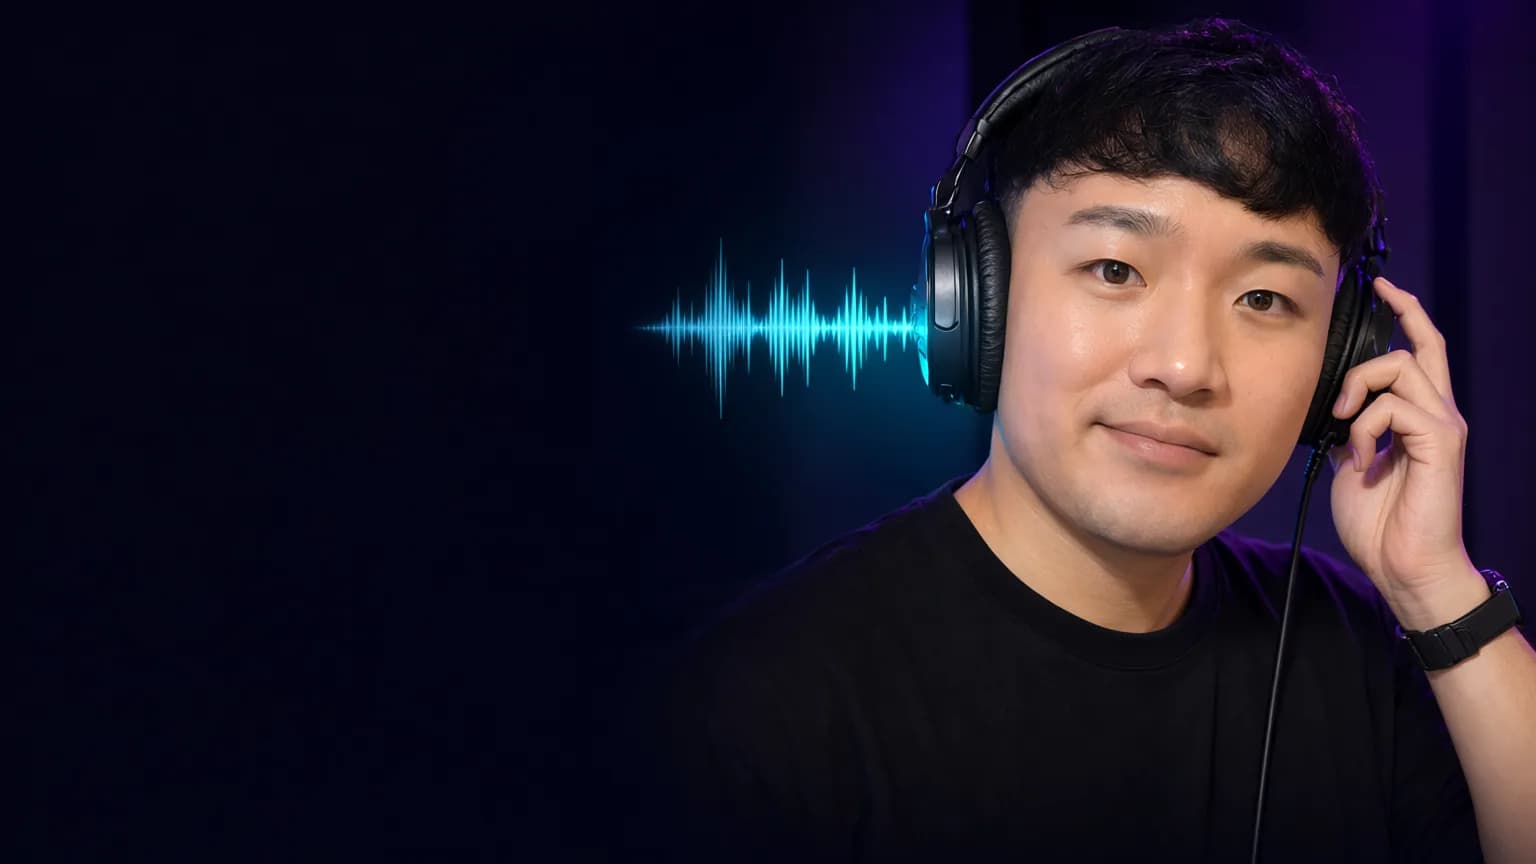
얼굴 특징은 얼추 이어졌지만 셔츠가 맨 아래까지 내려와 하단 여백 조건은 못 지켰습니다. (공식 라이선스도 비상업 목적으로만 쓸 수 있고, 상업 사용은 별도 라이선스를 요청해야 합니다.)
2. InfiniteTalk - 사진 한 장에 23초 발화
아바타는 제가 자동화에서 제일 많이 쓰는 영역입니다. InfiniteTalk는 사진이나 영상에 음성을 넣으면 입 모양을 맞춰 말하는 영상을 만들어줍니다. 입력은 제 캐릭터를 10살 정도 젊게 만든 스튜디오 사진 1장과 23.5초 음성이고, 프롬프트에 "미세한 고개 움직임과 정확한 입 움직임만"이라고 넣었습니다. 이 한 줄이 없을 때 몸짓이 과해졌기 때문입니다.
프롬프트 전체는 다음과 같습니다. 마지막 두 문장("Subtle natural head motion..."과 "No cuts...")이 위에서 말한 한 줄입니다.
The person in the supplied home-studio portrait speaks naturally to the camera. Preserve the exact face, short black hair, black T-shirt, warm desk lamp, purple room light, background layout and centered portrait framing. Subtle natural head motion and accurate mouth movement only. No cuts, captions, added people or objects.
(번역) 제공된 홈 스튜디오 인물 사진 속 사람이 카메라를 보며 자연스럽게 말한다. 얼굴, 짧은 검은 머리, 검은 티셔츠, 따뜻한 책상 조명, 보라색 방 조명, 배경 배치와 중앙 인물 구도를 정확히 유지한다. 미세하고 자연스러운 고개 움직임과 정확한 입 움직임만 표현한다. 장면 전환, 자막, 추가 인물이나 사물을 넣지 않는다.
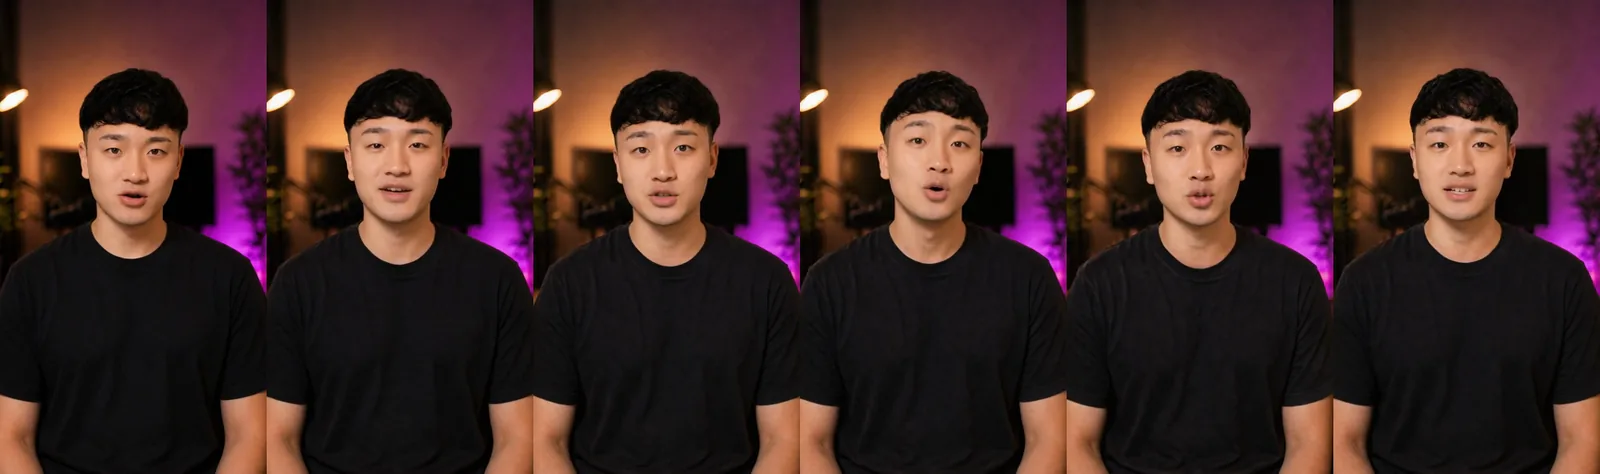
결과 영상에서 시간순으로 뽑은 프레임입니다. 얼굴과 조명, 배경이 끝까지 유지되고 입 모양도 문장마다 다르게 열립니다. 얼굴 없는 채널이라면 충분히 쓸 만한 것 같습니다. (InfiniteTalk는 Apache 2.0 라이선스이고 생성물에 대한 권리를 주장하지 않는다고 적혀 있어서, 네 모델 중 조건이 가장 가볍습니다.)
반대로 제 셀카 영상에 새 음성을 입힌 경우는 뒤로 갈수록 입 모양이 어긋나서 앞부분만 잘라 릴스에 쓰고 있습니다.
영상과 음악 결과
3. MiniMax H3 - 시네마틱은 합격, 모션그래픽은 보류
채널 소개 모션그래픽은 폰트에서 AI 티가 나고 인물도 저와 닮지 않았습니다. 15초 제품 데모는 카드 3장이 순서대로 움직였지만 작은 UI 글자가 흐트러졌습니다. H3가 붙여 주는 내레이션 음성도 저는 끄고 쓸 것 같습니다.
의외로 좋았던 건 글로만 지시한 시네마틱 장면입니다. 공개 프롬프트 모음의 예시를 고쳐 넣었습니다.
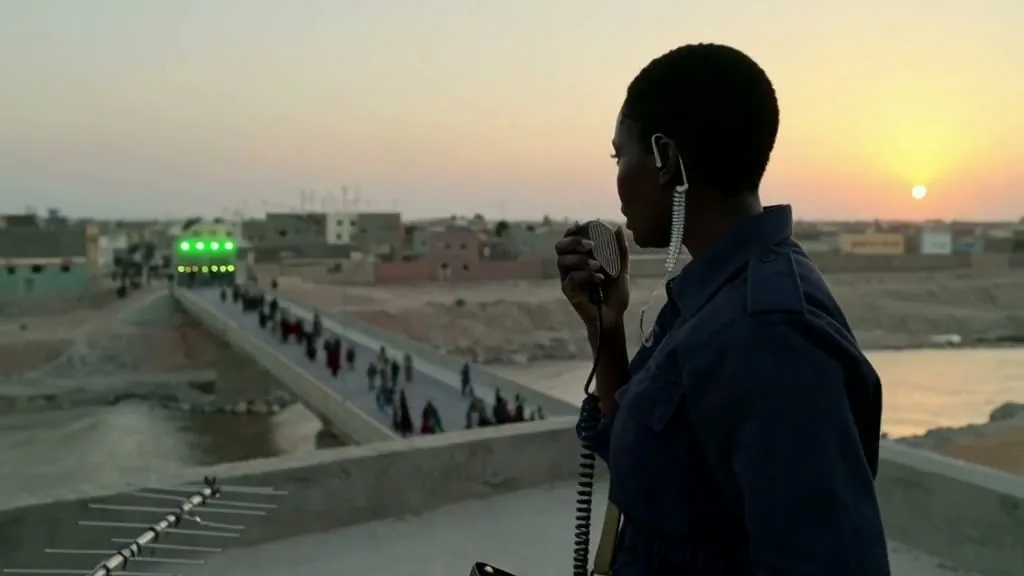
무전으로 다리 위 대피를 지휘하는 장면이고, 영상 속 대사는 다음과 같습니다(자막 기준).
"Emergency channel offline. Channel 7, keep the bridge open."
15초 결과 전체를 움직이는 이미지로 옮겼습니다(원본 1024×576을 640px·초당 8프레임으로 줄였고 소리는 빠졌습니다).
넣은 프롬프트는 길지만 그대로 붙입니다. 샷마다 시작 시각(00:02.000 등)과 카메라 구도, 대사, 소리를 따로 적는 형식이고, 인물·의상·소품을 "장면 내내 같게 유지하라"는 문장을 끝에 다시 넣었습니다. 위 결과에서 샷 순서와 두 대사가 지시한 자리에 들어간 것을 확인할 수 있습니다.
integrated_multimodal_description: [Shot 1] A 15-second 16:9 photoreal, non-graphic evacuation thriller at blue-hour dawn in a fictional Sahelian city. Amina, the same radio operator throughout, has deep-brown skin, closely cropped hair, a navy field jacket, silver earpiece, canvas satchel, heavy boots, and an analogue radio. Inside a dark concrete communications room she grips the radio as red emergency lights pulse and the channel dies. A calm automated voice says <d>[English]Emergency channel offline.</d> Amina immediately turns toward the exit. [Shot 2] At 00:02.000, cut to an oblique rooftop-wide view of a weathered concrete bridge above a dry riverbed; civilians cross toward dense low-rise streets under antennae, while its checkpoint lamp shifts green to red. A distant pressure wave stirs dust without showing anyone harmed. [Shot 3] At 00:04.000, handheld tracking follows Amina's boots through a damaged service corridor. She shoulders open a heavy metal door and runs into the wind. [Shot 4] At 00:06.500, a brief clearly earlier rooftop moment shows her rotating a loose antenna and connecting the analogue radio to backup power; amber dawn first reaches the navy sleeve. [Shot 5] At 00:09.000, a fast but readable montage alternates a frequency dial locking, the antenna turning, the red checkpoint lamp, and Amina speaking into her radio: <d>[English]Channel Seven, keep the bridge open.</d> Civilians are still on the same bridge. [Shot 6] At 00:12.500, sound drops to a clean radio tone. On the rooftop, Amina listens as the checkpoint lamp changes to steady green. The evacuation continues and she exhales against the amber dawn; the camera pushes gently toward her, then cuts to black. Keep her identity, clothing, radio and satchel consistent, the bridge geography fixed, physical wind and dust plausible. Restrained film grain, blue shadow and amber sunrise, no flags, insignia, injury, captions or on-screen text.
overall_soundscape: Radio static and electrical hum yield to wind, boots on concrete, a metal door, antenna creaks and a distant low rumble. The final clear radio tone is followed by a short quiet exhale. Speech occurs only in the two identified lines.
non_diegetic_music: Sparse low suspense pulse builds beneath the quick montage, then cuts out for the restored radio signal.
(번역) integrated_multimodal_description: [Shot 1] 가상의 사헬 지역 도시를 배경으로 푸른 새벽에 펼쳐지는 15초짜리 16:9 실사풍 대피 스릴러. 유혈 장면은 없다. 무전사 아미나는 장면 내내 같은 인물로 유지된다. 짙은 갈색 피부, 짧게 깎은 머리, 남색 야전 재킷, 은색 이어피스, 캔버스 가방, 두꺼운 부츠, 아날로그 무전기를 지녔다. 어두운 콘크리트 통신실에서 아미나가 무전기를 움켜쥐자 붉은 비상등이 맥동하고 통신 채널이 끊긴다. 차분한 자동 안내음이 <d>[영어]비상 채널이 끊겼습니다.</d>라고 말한다. 아미나가 곧바로 출구를 향한다. [Shot 2] 00:02.000에 지붕 높이의 사선 와이드샷으로 전환한다. 메마른 강바닥 위 낡은 콘크리트 다리를 시민들이 건너 낮은 건물과 안테나가 밀집한 거리로 향한다. 검문소 신호등이 녹색에서 빨간색으로 바뀐다. 먼 압력파가 먼지만 일으키고 다친 사람은 보이지 않는다. [Shot 3] 00:04.000에 핸드헬드 카메라가 파손된 서비스 복도에서 달리는 아미나의 부츠를 뒤따른다. 그녀가 무거운 금속 문을 어깨로 밀고 바람 속으로 뛰어나간다. [Shot 4] 00:06.500에 앞선 시간대의 짧은 옥상 장면이 나온다. 아미나가 헐거운 안테나를 돌리고 아날로그 무전기를 예비 전원에 연결한다. 호박색 새벽빛이 남색 소매에 처음 닿는다. [Shot 5] 00:09.000에 빠르지만 알아볼 수 있는 몽타주가 주파수 다이얼의 고정, 돌아가는 안테나, 빨간 검문소 신호등, 무전기에 대고 말하는 아미나를 번갈아 보여준다. 그녀는 <d>[영어]7번 채널, 다리를 계속 열어 두세요.</d>라고 말한다. 시민들은 같은 다리를 계속 건넌다. [Shot 6] 00:12.500에 소리가 맑은 무전 신호음만 남도록 낮아진다. 옥상에서 아미나가 듣는 동안 검문소 신호등이 계속 켜진 녹색으로 바뀐다. 대피가 이어지고 아미나가 호박색 새벽빛 속에서 숨을 내쉰다. 카메라가 그녀에게 천천히 다가간 뒤 검은 화면으로 전환한다. 인물의 얼굴과 의상, 무전기, 가방을 일관되게 유지하고 다리의 지리적 배치와 바람·먼지의 물리를 자연스럽게 표현한다. 절제된 필름 입자, 푸른 그림자와 호박색 일출. 깃발, 휘장, 부상, 자막, 화면 글자는 없다.
overall_soundscape: 무전 잡음과 전기음이 바람, 콘크리트 위 발소리, 금속 문, 안테나의 삐걱거림, 먼 낮은 굉음으로 이어진다. 마지막에는 깨끗한 무전 신호음 뒤에 짧고 조용한 숨소리가 들린다. 말은 식별된 두 문장에만 나온다.
non_diegetic_music: 성긴 저음의 긴장 리듬이 빠른 몽타주 아래에서 커지다가 통신이 복구되는 신호음에 맞춰 멈춘다.
같은 방식으로 만든 나머지 세 편(야간 오토바이 다섯 카메라 구도, 정령 여우의 덩굴 횡단, 사이버 전사 대결)은 각 결과의 5~10초 구간만 이어 붙였습니다.
샷마다 대사와 장면이 프롬프트 순서대로 들어갔고 인물 일관성만 다듬으면 초저예산 단편은 해볼 만하겠다는 생각이 들었습니다. 다만 15초에 18분이 넘으니 후편집은 여전히 사람 몫입니다. 라이선스도 살펴야 하는데, H3 라이선스 안내를 보면 무료 커뮤니티 라이선스는 한국·미국·EU·영국을 적용 대상에서 빼고 있어서 한국에서 쓰려면 별도 상업 라이선스가 필요합니다(작성일 기준). 연속 동작이 많은 액션 장면은 실패가 잦았는데, 모델보다 제 프롬프트 탓에 가깝다고 봅니다.
4. YuE2 - 편곡은 합격, 양자화는 탈락
YuE2는 장르와 가사만 넣는 방식과, 악보(ABC 텍스트 악보)를 같이 넣어 편곡하는 방식을 돌렸습니다. 한국어 발라드는 한글 가사를 그대로 넣었는데 발음이 자연스러웠고 제 귀에는 이 장르에서 Suno와 큰 차이가 없었습니다.
가장 놀란 건 '엘리제를 위하여' 악보를 피아노 UK 드릴로 편곡한 결과입니다. 그런데 같은 곡을 양자화 버전(INT8)으로 돌리자 드릴 느낌이 사라졌습니다. 소리를 글로 옮길 수 없어서 스펙트로그램(시간별로 어떤 높이의 소리가 큰지 색으로 그린 그림)을 나란히 놓았습니다.
악보와 함께 넣은 스타일 지시문입니다. 가사 칸에는 [Instrumental]만 넣었습니다.
Instrumental, no vocals, no singing, piano UK drill, 140 BPM half-time groove, preserve the reference piano melody clearly in a short exposed intro then a strong drill drop, sliding sub 808 bass, syncopated sharp snare, skittering hi-hat rolls and triplets, dark spacious piano, punchy clean low end, clear melodic identity, 40-second compact arrangement.
(번역) 보컬 없는 연주곡, 노래 없음, 피아노 UK 드릴, 140 BPM 하프타임 그루브. 짧게 드러나는 인트로에서 참조 피아노 선율을 또렷하게 들려준 뒤 강한 드릴 드롭으로, 미끄러지는 서브 808 베이스, 엇박의 날카로운 스네어, 잘게 구르는 하이햇 롤과 셋잇단, 어둡고 공간감 있는 피아노, 단단하고 깨끗한 저음, 분명한 선율 정체성, 40초 분량의 압축된 편곡.
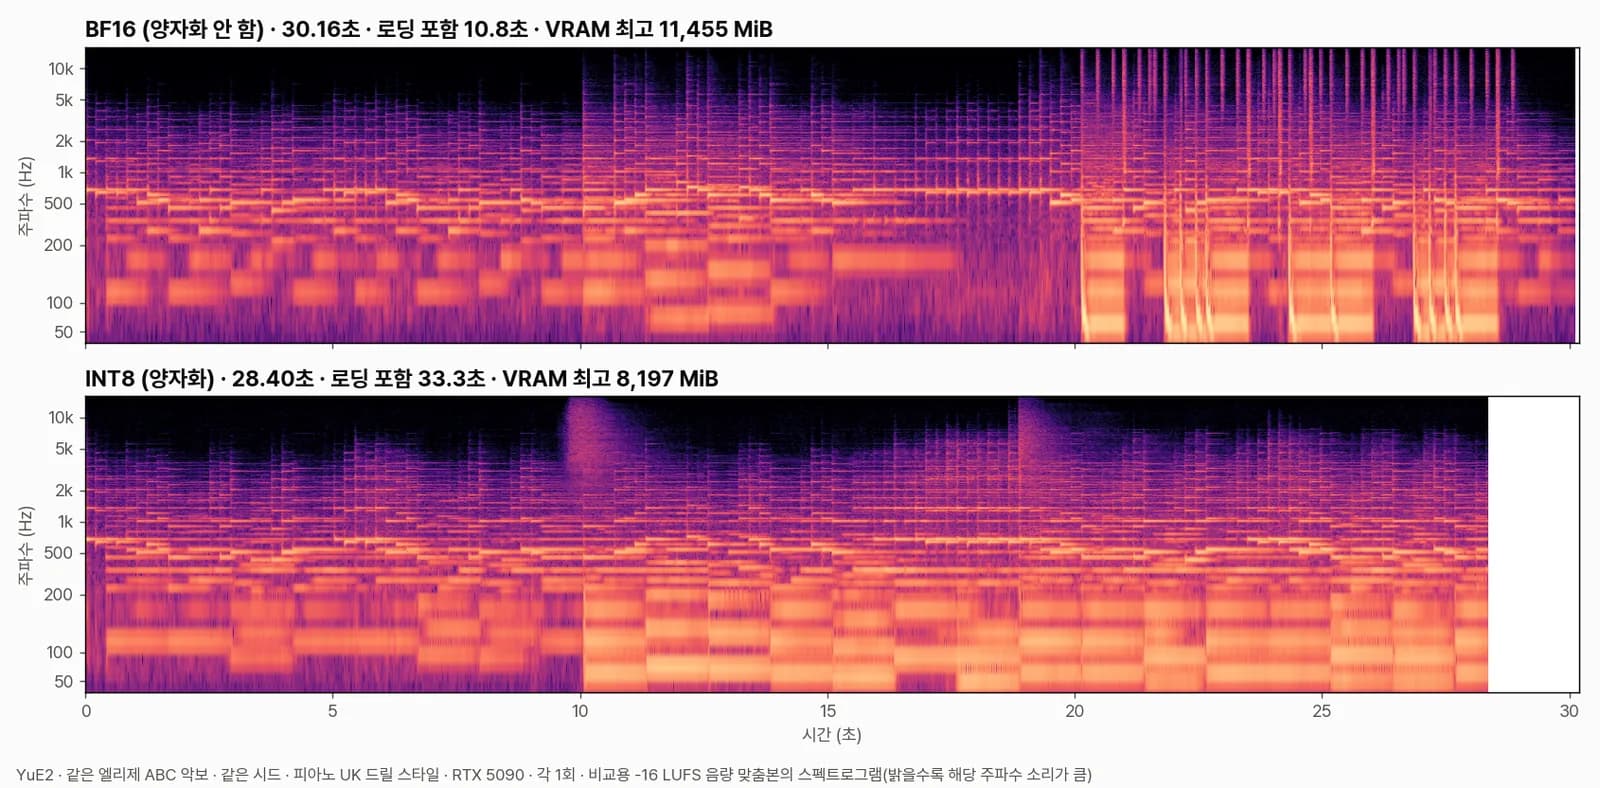
위 BF16(양자화하지 않은 원본)은 20초 이후 세로줄이 규칙적으로 찍힙니다. 드럼과 하이햇이 박자를 쪼개는 자리이고, 맨 아래 50~100Hz 덩어리는 드릴 특유의 묵직한 베이스로 보입니다. 아래 INT8에는 그 세로줄이 거의 없습니다. 빌드업은 좋았는데 드릴이 아니었던 이유가 얼추 보이는 것 같습니다.
| 같은 악보·같은 시드 | BF16 | INT8 |
|---|---|---|
| 로딩 포함 생성 시간 | 10.8초 | 33.3초 |
| VRAM 최고 | 11,455 MiB | 8,197 MiB |
| 결과 길이 | 30.16초 | 28.40초 |
메모리는 약 28% 줄었지만 시간은 3배 걸렸습니다(각 1회). 편곡을 하신다면 양자화 버전은 피하는 편이 나은 것 같습니다. 또 YuE2 모델 카드에는 cc-by-nc-4.0(비상업) 라이선스가 표시되어 있어서 무료는 개인 사용 기준입니다.
3배가 어디서 났는지는 단계별 기록에 있습니다. ComfyUI가 단계마다 남긴 시각으로 나눠 보면 거의 전부가 음악을 만드는 단계에서 늘었습니다.
| 단계 | BF16 | INT8 |
|---|---|---|
| 모델 로딩 | 0.64초 | 0.84초 |
| 음악 생성 (music-generation) | 6.77초 | 26.44초 |
| 샘플링 | 3.00초 | 5.67초 |
| 디코딩·저장·기록 | 0.40초 | 0.36초 |
메모리를 아낀 만큼 음악 생성 단계가 네 배 가까이 느려졌습니다. 양자화된 가중치를 다시 풀어 계산하는 비용으로 보이지만 이 기록만으로 원인을 확정할 수는 없습니다. (같은 체크포인트를 BF16→INT8 순서로 1회씩 돌린 기록이고, 8·12·16GB GPU에서 돌아가는지는 검증하지 않았습니다.)
개인적인 생각 & 한계점
한계부터 적습니다. 수치는 제 PC 한 대의 사례별 1회 측정이고, 합격·탈락은 제 콘텐츠 기준의 육안·청취 판단입니다. 8~16GB 카드에서 되는지는 검증하지 못했고 버전과 라이선스는 작성일(2026-10-01) 기준입니다. (틀린 부분도 있을 수 있습니다.)
네 개를 돌려보며 제일 크게 느낀 건, 에러 없이 끝까지 돌았다고 콘텐츠가 완성된 건 아니라는 점입니다. 하단 여백, 작은 UI 글자, 사라진 드럼은 전부 사람이 눈과 귀로 잡았습니다. 자동화 파이프라인(작업 단계를 이어 붙인 자동 흐름)을 짠다면 생성 다음에 검수 단계를 꼭 두시길 권합니다. 얼굴, 글자, 소리는 아직 사람 몫입니다.
제 합격은 InfiniteTalk와 YuE2 두 개입니다. Qwen Image 2.1은 입소문에 비해 아쉬웠고 H3는 보류입니다.
1. 그래픽카드가 없거나 노트북뿐인 경우 - 로컬은 건너뛰시는 게 낫습니다. 이미지는 ChatGPT나 Nano Banana 같은 유료 모델이 정신 건강에 이롭고 립싱크는 WaveSpeed의 InfiniteTalk API로 소액 충전해 먼저 찍어 먹어볼 수 있습니다. (가격은 작성일 기준으로 다시 확인하셔야 합니다.)
2. 게이밍 PC 정도 장비가 있는 경우 - 음악(YuE2)부터 권합니다. 1분 반이면 곡이 나와서 프롬프트를 고쳐 다시 돌리는 감을 익히기 좋습니다. 단 제 수치는 32GB 카드 기준입니다.
3. 32GB급 장비로 아바타 영상을 반복해서 만드는 경우 - InfiniteTalk를 파이프라인에 넣을 만합니다. 한 편에 20분이니 밤새 돌려두는 묶음 작업으로 설계하는 편이 현실적입니다.
이 글을 마치며 & Reference
같은 장비로 TTS를 비교한 글도 있습니다.
- 한국어 오픈소스 TTS 모델 5종 비교, RTX 5090에서 직접 측정한 속도와 VRAM
- 오픈소스 TTS 보이스클론 5종 비교, 참조 음성 18초 vs 180초를 유사도와 STT로 실측
Reference
- Qwen-Image-2.1 : 공식 저장소. 비상업 조건은 LICENSE에 있습니다.
- InfiniteTalk : 립싱크 모델 공식 저장소. 설치 없이 써보려면 WaveSpeed 페이지가 편합니다.
- awesome-minimax-H3 : H3 모델·ComfyUI 노드·성능 가이드 길잡이. 시네마틱 예시는 awesome-minimax-h3-prompts(CC BY 4.0)의 무전사 대피 장면을 각색했습니다.
- YuE2-3B 모델 카드 : cc-by-nc-4.0 표기가 있는 곳. 공식 데모는 프로젝트 페이지에 있습니다.
- MiniMax H3 공식 블로그 : 제조사 활용 사례. 로컬 품질 보증 자료는 아니라는 점만 감안하시면 됩니다.
긴 글 읽어주셔서 감사합니다 :)
추가 학습 자료 신청
ZEXEA 메인 사이트의 자료 신청 페이지로 이동합니다. 이름·이메일·전화번호 등의 입력이 필요합니다. 블로그 글과 실습 예제는 신청 없이 모두 읽을 수 있습니다.
관련 가이드
한국어 오픈소스 TTS 모델 5종 비교, RTX 5090에서 직접 측정한 속도와 VRAM
한국어 오픈소스 TTS 모델 5종을 같은 대사로 직접 생성해 비교했습니다. RTX 5090에서 측정한 생성 속도와 VRAM, 숫자·터미널 명령어 오독 문제, 장비와 목적에 따른 선택 기준, Apache-2.0과 OpenRAIL-M 라이선스 차이까지 정리했습니다.
전체 과정 보기
오픈소스 TTS 보이스클론 5종 비교, 짧은 참조 18초와 긴 참조 30~180초 실측
오픈소스 TTS 5종에 제 음성 18초와 모델별 30~180초 참조를 넣어 보이스클론 결과를 화자 유사도와 STT 오류율로 실측했습니다. 긴 참조가 항상 낫지 않은 이유, Audio8 60초 실패 원인, 참조 음성 준비 요령까지 정리했습니다.
전체 과정 보기
Higgsfield API로 밈 영상 자동화하기, Genjutsu로 6편 만들어 본 과정과 한 편 비용
Higgsfield API와 Genjutsu로 레퍼런스 밈 영상에 제 사진을 넣어 새 밈을 자동으로 만든 과정을 정리했습니다. API 키 연결, 작업 폴더 구조, 검열 실패 사례, 최종 6편의 실제 비용표까지 담았습니다.
전체 과정 보기