MiroFish 사용법, 출시 전에 AI 가상 고객 반응을 미리 보는 오픈소스를 데모로 뜯어본 기록
MiroFish는 자료를 넣으면 성격이 다른 AI 에이전트 수십~수천 명이 서로 대화하며 반응을 시뮬레이션하는 오픈소스입니다. 공식 데모 5단계를 직접 눌러보며 확인한 숫자와 한계, 내 서비스에 넣을 시드 자료·질문 템플릿을 정리했습니다.
바이브코딩으로 서비스를 하나 만들고 나면 제일 막막한 순간이 출시 버튼 앞입니다. 만드는 건 AI가 많이 도와주는데, "이걸 사람들이 돈 내고 쓸까?"는 여전히 내보내 봐야 압니다. 주변에 물어보면 다들 좋다고 해주고 막상 출시하면 반응이 없는 경우가 흔합니다.
그래서 최근에 쇼츠·릴스로 MiroFish라는 오픈소스를 짧게 소개했습니다. 자료를 넣으면 나이도 성향도 다른 AI 에이전트들이 서로 이야기하면서 반응을 시뮬레이션해 주는 도구입니다. 30초 영상으로는 "이런 게 있다"까지만 말할 수 있어서 이번 글에서는 공식 데모를 처음부터 끝까지 직접 눌러보며 각 단계 화면이 실제로 무엇을 보여주는지, 그리고 내 서비스에 쓰려면 무엇을 준비해야 하는지 정리해 보겠습니다.
먼저 밝혀둘 것이 있습니다. 이번 글은 제 PC에 설치해서 돌린 기록이 아니라 공식 데모 사이트를 조작한 기록입니다. 데모는 개발팀이 미리 돌려둔 결과를 재생하는 페이지라서 제 질문을 넣고 시뮬레이션을 돌리는 건 이번 글 범위 밖입니다. (작성일 2026-10-08 기준입니다. 버전과 화면은 바뀔 수 있습니다.)
사용 도구 및 준비물
MiroFish란?
MiroFish는 중국에서 공개된 오픈소스(저장소 666ghj/MiroFish)로, README의 한 줄 소개는 "단순하고 범용적인 군집 지능 엔진, 무엇이든 예측한다"입니다. GitHub 스타는 작성일 기준 77,018개, 저장소가 만들어진 게 2025년 11월이니 1년이 안 돼서 이 숫자가 나왔습니다. 샨다(Shanda) 그룹의 지원을 받고 있다고 README에 적혀 있습니다.
핵심 개념은 멀티 에이전트 시뮬레이션(multi-agent simulation, 성격과 기억을 가진 AI 여러 명을 한 공간에 풀어놓고 서로 반응하게 하는 방식)입니다. AI 하나에게 "이 가격 어때?"라고 물으면 한 사람의 의견이 나옵니다. MiroFish는 AI를 수십 명 만들어서 SNS 비슷한 공간에 풀어놓고 누가 누구 글에 댓글을 달고 어떤 의견이 퍼지는지를 지켜보게 합니다.
비유하자면 연극 리허설에 가깝습니다. 대본(내가 넣은 자료)과 상황(내 질문)을 주면, 배우(에이전트)들이 각자 맡은 성격대로 움직이고 연출자인 나는 객석에서 흐름을 보다가 중간에 "여기서 경쟁사가 할인을 시작한다"는 소품을 던져 넣을 수 있습니다. README는 이걸 "신의 시점(God's-eye view)에서 변수를 주입한다"고 표현합니다.
로고도 이 개념을 그대로 그린 것 같습니다. 물고기 한 마리가 거울을 보는데 거울 안에는 물고기 떼가 있습니다. 현실의 한 장면을 거울 속 디지털 세계에 비춰서 미리 돌려본다는 뜻으로 읽힙니다.
시뮬레이션 엔진은 CAMEL-AI 팀의 OASIS(Open Agent Social Interaction Simulations)라는 오픈소스 위에 올라가 있습니다. OASIS는 에이전트 100만 명 규모의 SNS 시뮬레이션을 내세우는 프로젝트입니다.
데모 5단계 따라가기
공식 데모 첫 화면입니다. 왼쪽에 5단계 흐름이 있고 오른쪽에 이번 데모에 들어간 입력 두 개가 보입니다.
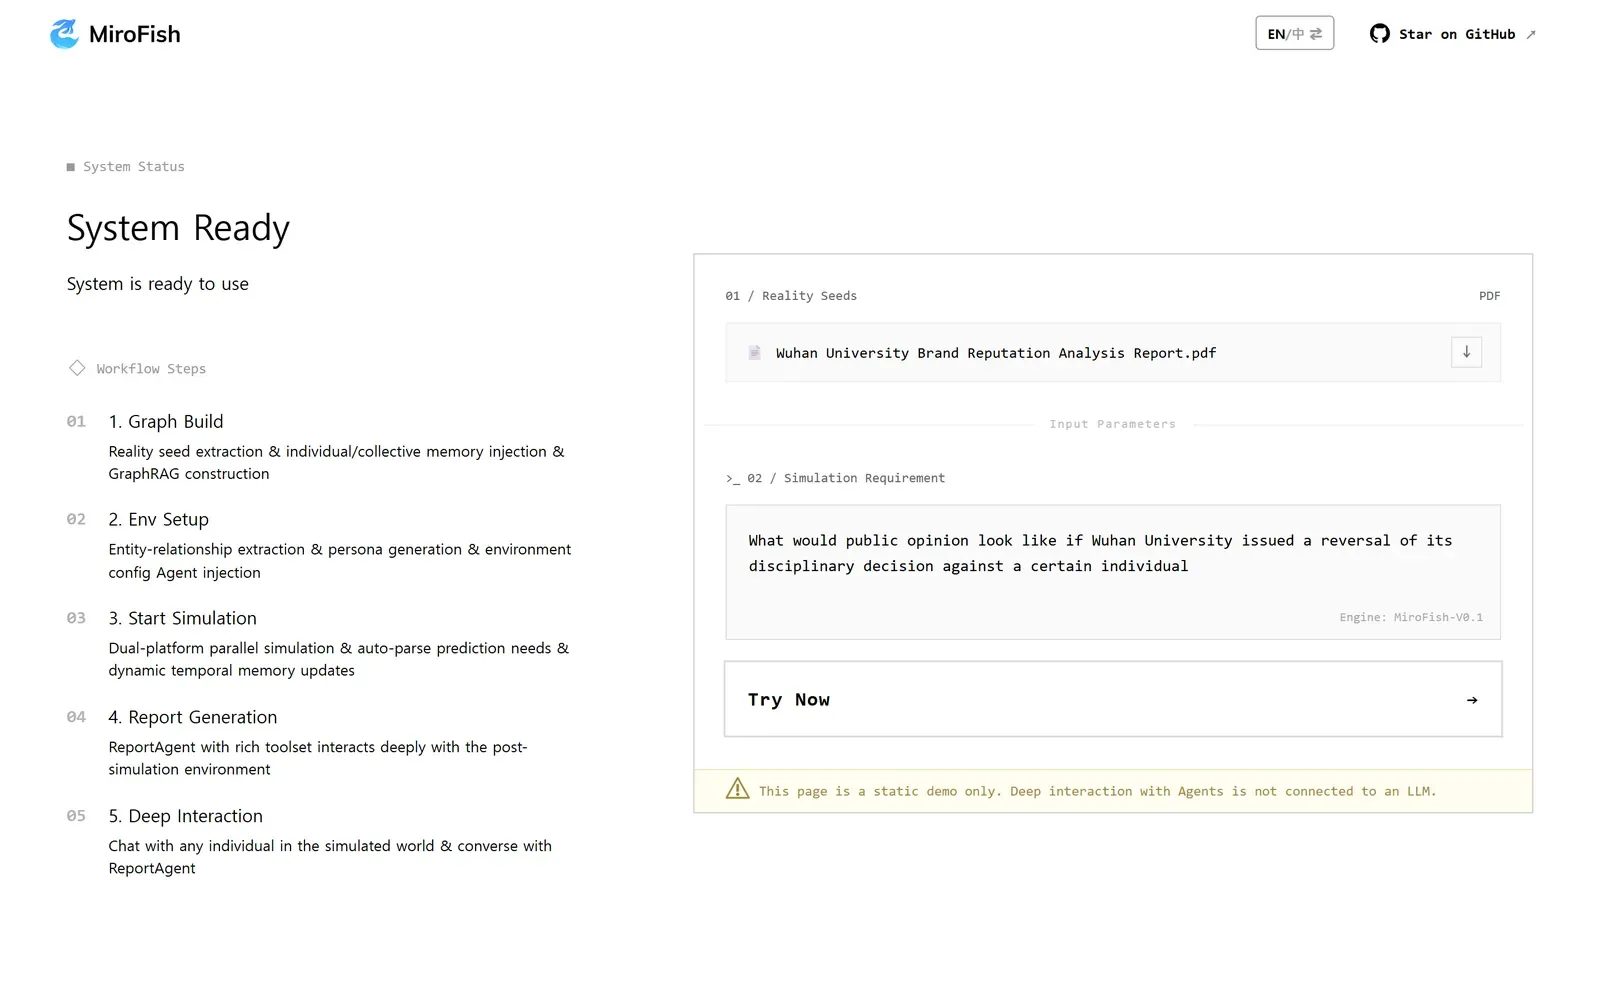
입력은 딱 두 개입니다. 하나는 시드(seed, 시뮬레이션의 출발점이 되는 현실 자료)로, 여기서는 중국 우한대학교의 평판 분석 보고서 PDF가 들어가 있습니다. 다른 하나는 예측하고 싶은 것을 적은 질문 한 문장입니다. 원문은 다음과 같습니다.
What would public opinion look like if Wuhan University issued a reversal of its disciplinary decision against a certain individual
(번역) 우한대학교가 특정 인물에 대한 징계 결정을 번복한다면 여론은 어떻게 흘러갈까
한 대학의 징계 번복이라는 실제 사건을 다룬 시나리오인데, 이 글에서는 사건 자체보다 도구가 이 입력을 어떻게 처리하는지만 보겠습니다. 화면 하단에는 "이 페이지는 정적 데모이며 에이전트와의 대화는 LLM에 연결되어 있지 않다"는 안내가 붙어 있습니다. 이 문장은 뒤에서 직접 확인해 보겠습니다.
1. Graph Build (그래프 구축)
"Try Now"를 누르면 첫 단계가 시작됩니다. LLM이 문서를 읽고 등장하는 대상(대학, 학생, 교수, 언론사, 정부기관 등)과 그 사이의 관계(비판한다, 지지한다, 보도한다 등)를 뽑아서 그래프로 그립니다. 오른쪽 패널에 생성된 대상 유형 9가지와 관계 유형 6가지가 칩으로 나옵니다.
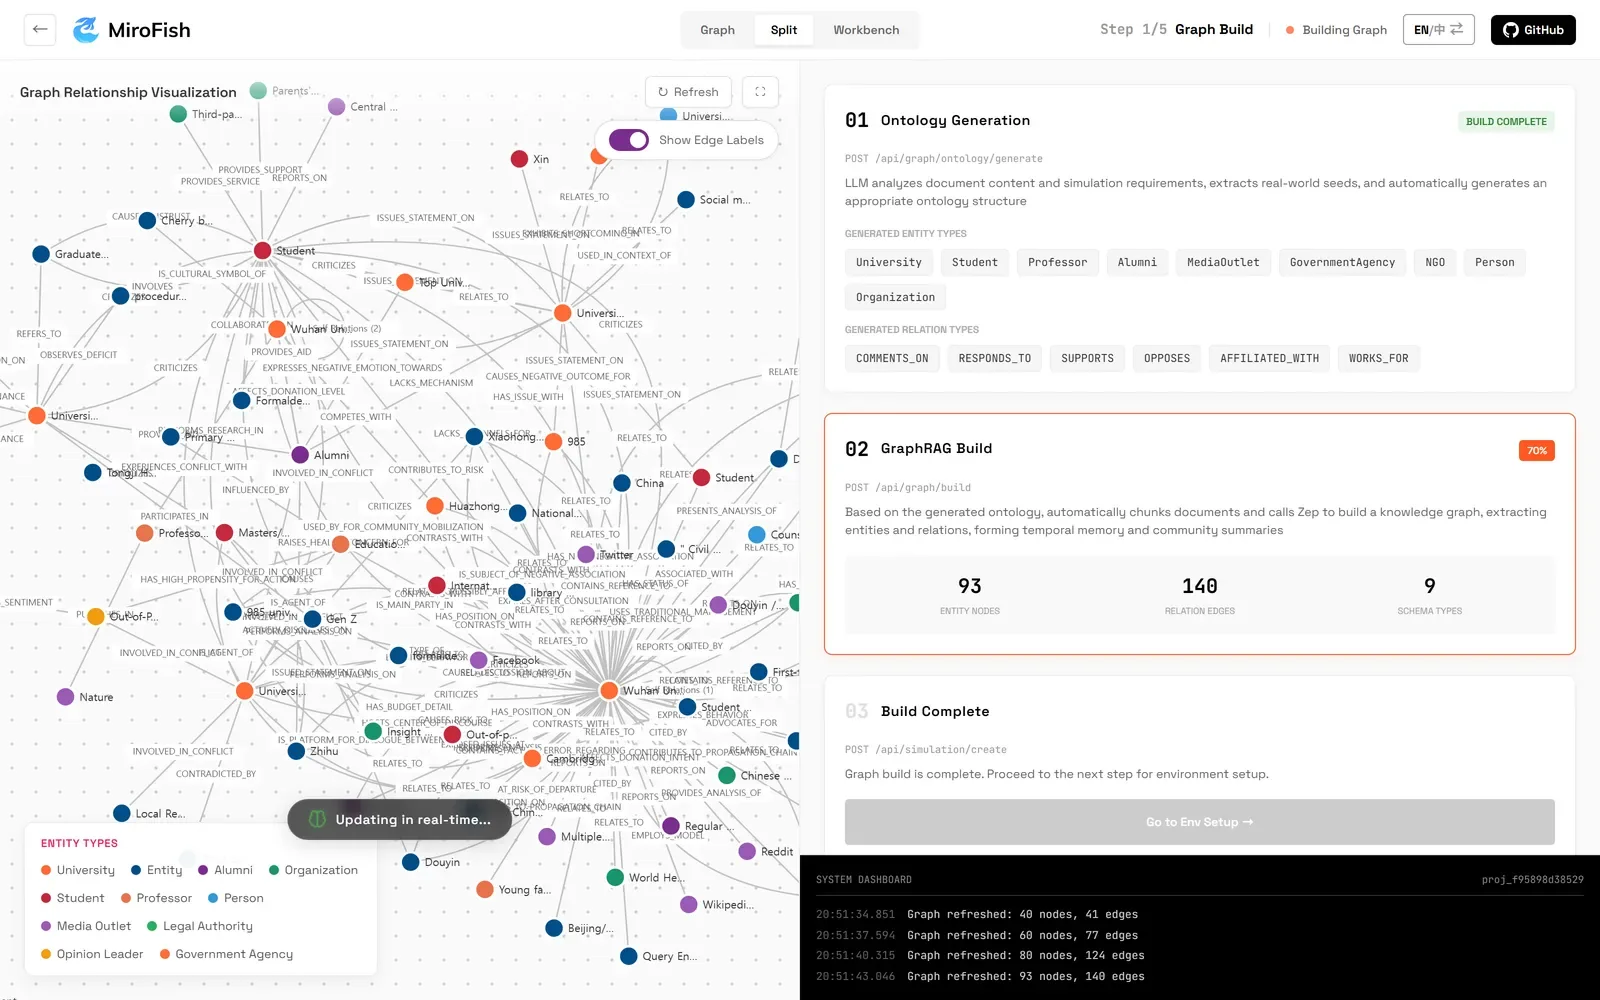
하단 로그를 보면 노드가 40개, 60개, 80개, 93개로 늘어나고 관계선도 41개에서 140개까지 늘어납니다. 이 과정은 움직이는 쪽이 이해가 빨라서 녹화 프레임을 이어 붙였습니다.
여기서 쓰이는 기술이 GraphRAG(그래프 기반 검색 증강, 문서를 "누가 누구와 어떤 관계인지" 지도로 만들어 두고 필요할 때 찾아 쓰는 방식)입니다. 로그에 Zep을 호출해 지식 그래프를 만든다고 나오는데, 이게 뒤에서 말할 Zep Cloud 키가 필요한 이유입니다.
2. Env Setup (에이전트 생성)
그래프의 대상 하나하나가 성격을 가진 에이전트가 됩니다. 데모에서는 에이전트 55명과 관련 토픽 272개가 만들어졌습니다.
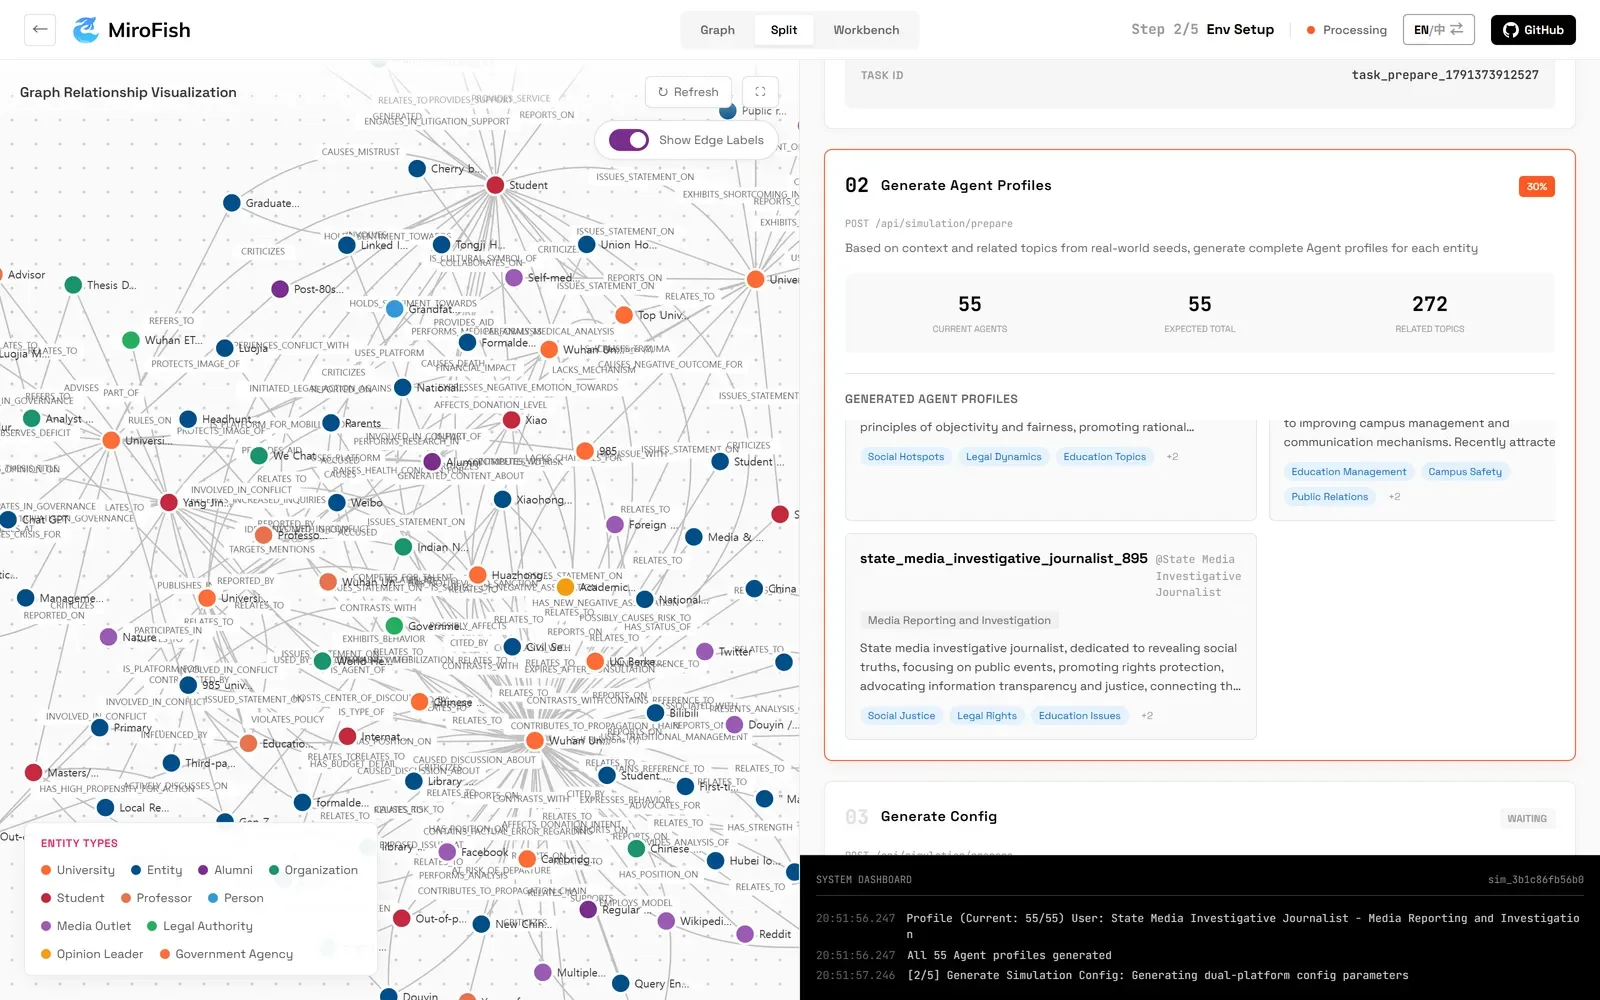
프로필 카드 하나를 읽어보면 "국영 매체 탐사 기자, 사회적 진실을 밝히고 공공 사건에 집중하며 권리 보호와 정보 투명성을 옹호"라는 성격 설명과 사회 정의·법적 권리·교육 이슈 같은 관심사 태그가 붙어 있습니다. 같은 사건을 보더라도 이 기자 에이전트와 학부모 에이전트는 다른 지점에 반응하게 만드는 장치입니다.
3. Simulation (시뮬레이션)
이제 에이전트들이 두 개의 가상 SNS에서 동시에 움직입니다. 데모 화면에는 INFO PLAZA와 TOPIC COMMUNITY라는 두 공간이 있는데, 이름으로 보면 하나는 트위터처럼 짧은 글이 흘러가는 광장, 다른 하나는 레딧처럼 주제별로 토론하는 커뮤니티로 보입니다.
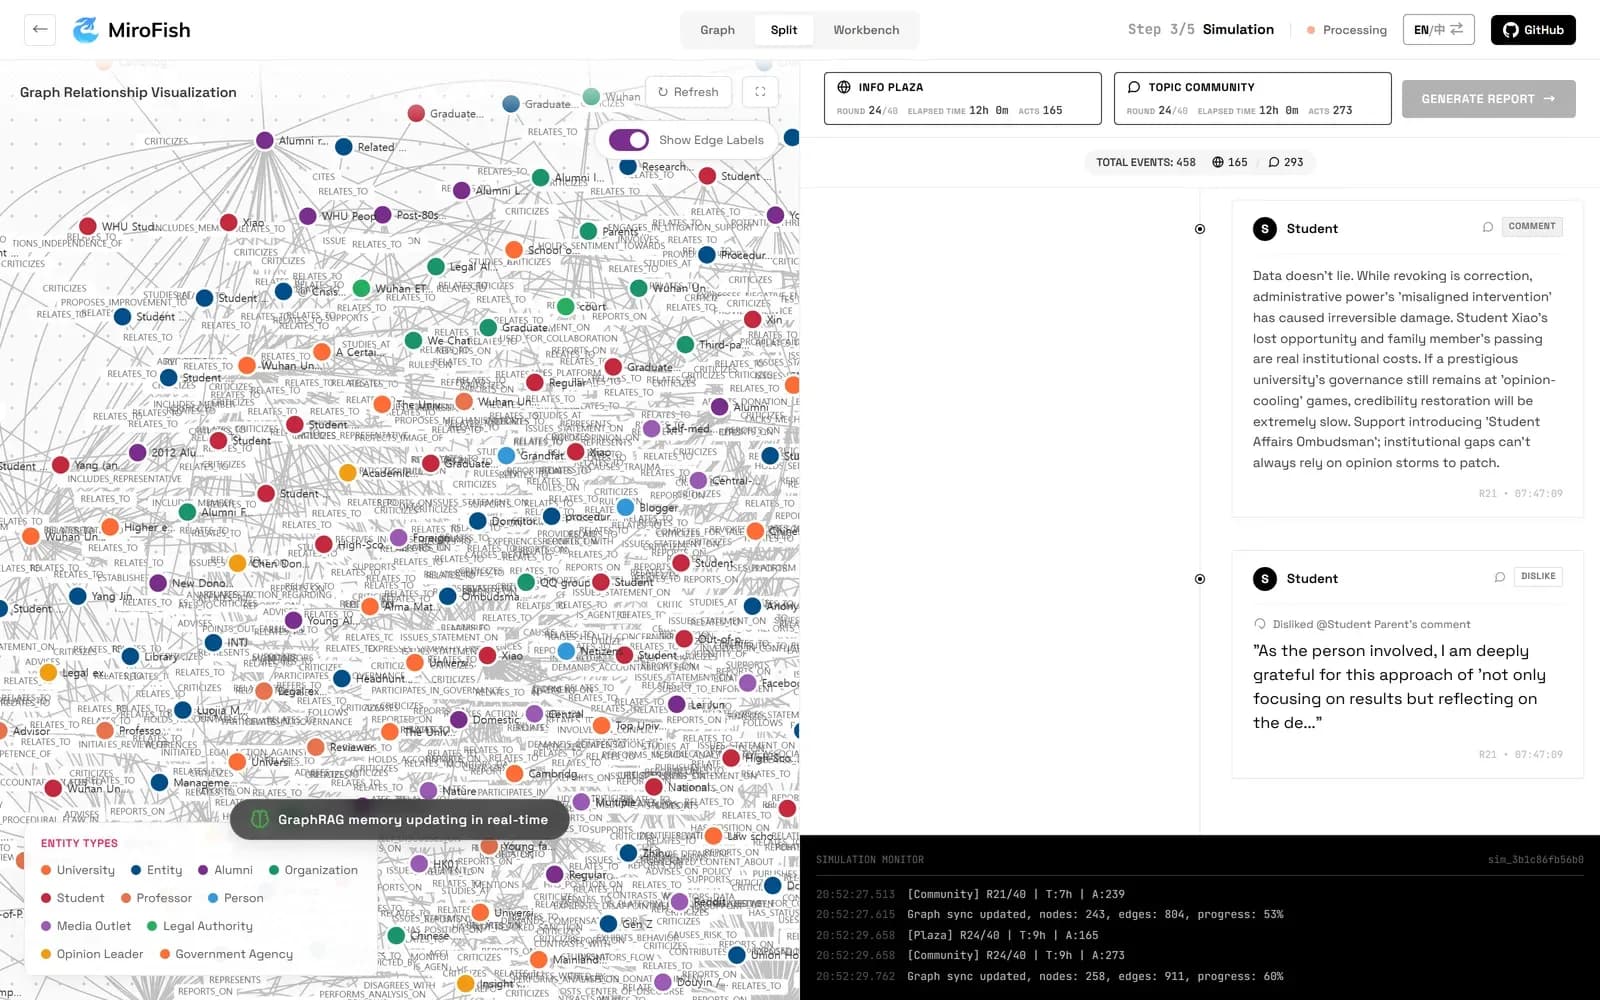
캡처 시점은 40라운드 중 24라운드입니다. 광장에서 행동 165건, 커뮤니티에서 273건, 합쳐서 458건의 이벤트가 쌓였습니다. 오른쪽 피드에는 에이전트가 쓴 글이 그대로 보이는데, 학생 에이전트 하나는 이렇게 씁니다.
Data doesn't lie. While revoking is correction, administrative power's 'misaligned intervention' has caused irreversible damage. (...) Support introducing 'Student Affairs Ombudsman'; institutional gaps can't always rely on opinion storms to patch.
(번역) 데이터는 거짓말을 하지 않습니다. 번복은 바로잡는 일이지만 행정 권력의 '빗나간 개입'은 되돌릴 수 없는 피해를 남겼습니다. (중략) 학생 옴부즈맨 제도 도입을 지지합니다. 제도의 빈틈을 매번 여론 폭풍으로 메울 수는 없습니다.
바로 아래에는 같은 학생 에이전트가 학부모 에이전트의 댓글에 비추천(DISLIKE)을 누른 기록이 있습니다. 글만 쓰는 게 아니라 추천, 비추천, 댓글 같은 SNS 행동을 서로에게 한다는 게 이 단계의 포인트입니다. 그 사이 그래프도 계속 자라서 노드 258개, 관계 911개까지 늘어납니다. 시뮬레이션 안의 사건이 다시 기억으로 쌓이는 구조입니다.
4. Report (리포트)
시뮬레이션이 끝나면 ReportAgent라는 에이전트가 결과를 뒤져서 리포트를 씁니다. 데모 리포트 제목은 "징계 번복 이후 여론의 재분화"이고 소제목 3개로 나뉩니다.
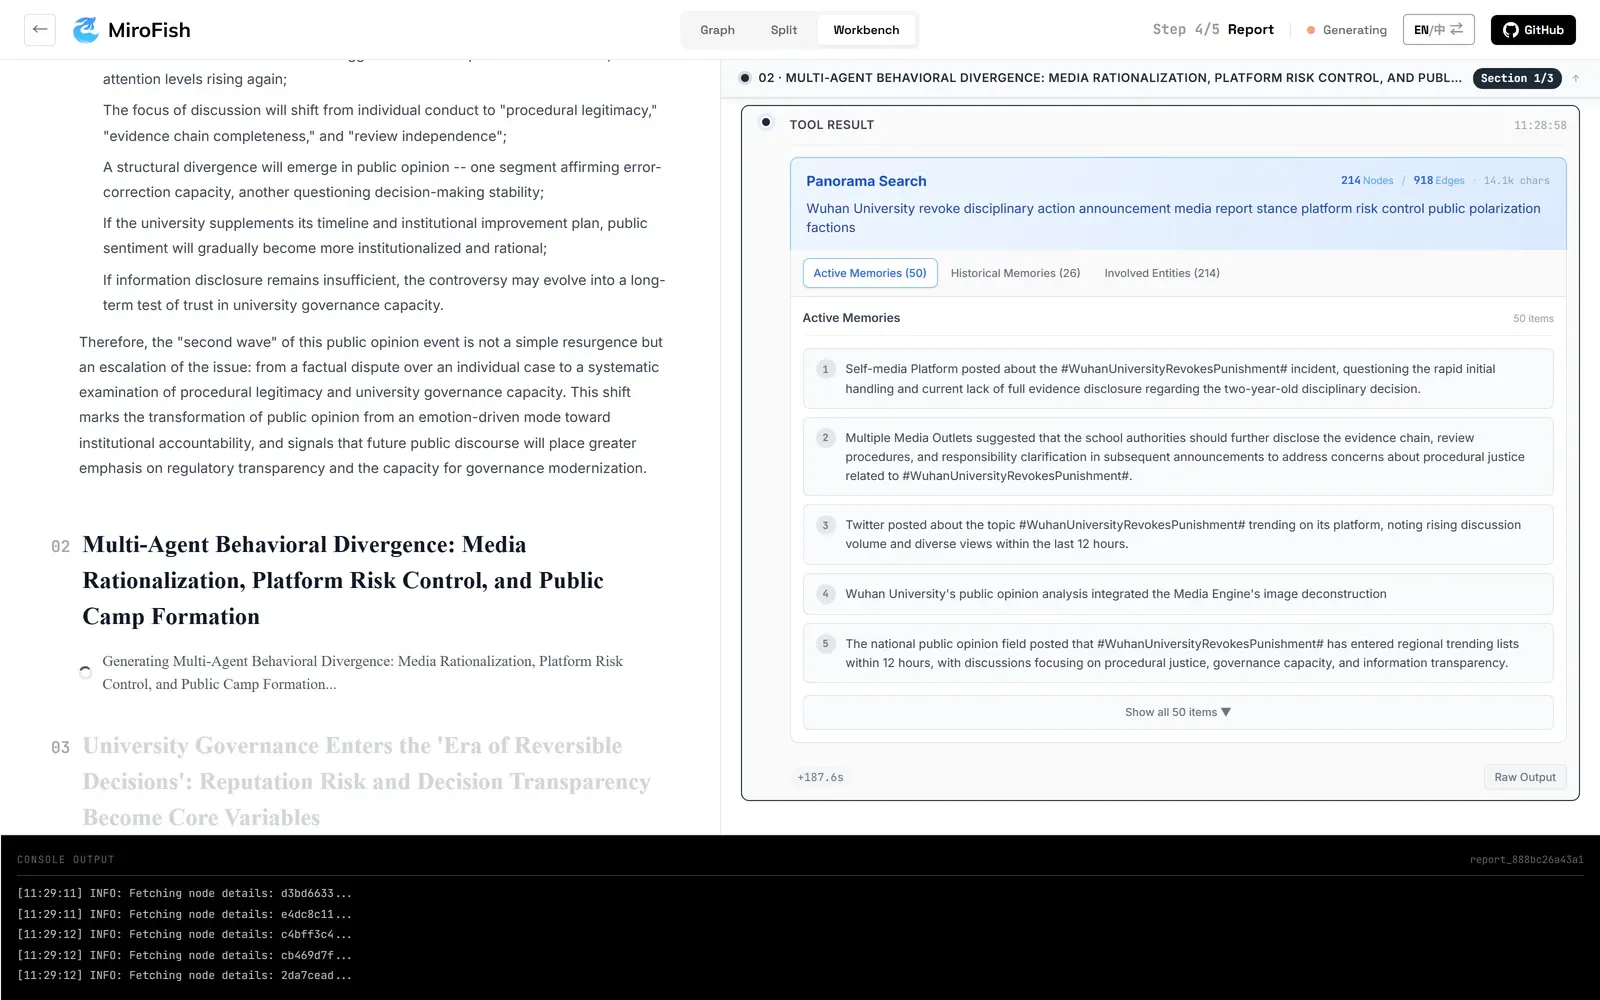
재미있는 건 오른쪽 패널입니다. 리포트 문단 하나를 쓸 때마다 검색 도구를 호출하고 시뮬레이션 중에 쌓인 기억 50건을 근거로 꺼내 옵니다. "어떤 매체가 증거 공개를 요구했다", "트위터에서 해시태그가 12시간 만에 트렌드에 올랐다" 같은 시뮬레이션 속 사건들이 리포트의 인용문이 됩니다. 결론만 던지는 게 아니라 근거를 어디서 가져왔는지 보여주는 방식이라 나름대로 믿고 읽을 구석이 생깁니다.
5. Deep Interaction (대화)
마지막 단계에서는 리포트를 옆에 두고 리포트 에이전트와 대화하거나, 시뮬레이션 속 에이전트 55명 중 아무나 골라 말을 걸 수 있습니다.
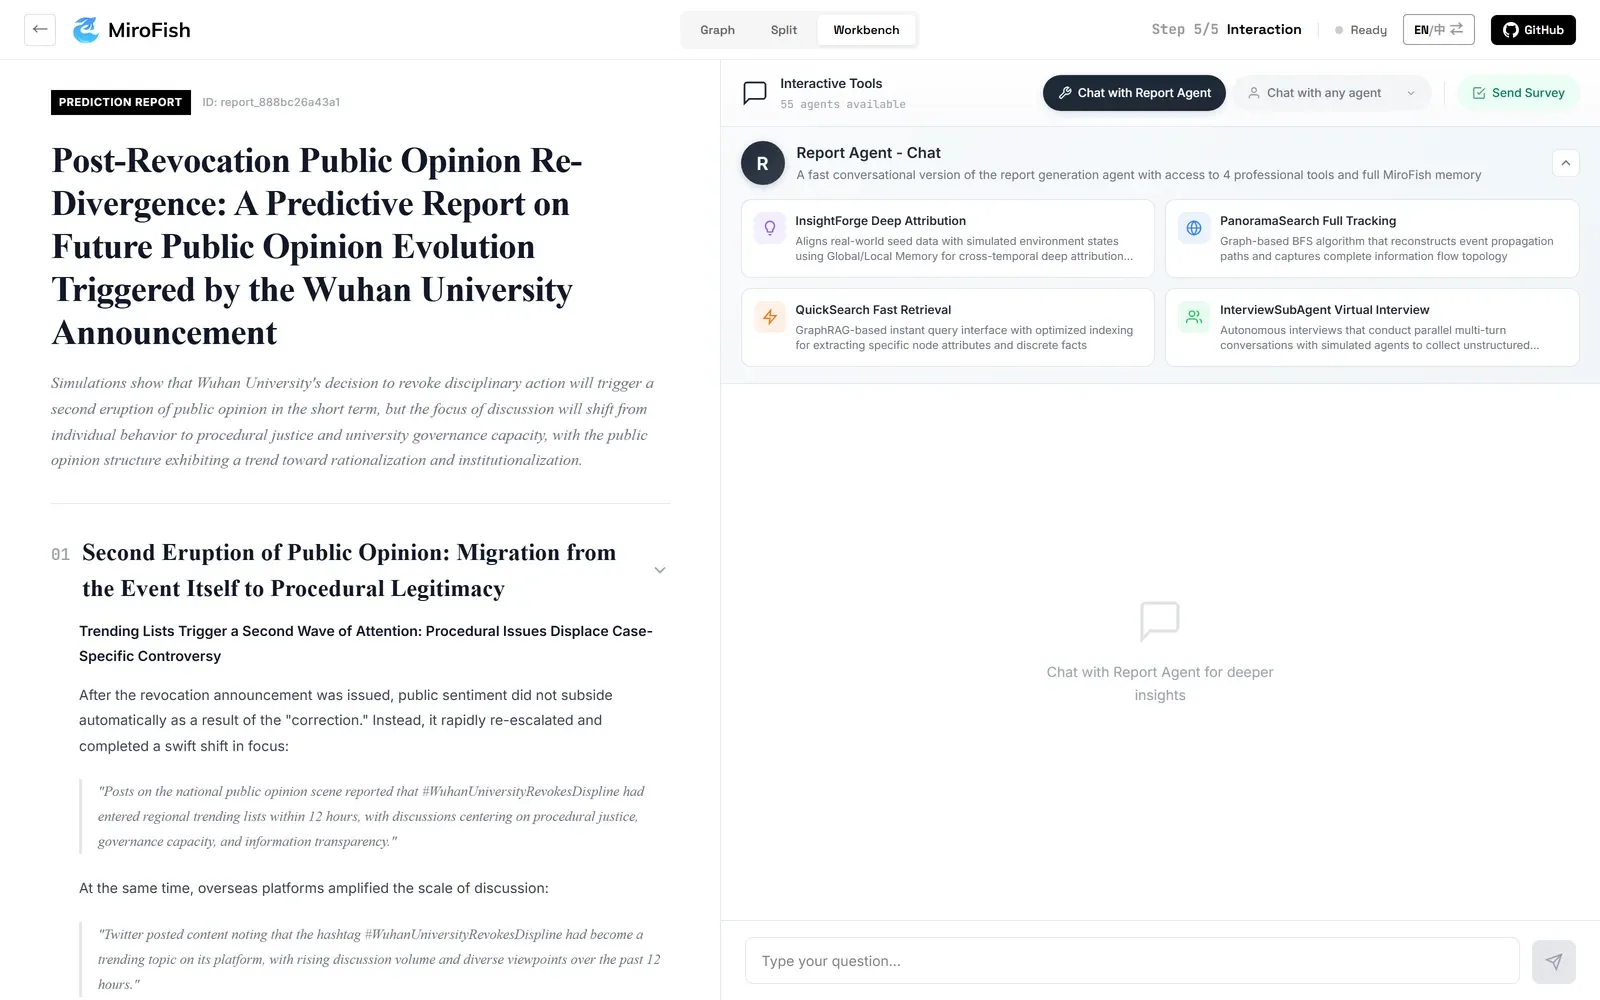
"Chat with any agent"로 특정 에이전트를 골라 "왜 그렇게 생각했어요?"라고 물을 수 있고 "Send Survey"로 여러 에이전트에게 같은 설문을 돌릴 수도 있습니다. 도구 카드 중 InterviewSubAgent는 에이전트 여러 명과 동시에 인터뷰를 진행해서 의견과 심리 상태를 모은다고 설명되어 있습니다. 출시 전 리허설로 쓴다면 저는 이 단계가 제일 쓸모 있을 것 같습니다. 반대한 고객에게 이유를 직접 물어볼 수 있기 때문입니다.
다섯 단계에서 화면에 찍힌 숫자를 한 번에 정리하면 다음과 같습니다.
| 단계 | 하는 일 | 데모에서 본 숫자 |
|---|---|---|
| 1. Graph Build | 문서에서 대상·관계 추출, 지식 그래프 생성 | 노드 93개, 관계 140개, 대상 유형 9개 |
| 2. Env Setup | 대상마다 성격·관심사를 가진 에이전트 생성 | 에이전트 55명, 토픽 272개 |
| 3. Simulation | 두 가상 SNS에서 글·댓글·추천 반복 | 40라운드 중 24라운드에 이벤트 458건 |
| 4. Report | 시뮬레이션 기억을 검색해 예측 리포트 작성 | 소제목 3개, 검색 1회에 기억 50건 인용 |
| 5. Interaction | 리포트 에이전트·개별 에이전트와 대화, 설문 | 대화 가능한 에이전트 55명 |
참고로 데모 녹화에서 첫 화면부터 5단계 진입까지 약 100초가 걸렸는데, 이건 미리 돌려둔 결과를 재생하는 속도입니다. 실제 실행 시간과는 관계가 없습니다.
데모 채팅 테스트
첫 화면의 "LLM에 연결되어 있지 않다"는 안내가 정확히 어떤 뜻인지 궁금해서 리포트 에이전트에게 질문을 두 개 넣어봤습니다. 하나는 데모 사건과 관련된 질문, 하나는 전혀 상관없는 질문입니다.
질문 1: Which group changed its stance the most, and why? (어떤 집단이 입장을 가장 많이 바꿨고, 왜 그랬나요?)
질문 2: Would people pay 4,900 won a month for a diet app? (사람들이 다이어트 앱에 월 4,900원을 낼까요?)
두 질문에 돌아온 답은 질문을 따옴표로 되풀이하는 첫 문장만 다르고 나머지가 글자 하나까지 같았습니다. 두 번째 답의 원문은 다음과 같습니다.
That's a great question. Regarding "Would people pay 4,900 won a m", based on the simulation analysis results, we found that public opinion on social media spreads rapidly with strong emotional drivers. (...) 55 Agents produced 435 actions in a 72-hour simulation, with 240 in World 1 and 195 in World 2.
(번역) 좋은 질문입니다. "Would people pay 4,900 won a m"에 관해 시뮬레이션 분석 결과, 소셜 미디어 여론은 강한 감정을 동력으로 빠르게 퍼진다는 것을 발견했습니다. (중략) 에이전트 55명이 72시간 시뮬레이션에서 435건의 행동을 했고, World 1에서 240건, World 2에서 195건이었습니다.
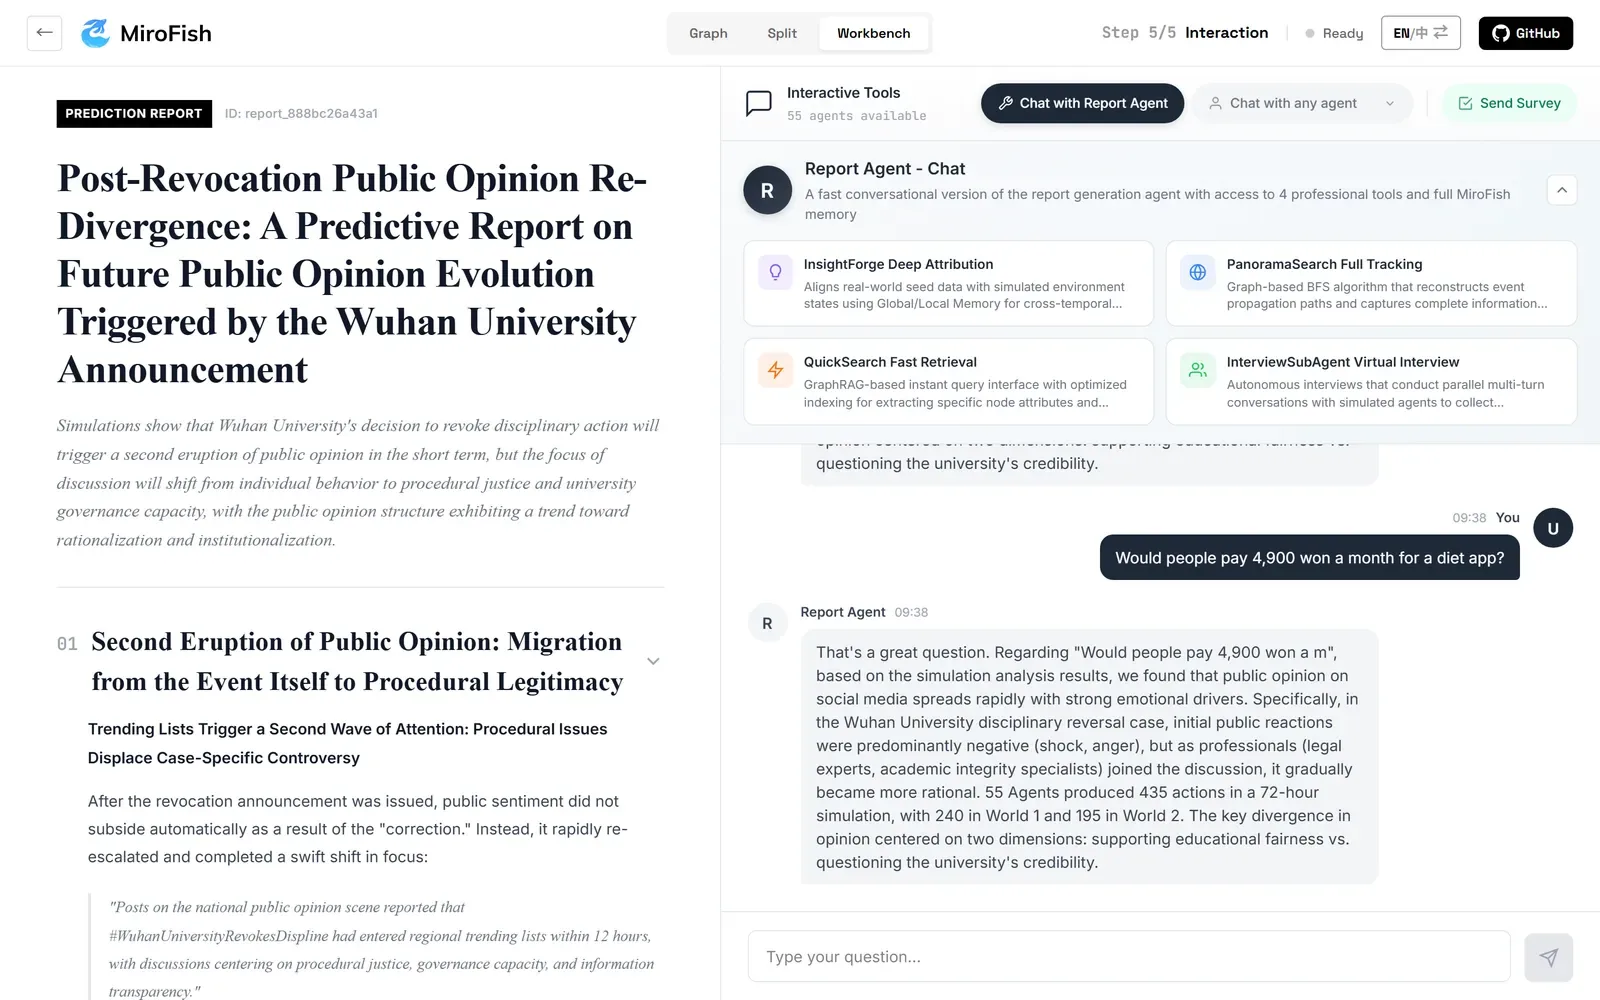
다이어트 앱을 물었는데 우한대학교 이야기가 나옵니다. 질문은 앞 30자에서 잘려서 인용되고, 그 뒤는 미리 써둔 고정 답변입니다. 안내 문구대로 데모의 대화 단계는 화면 구성만 보여주는 껍데기입니다.
하나 더 걸리는 점이 있습니다. 고정 답변은 "72시간 동안 행동 435건"이라고 하는데, 시뮬레이션 화면에서는 24라운드 시점에 이미 이벤트가 458건이었습니다. 데모용 문구와 화면 데이터를 서로 다른 실행에서 가져온 것 같습니다. 데모 숫자는 "이런 규모로 돌아간다" 정도로만 읽고 숫자 하나하나를 근거로 쓰지는 않는 게 좋겠습니다.
내 서비스에 적용한다면
그러면 바이브코딩으로 만든 서비스를 출시 전에 리허설하려면 무엇을 넣어야 할까요? 아래는 데모 입력 구조(시드 자료 + 질문 한 문장)를 그대로 따라서 제가 짜본 설계입니다. 아직 직접 돌려본 결과가 아니라 준비물 목록이라는 점을 감안하고 봐주세요.
릴스에서는 이걸 "끼니로그"라는 가상의 식단 앱으로 보여드렸습니다. 사진 한 장으로 식단을 기록하는 월 4,900원짜리 앱이고 AI 고객 네 명이 각자 판단한 뒤 넘긴 고객에게 이유를 묻는 흐름입니다. 앱 이름, 가격, 인물, 대사 모두 설명을 위해 지어낸 예시입니다.
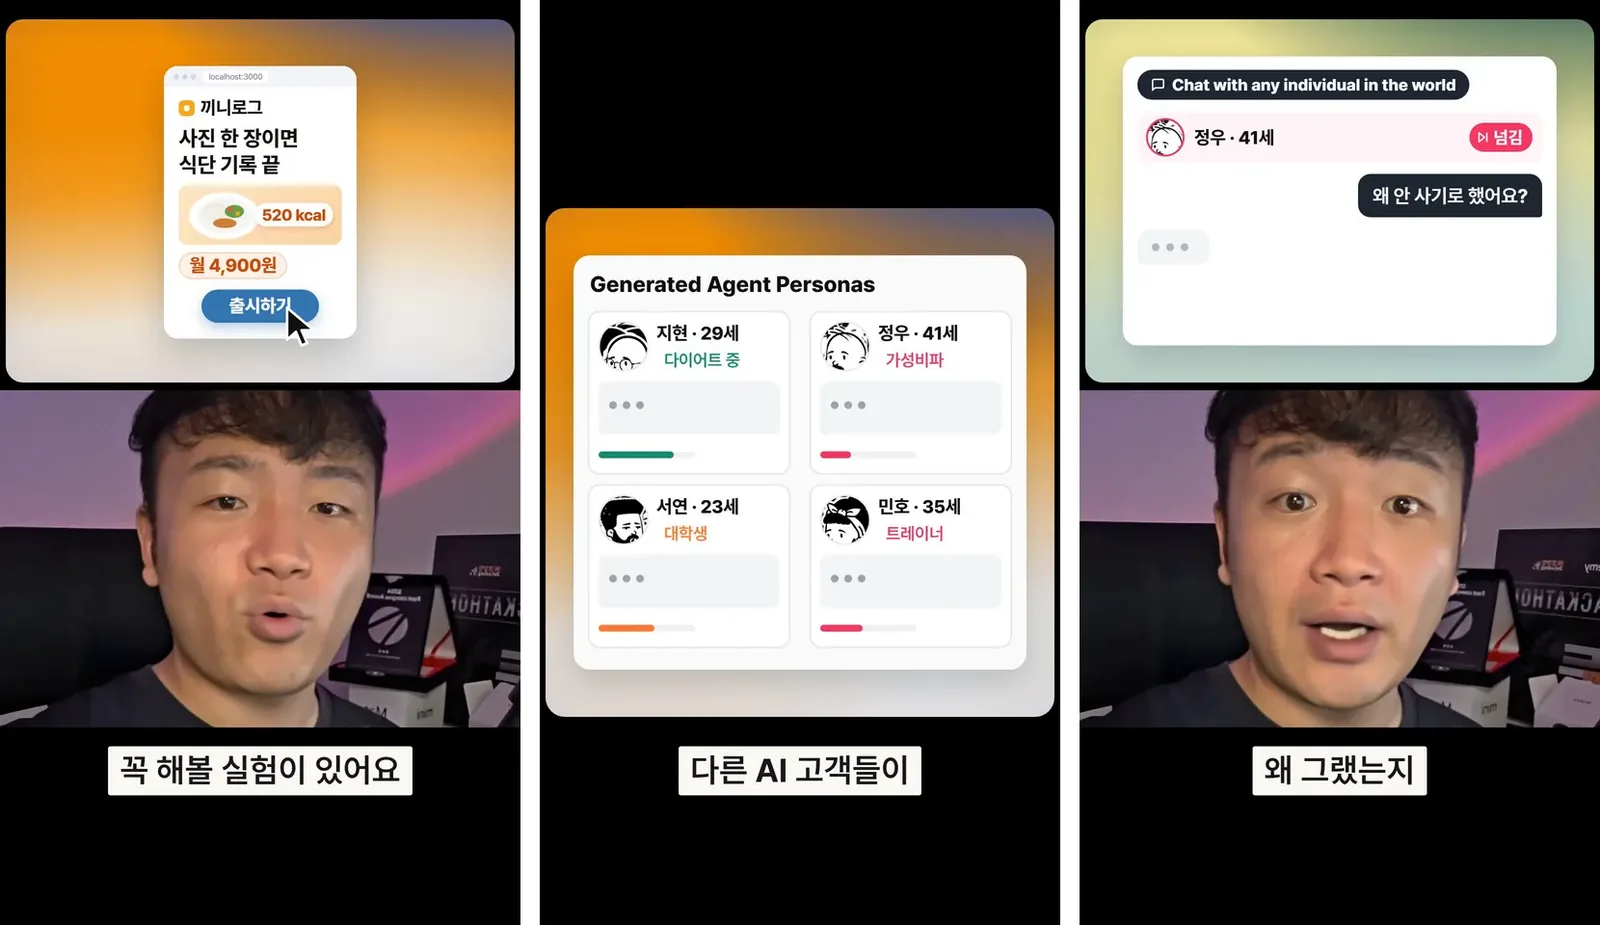
1. 시드 자료 묶기
데모가 PDF 한 개로 시작했으니 내 자료도 PDF나 텍스트 문서 하나로 묶는 게 무난해 보입니다. 넣을 것은 다음과 같습니다.
- 상세페이지 내용: 서비스 한 줄 소개, 핵심 기능, 누구를 위한 것인지. 화면 캡처보다 글로 옮긴 쪽이 대상·관계 추출에 유리할 것 같습니다.
- 가격표: 요금제, 무료 체험 여부, 결제 주기(월간·연간).
- 고객 목소리: 베타 사용자 피드백, 비슷한 서비스의 앱스토어 리뷰, 커뮤니티 글. 대본에서 "리뷰나 커뮤니티 글을 같이 넣을수록 AI 고객이 늘어난다"고 한 이유가 여기 있습니다. 그래프는 문서에 등장하는 대상에서 에이전트를 만들기 때문에, 다이어트하는 직장인, 가성비 따지는 사람, 트레이너 같은 인물 유형이 자료에 많이 나올수록 에이전트 구성이 풍부해집니다. (개인정보는 지우고 넣어야 합니다.)
- 경쟁 서비스 정보: 무료 대안이 무엇인지, 가격이 얼마인지.
2. 질문 한 문장
데모 질문처럼 "어떤 일이 일어나면 반응이 어떻게 될까"의 모양으로 쓰면 됩니다. 판단 기준을 질문 안에 같이 적어두면 리포트가 그 기준으로 나뉩니다.
사진 한 장으로 식단을 기록하는 앱 '끼니로그'가 월 4,900원 정기결제로 출시되면, 20~40대 다이어트 관심층은 결제할지 넘길지 어떻게 나뉠까? 결제를 망설이는 이유와 입소문이 퍼지는 방향을 중심으로 예측해 줘.
(영문) If 'KkiniLog', an app that logs meals from a single photo, launches at a monthly subscription of 4,900 KRW, how would people in their 20s to 40s who care about dieting split between subscribing and passing? Focus on the reasons they hesitate to pay and the direction word of mouth spreads.
데모가 영어 질문을 썼고 README도 중국어·영어 위주라서 영문 버전을 같이 적었습니다. 한국어 입력이 얼마나 잘 처리되는지는 돌려봐야 알 수 있습니다.
3. 중간에 던질 변수
시뮬레이션 도중에 넣어볼 만한 사건입니다. 출시 후에 실제로 겪을 수 있는 일을 미리 넣어보는 용도입니다.
- 가격 인상 공지: 4,900원 → 6,900원
- 경쟁 앱의 첫 달 무료 이벤트
- 인플루언서 한 명의 부정적인 후기
4. 끝나고 물어볼 질문
대화 단계에서 넘긴 에이전트를 골라 물어볼 질문입니다. 실제 고객 인터뷰에서 쓰는 질문과 같은 모양으로 잡았습니다.
- 왜 안 사기로 했어요?
- 얼마면 한 달 써보겠어요?
- 친구에게 이 앱을 한 문장으로 소개한다면 뭐라고 하겠어요?
- 무엇이 바뀌면 마음이 바뀌겠어요?
직접 돌리기 전 확인할 것
데모로는 여기까지가 한계라서, 직접 돌리려는 분을 위해 README 기준 준비물을 정리합니다.
| 항목 | 내용 |
|---|---|
| 실행 환경 | Node.js 18 이상, Python 3.11~3.12, uv(파이썬 패키지 관리 도구). Docker로도 실행 가능 |
| LLM API | OpenAI SDK 형식을 지원하는 아무 LLM. README 권장은 알리바바 Qwen-plus |
| Zep Cloud 키 | 지식 그래프·기억 저장용. README에 "간단한 사용은 무료 월 할당량으로 충분"이라고 적혀 있음 |
| 비용 주의 | README에 "소비량이 크니 처음에는 40라운드 미만으로 시험해 보라"는 경고가 있음 |
| 라이선스 | AGPL-3.0. 수정한 버전을 다른 사람에게 웹 서비스로 제공하면 소스 공개 의무가 생기는 라이선스로 알려져 있음 |
| 버전 | 최신 릴리스 v0.1.2(2026-03-07). 아직 0.x 버전 |
설치 명령은 README에 나온 그대로 세 줄입니다.
cp .env.example .env
npm run setup:all
npm run dev
.env에 LLM API 키와 Zep 키를 넣고 의존성을 한 번에 설치한 뒤, 프론트엔드(localhost:3000)와 백엔드(localhost:5001)를 같이 띄우는 순서입니다. README에는 접속 주소만 적혀 있어서 데모와 똑같은 화면이 나오는지는 설치해 봐야 확인할 수 있습니다.
비용은 감이 잘 안 오실 수 있는데, 데모 규모로 계산하면 에이전트 55명이 40라운드 동안 움직일 때마다 LLM 호출이 일어나고 리포트 단계에서도 문단마다 검색과 호출을 반복합니다. 글 한 편 요약하는 것과는 호출 횟수의 단위가 다르다고 보시면 됩니다. README가 라운드를 줄여서 시작하라고 하는 이유도 이것 같습니다.
개인적인 생각 & 한계점
좋은 도구가 나오면 일단 돌려보고 싶은 게 사람 마음입니다. 자료 몇 개와 질문 한 줄로 가상 고객들이 서로 싸우고 설득하는 장면을 볼 수 있다니 군침이 흐를 수 있습니다. 하지만 이번 글은 데모 기준이라서 화면 구성과 흐름은 확인했지만 결과의 품질은 확인하지 못했습니다. 데모 채팅이 어떤 질문에도 같은 답을 내놓는 걸 보면 더더욱 "직접 돌려보기 전까지는 모른다"가 정직한 결론입니다.
또 하나 경계하는 점은 AI 에이전트가 아무리 많아도 결국 같은 LLM이 연기하는 인물이라는 점입니다. 에이전트 55명의 의견이 갈리는 것처럼 보여도, 실제 사람만큼 다양하게 갈리는지는 별개의 문제입니다. 그래서 저는 MiroFish를 "시장 반응 예측기"보다는 질문 목록을 뽑는 리허설 도구로 보는 편이 맞다고 생각합니다. 가상 고객이 넘긴 이유를 모아서, 실제 고객에게 물어볼 질문을 미리 준비하는 용도입니다.
본인 상황별로 나눠보면 이렇습니다.
1. 아이디어만 있는 경우
아직 상세페이지도 없다면 MiroFish보다 ChatGPT나 Claude에게 "이 아이디어에 반대할 사람 다섯 명을 연기해 줘" 정도로 시작하는 게 훨씬 가볍습니다. 시드로 넣을 자료가 빈약하면 에이전트도 빈약하게 만들어질 것 같습니다.
2. 랜딩페이지와 가격까지 정한 경우
이 글에서 정리한 시드 자료와 질문을 준비해 두고 40라운드 미만으로 작게 한 번 돌려볼 만합니다. 리포트 결론보다 넘긴 에이전트들의 이유 목록을 챙기시면 됩니다.
3. 이미 사용자가 있는 경우
실제 사용자 다섯 명과의 인터뷰가 가상 고객 55명보다 낫습니다. MiroFish는 가격 인상이나 경쟁사 할인처럼 실제로 시험해 보기 부담스러운 사건을 미리 넣어보는 용도로만 쓰는 게 좋겠습니다.
이 글을 마치며 & Reference
이번 글에서는 MiroFish 공식 데모를 5단계 끝까지 눌러보며 화면이 보여주는 것과 데모로는 확인할 수 없는 것을 나눠 보았습니다. 다음 글에는 기회가 되면 로컬 LLM을 붙여서 끼니로그 같은 가상 서비스를 실제로 작게 돌려보고 에이전트들이 정말 서로 다른 이유로 넘기는지 확인한 기록을 다뤄보겠습니다.
오픈소스를 직접 설치해서 돌려본 기록은 OpenMontage 로컬 실행 글도 같이 참고하시면 좋겠습니다.
Reference :
- MiroFish GitHub : 설치 방법과 .env 설정, 비용 경고까지 README에 다 있습니다. 중국어 README가 원본이고 영문판이 같이 있습니다.
- MiroFish 공식 데모 : 설치 없이 5단계 흐름을 눌러볼 수 있습니다. 대화 단계는 고정 답변이라는 점만 알고 보시면 됩니다.
- OASIS (CAMEL-AI) : MiroFish가 쓰는 소셜 시뮬레이션 엔진입니다. 에이전트가 SNS에서 할 수 있는 행동이 어떻게 정의되는지 궁금하다면 여기를 보시면 됩니다.
- Zep : MiroFish가 기억과 지식 그래프 저장에 쓰는 서비스입니다. 키 발급은 여기서 합니다.
긴 글 읽어주셔서 감사합니다 :)
추가 학습 자료 신청
ZEXEA 메인 사이트의 자료 신청 페이지로 이동합니다. 이름·이메일·전화번호 등의 입력이 필요합니다. 블로그 글과 실습 예제는 신청 없이 모두 읽을 수 있습니다.
관련 가이드
OpenMontage 사용법: GPU 없는 노트북으로 AI 영상 만드는 5가지 방법 (+RTX 5090 실행 후기)
코딩 에이전트에게 영상 제작을 맡기는 오픈소스 OpenMontage를 일반 노트북 기준으로 정리했습니다. 설치 순서, 키 없이 되는 것과 안 되는 것, 상황별 추천 경로와 한국어 프롬프트, 그리고 RTX 5090에서 0원으로 31초 영상을 만들어 본 짧은 후기까지 담았습니다.
전체 과정 보기
AI 에이전트 설정을 GitHub에 안전하게 백업하기: Hermes export와 복원 점검
Hermes profile export로 skill과 memory를 내보내고 GitHub private repository에 안전하게 백업하는 절차입니다. fine-grained token 최소 권한, 비밀값 검사, Windows 로컬 예약 내보내기와 수동 검토·원격 반영을 나눠 정리했습니다.
전체 과정 보기
Hermes에 OpenRouter 폴백 연결하기: 대체 모델 설정과 장애 검증 절차
OpenRouter를 Hermes의 장애 대비 후보로 연결하는 방법입니다. 충전·무료 모델의 데이터 정책, turn 단위 폴백 동작, 운영 전 검증 항목까지 정리했습니다.
전체 과정 보기